Gemini 4 Argon深度解析:百万Token输出重塑AI推理范式
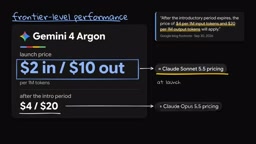
谷歌Gemini 4 Argon以Sonnet定价提供前沿性能,并以100万token输出上限重新定义测试时计算边界。
谷歌新旗舰模型Gemini 4 Argon在多项基准测试中超越GPT-6 Astra与Claude Opus 5.5,同时以极具攻击性的定价策略入场——发布初期价格对齐Claude Sonnet 5.5,此后才上调至Opus级别。模型的核心技术突破在于将单次响应的输出上限从业界主流的12.8万token大幅提升至100万token,为测试时计算(让模型通过更长推理链解决复杂问题的范式)打开了全新空间。谷歌重点布局三大高价值场景:企业知识工作(金融、法律、税务)、长周期软件工程(含内部C/C++到Rust的大规模代码迁移)以及网络安全漏洞防御。目前Argon仅向可信测试者开放,谷歌已将其用于优化自家数据中心基础设施,公开发布预计即将到来。
谷歌推出的新一代旗舰模型Gemini 4并没有延续以往的"Pro"命名,而是以"Argon"(氩气,地球大气中第三丰富的气体)作为代号。据YouTube博主的解析,这款模型在多项核心基准测试中超越了GPT-6 Astra、Opus 5.5等竞品,重新把谷歌拉回到前沿模型的竞争梯队。但真正值得关注的,并不是它刷新的榜单成绩,而是它在单次响应中可生成最多100万token的能力——这几乎重新定义了测试时计算(test-time compute)的边界。
性能与定价:前沿表现,Sonnet的价格
谷歌此前的Pro级模型还停留在Gemini Pro 3.1,距今已有一段时间。这次Argon不仅在性能上回到前沿,更打出了极具攻击性的成本牌。
根据Arena的测试数据,Argon每任务成本比GPT-6.1低约33%,比Claude Opus 5.5低约70%,牢牢占据"性能/成本"曲线的前沿位置。在定价策略上,发布初期价格与Claude Sonnet 5.5持平,意味着用户能以Sonnet的价格获得前沿级性能;在引导期结束后,价格会上调至与Opus 5.5相同的水平。
这种"先低价铺量、后对齐高端"的打法,显示出谷歌在重新抢占开发者和企业用户心智上的决心。
三大主攻方向:知识工作、编程与安全防御
谷歌明确将Argon定位在三个应用场景,每一个都指向高价值的生产力领域。
企业知识工作
Argon在金融、法律、税务等企业知识工作上优势最为明显。它在WALLS指数上排名第一——该指数会根据每类工作对美国经济的贡献度进行加权;同时它在Zapier的自动化基准(Automation Bench)上也位居榜首,这一测试考察模型能否端到端完成真实的业务工作流。知识工作正成为各家前沿实验室集中发力的方向,因为它直接关系到生产力边界的拓展。
WALLS指数(Work Automation for Labor and Legal Services,或类似全称)是一个对不同职业类型的自动化潜力按经济贡献加权后综合评分的基准,旨在衡量AI模型在"对经济影响最大的工作类型"上的表现,而非单纯的学术题目准确率。这与过去常用的MMLU(大规模多任务语言理解)等学术基准有本质不同——后者更关注知识广度,而WALLS更关注在金融分析、法律文件审查、税务合规等高价值白领工作中的实际执行能力。Zapier Automation Bench则从另一维度切入:它测试模型能否在真实的SaaS工具生态中(如Google Workspace、Salesforce、Slack等)端到端地完成一个业务流程,而不只是描述如何完成。两项基准结合起来,反映了谷歌希望Argon在"能创造直接商业价值的场景"中取得领先的战略意图。
长周期软件工程
编程是第二个重点,尤其是长周期(long-horizon)软件工程。谷歌称其在Deep SWE上刷新了业界最高水平(SOTA)。比起榜单数字,几个内部案例更有说服力:成群的Argon智能体正在把谷歌内部的C/C++代码迁移到Rust,其中甚至包括一整个操作系统内核;另一个案例是对一个开源视频解码器已有的Rust移植版本进行加速,并保证输出完全一致。这些都是"谷歌规模"的软件,背后可能服务数十亿用户。
**长周期软件工程(long-horizon software engineering)**与普通代码补全任务的核心区别在于任务跨度。短周期任务通常指补全一个函数、修复单个bug,模型只需要局部上下文;而长周期任务要求模型理解跨越数十甚至数百个文件的系统架构,规划多个相互依赖的子任务,并在执行过程中持续维护对整体目标的追踪。把C/C++代码库迁移到Rust这类工程,需要同时处理语义等价性验证、内存安全改写、跨模块依赖分析等问题,任何一步出错都可能导致整体失败。这也是为什么长周期能力被视为衡量AI智能体(agent)实际工程价值的关键指标,而非仅仅是写出"能运行的代码"。Deep SWE是专门针对此类长周期工程任务设计的基准测试,相比HumanEval等早期代码基准,它更接近真实软件开发的复杂度。
网络安全防御
第三个方向是网络安全。Argon能够发现、验证并修复漏洞,在CWE Bench排行榜上与另外两个模型并列榜首。
百万Token输出:测试时计算的新范式
抛开亮眼的基准成绩,这次发布最具分量的变化在于输出上限。
Gemini系列一直以超长上下文著称——谷歌是第一家为开发者提供100万token上下文窗口的主要实验室,甚至还有过1000万token的研究版本。但在输出端,过去的Gemini被限制在约6.4万token,而当下多数前沿模型的单次响应上限也在12.8万token左右。Argon直接把输出上限拉高到100万token,谷歌称之为"行业领先"。
为什么这件事如此重要?在推理模型时代,测试时计算正成为系统的关键一环。面对越来越难的任务,模型需要花更多时间"思考"。当模型拥有足够的空间在单条推理轨迹中生成数十万token时,就等于为解决难题增加了一个全新的推理深度维度——尤其是配合交错式的函数调用/工具调用时,模型得以在一次任务中啃下极其困难的问题。
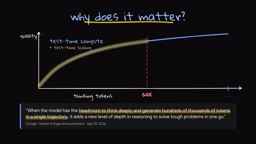
Google DeepMind有一篇相关论文给出了佐证:如果让一个较小的模型花更多时间深度思考、生成数十万token,它可以在"小模型本身就有一定胜算"的问题上,跑赢体量大14倍的模型。这意味着未来推理阶段分配的算力可能会超过训练阶段——测试时计算正在演变为一种全新的范式。当然,这一结论在真实场景中的稳健性仍有待验证。
**测试时计算(test-time compute)**是近两年AI推理领域的核心概念之一,指在模型推理阶段(而非训练阶段)投入更多算力来提升输出质量。传统深度学习的性能提升主要依赖"训练时缩放定律"——用更大的数据集和更多参数训练更强的基础模型。而测试时计算则代表了另一条路径:通过让模型生成更长的思维链(chain-of-thought)、执行多步骤验证或自我反思,在推理阶段动态消耗更多算力来换取更高准确率。OpenAI的o系列模型、Anthropic的扩展思考模式(Extended Thinking)都是这一范式的典型实践。100万token的输出上限,本质上是为这种"深度思考"提供了充裕的空间——模型可以在单次推理中完成多轮工具调用、错误纠正和路径探索,而不必被截断或分拆成多次请求。
尚未开放,但内部已见成效
略显遗憾的是,普通用户目前还无法使用Argon。它正通过谷歌的可信测试者(trusted testers)计划,向部分企业和合作方开放,正式发布预计不会太远。
谷歌透露,内部已经用Argon智能体来优化自家基础设施,在数据中心层面释放了大量内存——这类"自我优化"的应用,往往是模型实用性的最佳信号。发布博客中还提到了更多值得一读的应用案例。
至于"Argon"这个名字——它是地球大气中第三丰富的气体,但谷歌为何选用它作为代号,依然成谜。
竞争格局:前沿重新变得拥挤
无论命名逻辑如何,有一点很清晰:谷歌重回前沿,意味着用户在几周前还相对有限的选择,正在迅速扩充。GPT-6 Astra、Opus 5.5、Sonnet 5.5与Gemini 4 Argon同台竞争,各家都会被迫把能力边界推得更远。
对开发者和消费者而言,这场竞赛的终局或许正如博主所言——智能将变得"便宜到几乎不值一提"。真正的检验,要等到Argon面向公众开放、经受实际任务的打磨之后才能见分晓。
相关推荐

离子推进器:赢得太空竞赛的慢速火箭
离子推进器以极低推力、极高效率成为太空深空探测与货运物流的关键技术。本文解析离子引擎的工作原理、氙气推进剂的选择、太阳能与核电推进的权衡,以及它为何可能成为建造星际文明的"慢速火箭"。

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。