Gemini 4 Argon深度解析:智能、性能与价格三维评测

从智能、性能、价格三维框架解析Gemini 4 Argon(High)的选型逻辑
本文围绕Google新一代大模型Gemini 4 Argon(High),提出并应用「智能-性能-价格」三维评估框架。智能维度关注高配置带来的深度推理能力(通过更高思考预算实现),性能维度聚焦首token延迟与生成吞吐量之间的权衡,价格维度则强调应以「单位任务完成成本」而非单纯token单价衡量经济性。文章指出,High配置适合高难度低频任务,标准版本更适合高频实时场景,大规模批处理则可考虑小模型初筛与大模型精修的组合策略。整体基调认为,技术社区对模型评测的视角正走向成熟,没有普适最优解,只有适配特定业务场景的最佳方案。
近期,关于Google新一代大模型Gemini 4 Argon(High)的性能与定价分析在Hacker News上引发讨论。作为AI模型竞争持续白热化的又一重要节点,Argon版本的三维表现——智能水平、推理性能与价格策略——成为开发者和企业用户关注的焦点。
注:本文基于Hacker News社区讨论(42 points, 20条评论)整理。由于原始素材信息有限,部分性能细节有待官方规格进一步确认。
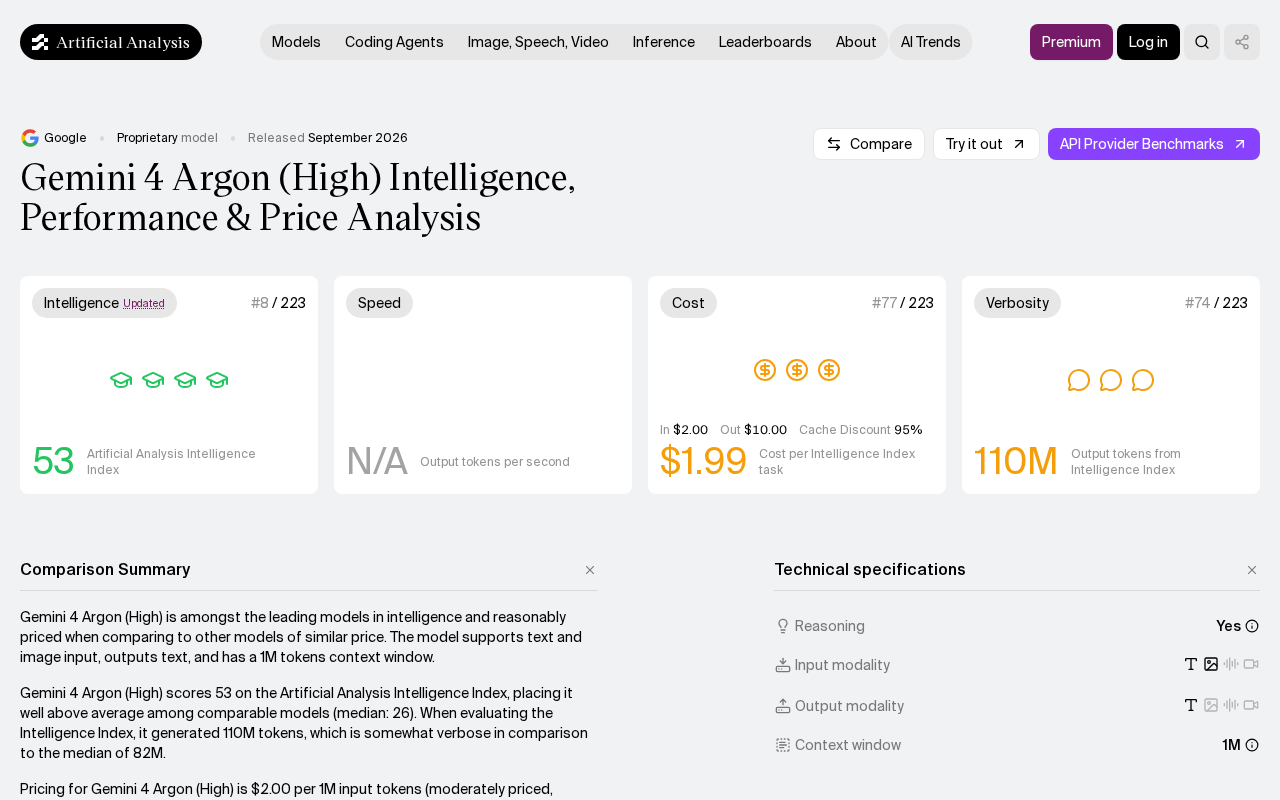
Argon 在 Gemini 产品线中的定位
从命名来看,Argon(氩)延续了Google以元素周期表命名模型变体的思路,而"High"后缀通常代表更高的推理算力配置或思考深度设定。这类分级往往对应不同的响应延迟与成本区间——高配版本在复杂推理任务上表现更强,但代价是更高的token单价与更长的生成时间。
对于评估一款模型,单纯看基准跑分已远远不够。当前行业更倾向于用"智能-性能-价格"三角来综合权衡:一个模型即便智能表现顶尖,若推理速度过慢或价格过高,在实际生产环境中的可用性也会大打折扣。Argon(High)正是被放在这个三维坐标系中接受审视。
智能维度:推理能力的边界在哪里
智能水平衡量的是模型在复杂任务上的实际能力,包括数学推理、代码生成、多步逻辑分析以及长上下文理解等。"High"配置通常意味着模型会分配更多的思考预算(thinking budget),在给出答案前进行更充分的内部推演。
这种设计带来的收益在高难度任务上尤为明显——例如竞赛级数学题、复杂代码重构、多跳推理问答等场景。但对于简单的问答或格式转换任务,高配版本的额外推理开销可能并不划算,反而是标准版本更具性价比。开发者在选型时需要明确自己的任务分布,避免"杀鸡用牛刀"。
"思考预算"(thinking budget)是近年来推理增强型模型的核心机制之一。其基本原理是允许模型在输出最终答案前,先在内部生成一段隐式或显式的推理链(chain-of-thought),这段中间过程通常以额外的token消耗为代价。OpenAI的o系列、Anthropic的Claude扩展思考模式以及Google的Gemini High配置都采用了类似机制。思考预算的"高低"本质上是对这段内部推演所能使用token数量的上限设定——预算越高,模型越有机会进行多步验证、回溯修正和假设检验,在数学证明、复杂规划等任务上的准确率提升显著。但这也意味着每次调用的实际token消耗远高于最终输出所呈现的内容,用户在计费时需特别留意推理token是否单独计价。
性能维度:速度与吞吐的现实考量
性能主要指两个指标:首token延迟(反映响应速度)和生成吞吐量(每秒输出token数)。对于面向终端用户的实时应用,如对话助手、代码补全,低延迟至关重要;而对于批处理任务,总吞吐量和单位成本才是核心。
High配置在追求更强推理的同时,往往会牺牲一定的响应速度。这是所有"深度思考"类模型面临的共同权衡:更长的思考链意味着用户需要等待更久才能看到结果。如何在推理深度与用户体验之间找到平衡,是这类高配模型能否被广泛采用的关键。
首token延迟(Time to First Token,TTFT)与生成吞吐量(tokens/second)是衡量模型推理服务性能的两个正交指标,背后对应不同的工程瓶颈。TTFT主要受prefill阶段的计算量影响——对于启用了长思考链的High配置,prefill阶段还需处理大量内部推理token,因此TTFT通常是普通版本的数倍甚至数十倍。吞吐量则与decode阶段的并行批处理能力、KV-Cache利用率以及硬件带宽密切相关。对于生产环境的技术选型,建议使用P50/P95延迟(而非平均值)来评估实时场景的用户体验,并在负载压测而非单请求场景下测量吞吐量,因为实际并发条件下的性能表现往往与厂商提供的单路数据存在显著差距。
价格维度:成本效益的综合博弈
价格是三维评估中最直接影响落地决策的因素。高配模型由于消耗更多算力,通常按输入/输出token分别计费,且输出token(尤其是推理token)价格显著更高。
对企业用户而言,真正需要计算的是"单位任务完成成本"而非单纯的token单价。一个价格更高但一次就能给出正确答案的模型,可能比便宜却需要多轮重试的模型更经济。这也是为什么越来越多的评测开始引入"性价比曲线",将模型的智能得分与百万token成本绘制在同一张图上,帮助用户直观找到最优解。
当前主流模型API的计费结构通常区分输入token与输出token,部分厂商(如OpenAI对o系列)还会单独列出推理token的计费项。以实际成本规划为例,一个启用深度推理的High配置模型,完成一次复杂代码审查任务实际消耗的总token数(含内部思考链)可能是标准版的5-10倍,即便表面单价接近,总账单也会有数量级的差异。"性价比曲线"(通常以MMLU、MATH、HumanEval等基准得分为纵轴,以每百万token成本为横轴绘制)是目前Artificial Analysis、LMSys等第三方评测平台常用的可视化工具,能够直观呈现帕累托前沿——位于曲线右上角的模型代表在同等成本下智能水平最高,或在同等智能水平下成本最低,是企业选型时的优先考察对象。
社区讨论的启示
Hacker News上围绕这次分析的讨论,反映出技术社区对模型评测方法论日趋成熟的态度——大家不再被单一榜单成绩迷惑,而是更关注真实场景下的综合表现。这种理性的评估视角,对整个AI应用生态的健康发展是积极信号。
需要提醒的是,各家模型厂商的命名和分级策略变化频繁,具体规格与定价应以官方文档为准。本文提供的是评估框架层面的思考,供读者在面对新模型发布时有一套可复用的分析逻辑。
如何为你的场景选择合适的模型
综合三个维度,给出实用的选型建议:
- 高难度、低频次任务(如复杂代码生成、深度研究):优先考虑High配置,智能收益足以覆盖成本
- 高频次、实时性任务(如客服对话、实时补全):优先考虑标准版本,兼顾延迟与成本
- 大规模批处理:重点评估单位任务成本,必要时用小模型做初筛+大模型做精修的组合策略
模型选型本质上是在智能、速度与成本之间寻找适配自身业务的平衡点,没有放之四海皆准的"最优模型",只有最适合特定场景的方案。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。