Gemini 4 Argon深度解析:自测领先,外部验证为何存疑
谷歌发布Gemini 4 Argon,编码基准领先但关键数字来自自测,且普通用户暂时无法使用。
谷歌发布了主打编码能力的Gemini 4 Argon,在其自家图表中Deep SWE得分接近78%,领先GPT-6 Astra和Claude Opus 5.5约4个百分点。然而这一领先数字存在明显水分:Argon的得分为谷歌自测,竞品数据则来自第三方,而在独立运营的DataCurve统一框架排行榜上Argon并未上榜。外部验证结果喜忧参半——VALS Index综合排名第一,但在编码细分项上被Claude Sonnet 5.5险胜。定价方面,发布期与Sonnet 5.5持平,但优惠期结束后将翻倍。最大的现实障碍是可及性:模型目前仅向Fairwind计划合作伙伴开放,普通开发者乃至普通付费订阅用户都暂时无法使用,何时全面开放尚无明确时间表。
谷歌刚刚发布了Gemini 4 Argon,主打卖点是编码能力——其基准得分超过了GPT-6 Astra。但这里有两个关键前提:这些领先数字是谷歌在自家模型上跑出来的,而且该模型目前只面向经过审查的网络防御者开放,普通开发者还用不上。
谷歌是否真的「王者归来」,还是这只是一场自说自话的基准测试?这篇文章拆解了发布数据背后的真实含金量。
谷歌自家图表:领先但幅度有限
Aron的核心卖点是Deep SWE测试。这个测试考察模型在真实开源项目中从零编写长编码任务的能力,由于任务是全新构建的,没有模型提前见过答案,理论上更难作弊。
在谷歌公布的图表中,Argon的Deep SWE得分接近78%,而Claude Opus 5.5和GPT-6 Astra仅略高于74%。这是谷歌自去年11月以来的首个新旗舰模型,而此前5月发布的Pro模型据称从未真正上线。
问题出在数据来源。谷歌方法论PDF明确指出:Argon的Deep SWE结果是自行计算的;GPT-6 Astra的数字来自DataCurve公开排行榜;Claude的数字则来自Anthropic自己的系统卡。换句话说,图表最顶端那根柱子,是谷歌给自己打的分。
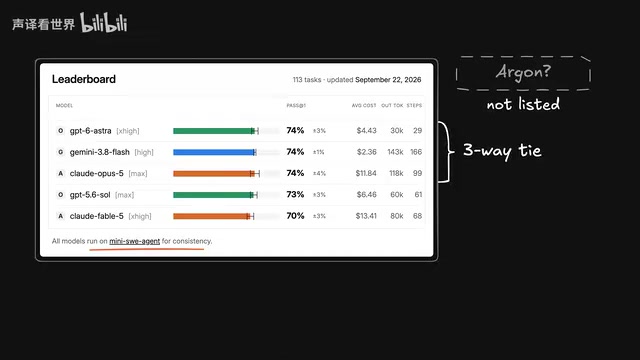
而在DataCurve实际运营的、所有模型在相同智能体设置下运行的排行榜上,Argon并不在列。顶端是三个模型以74%并列第一——其中一个还是谷歌自家的Gemini 3.8 Flash。考虑到该榜单最高分之间差距可达4分,而Argon在谷歌图表中的领先幅度还不到4分,这个「领先」的分量就需要打个问号了。
Deep SWE 是一个专门评估大模型在软件工程任务中实际表现的基准测试,全称为 Deep Software Engineering Benchmark。与传统编程题测试不同,它从真实开源代码仓库中抽取任务——要求模型理解现有代码库结构、编写符合项目规范的新功能或修复真实 Bug,并通过项目原有的测试套件验证。由于任务来源于公开仓库的新提交,理论上可以减少模型通过记忆训练数据「背答案」的概率,被认为比 HumanEval 等合成题库更贴近实际开发场景。不过该基准本身仍处于早期阶段,不同机构在智能体框架(给模型配备的工具调用次数、搜索能力等)上设置各异,导致同一模型在不同机构评测下得分可能相差悬殊,这也是文中强调「谷歌自测」与「DataCurve统一框架下评测」差别的核心原因。
胜负各半:谷歌也列出了输掉的那些行
值得肯定的是,谷歌没有只挑好看的说。在18行数据中,Argon领先12行,但它也如实列出了输掉的部分。
在4个智能体编码测试中,Argon赢了两个,另外两个(Frontier SWE和Terminal Bench)则垫底。这种有赢有输的呈现方式,比全线飘红的宣传图更有可信度。
安全领域是Argon的强项。CWE Bench会给模型一个藏有安全漏洞的代码库,模型必须找到并修补漏洞,同时保证漏洞利用失效、现有测试继续通过。Argon在这里以68%与GPT-6 Astra、Grok 4.7并列第一。这也符合谷歌将其优先面向网络防御者开放的定位。
外部验证:有亮点,也有失守
发布当天,至少有两家外部实验室独立测试了Argon,这是比自测数字更有说服力的证据。
在VALS AI的综合排名VALS Index中,Argon在41个模型里排名第一——这是谷歌最好的消息,且并非谷歌自己的数字。
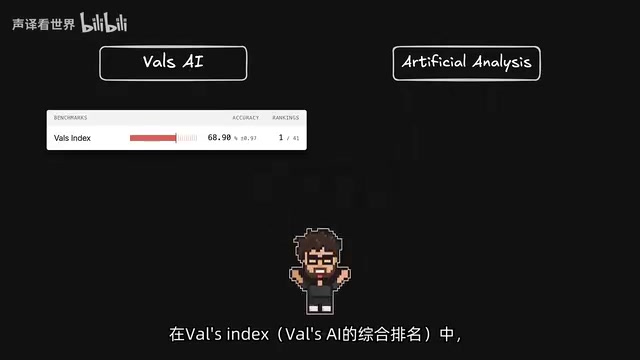
但故事有另一面。Artificial Analysis将Argon在其同价位223个模型的指数中排在第八。而在VALS的编码细分测试里,Argon也没能干净利落取胜:Claude Sonnet 5.5在Vibe Code Bench上以92.4对91.9险胜,在代码迁移任务上同样占优。耐人寻味的是,Sonnet 5.5压根没出现在谷歌的对比表格里。
价格与超长上下文
Argon的发布价为每百万输入令牌2美元、输出10美元。这恰好与Sonnet 5.5持平,且仅为GPT-6 Astra的五分之一。
但要注意「Introductory期」这个措辞——谷歌没有给出期限,而优惠期结束后价格将翻倍至每百万输入4美元、输出20美元,直接对标Claude Opus 5.5的价格水平。
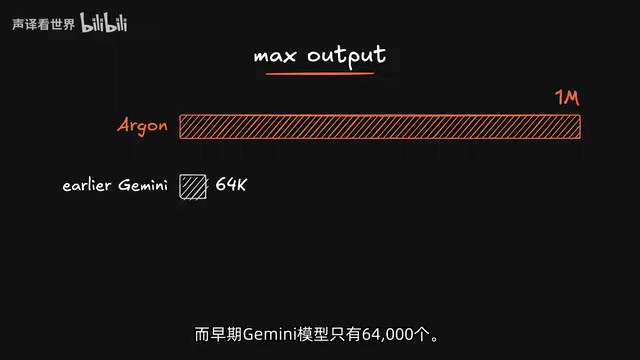
这笔钱买到的核心价值是超长输出。Argon一次可写出多达100万个令牌,而早期Gemini模型只有64000个,Claude Opus和Sonnet也仅为128K级别。不过按发布价格算,一个满额输出的回答成本约为10美元,实际用起来并不便宜。
上下文窗口(Context Window) 指模型在单次对话或任务中能同时处理的最大文本量,单位为 Token(令牌)——大致可理解为英文单词或中文字符的计量单位,1 万个 Token 约对应 7500 个英文单词或 5000 个汉字。100 万 Token 的输出上限意味着模型理论上可以在一次请求内生成相当于数本技术手册的代码或文档。这对于需要跨越整个大型代码库进行重构、生成完整 API 文档或处理超长合同文本的场景具有实际意义。然而上下文越长,推理成本也越高,这正是文中指出「一个满额输出的回答成本约为 10 美元」的原因——按发布定价,100 万输出 Token 恰好等于 10 美元的输出费用,日常使用中极少有任务真正需要触及上限。
普通用户现在用不上
这是最大的现实障碍:Argon目前只面向谷歌Fairwind计划中的部分合作伙伴,包括经过审查的网络防御者、政府、电信公司,以及少数受信任的测试者。
排队等待的还有付费Gemini API客户和Google AI Ultra客户——注意,是Ultra客户,不包括普通订阅者。谷歌给出的开放时间表只有一个模糊的「尽快」。
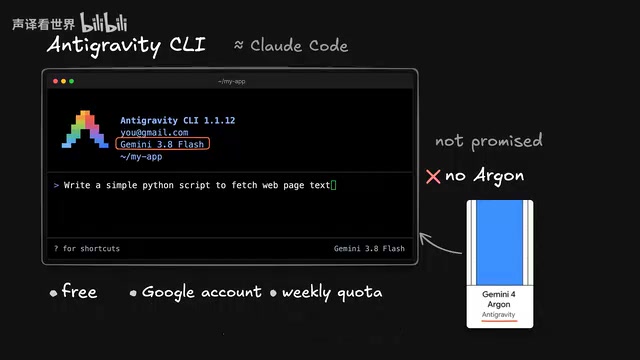
那普通开发者今天能用什么?谷歌对标Claude Code的产品Anti-Gravity CLI可以免费用,配额每周刷新,但它运行的是Gemini 3.8 Flash以及DataCurve榜单上并列第一的模型,Argon不在其中。由于Argon的CWE Bench分数是在Anti-Gravity内跑出来的,它很可能最终会出现在这里,但发布帖并未对此作出承诺。
如果免费配额用完,订阅方案与竞品几乎完全对等:Google AI Pro每月19.99美元对Claude Pro 20美元;Google AI Ultra和Claude Max各有约100美元和约200美元的层级。付费主要买到的是更高的使用限额,所以合理策略是「先免费用,撞墙再付费」。
谷歌 Fairwind 计划(Project Fairwind)是谷歌面向政府机构、关键基础设施运营商及经过安全审查的合作伙伴设立的受控访问项目,其设计逻辑类似于美国政府云服务(GovCloud)的分级接入机制——在模型能力全面公开之前,优先在可信、可溯源的封闭环境中部署,以便监控潜在的滥用风险并收集高质量的安全场景反馈。这种分阶段开放策略在高风险 AI 应用领域并不罕见,但对普通开发者而言意味着即便付费订阅也不一定能第一时间获得访问权限,评估模型真实能力的机会因此受限。
结论:纸面接近,但缺少决定性证据
谷歌回来了吗?纸面上看,它确实很接近——在自家表格18行里领先12行,还登顶了VALS Index。
但真正能一锤定音的,是你在自己仓库上跑出来的那张图表。在那之前,这更像是一场看起来相当不错的「自说自话」。模型未全面开放、关键领先数字来自自测、外部评测互有胜负——这三点叠加,让「王者归来」的结论暂时还下不了。对多数开发者来说,现阶段更务实的做法是关注它何时真正进入可用通道,再用实际项目做出判断。
背景补充
CWE(Common Weakness Enumeration,通用弱点枚举)是由美国国土安全部资助、MITRE 组织维护的软件安全漏洞分类体系,涵盖缓冲区溢出、SQL 注入、路径遍历等数百种常见代码缺陷类型。CWE Bench 正是基于这一体系构建的评测集,要求模型在不借助人工提示的情况下,自动定位并修复真实代码库中属于 CWE 分类的安全漏洞。评判标准兼顾「安全性」与「功能性」两个维度:漏洞利用必须失效,同时原有测试用例不能被修改破坏。这种双重约束使其比单纯的代码补全测试更具挑战性,也更能反映模型在实际安全审计场景中的实用价值——这也解释了为何谷歌选择优先向网络防御者群体开放 Argon。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。