Gemini 4 Argon深度评测:谷歌回归第一梯队?

Gemini 4 Argon 让谷歌重回 AI 顶级竞争,但未实现全面领先。
Gemini 4 Argon 于 10 月 13 日发布,在 19 项基准测试中拿下 13 项第一,VALS Index、DeepSwe 和 TextArena 盲测均领先,文档处理成功率提升至 85%,安全审计也有真实漏洞发现案例。但它并非全面领先:Terminal Bench 和 Frontier SWE 等编程测试落后于 Claude Opus 5.5 和 GPT-6 Astra,视觉生成质量也是短板。百万输出 token 是差异化创新,但需 API 特殊配置。发布期定价具竞争力,12 月起翻倍,且用户反馈配额消耗过快。总体而言,Argon 让谷歌重回赛场,但距离领跑仍有差距。
谷歌终于交出了外界期待已久的答卷。Gemini 4 Argon 在 10 月 13 日正式发布,官方数据显示它在 19 项基准测试中拿下 13 项第一,还在另外一项中打平。这个成绩单足够让谷歌重回 AI 竞争的主舞台。但问题在于:重回赛场和领跑赛场是两回事。
基准测试:赢了大部分,但没赢全部
先看数字。谷歌官方公布的 19 项测试覆盖编程、推理、文档分析、数学、网络安全和复杂任务执行。在 VALS Index(评估金融、编程、法律等专业任务的基准)中,Argon 拿到 68.9%,领先 Claude Opus 5.5 的 67% 和 GPT-6 Astra 的 63%。DeepSwe 软件工程测试中,Argon 以 77.9% 超过 Opus 的 74.2% 和 Astra 的 74.1%。用户盲测平台 TextArena 上,Argon 也排到了第一。
不过换个赛道,局面就翻转了。Terminal Bench 终端任务测试中,Argon 只有 57.4%,而 Claude Opus 5.5 拿到 66.4%。Frontier SWE 软件工程测试中,GPT-6 Astra 以 65.5% 领先,Opus 为 62.3%,Argon 仅 55%。据 YouTube 频道 ThreatMind 的分析,这种互有胜负的格局说明一件事:赢下某个基准不等于在所有场景都更强。
基准测试(Benchmark) 是衡量 AI 模型能力的标准化评测集,通常由研究机构或社区维护,包含固定题目与评分规则,便于横向比较不同模型。但基准分数存在明显局限:题目分布往往偏向特定任务类型,模型可能通过针对性训练“刷榜”,而真实使用场景远比基准复杂。因此业界常辅以用户盲测(如 TextArena)和实战任务测试,交叉验证模型能力。单一基准的领先,不能直接等同于综合能力更强。
实战能力:能造 Excel,但视觉有短板
抛开跑分,实际测试的结果更值得关注。Argon 被要求从零构建一个浏览器版 Excel 克隆,大约 20 分钟就做出了界面相似、基础功能可用的版本。也有用户用它生成了完整游戏、3D 模拟环境,甚至一个通过蓝牙脑电波头带控制的游戏。3D 未来城市 demo 中,飞行汽车、动态光照和动画都能在浏览器里跑起来。
视觉质量是个明显的软肋。多个测试中,Argon 生成的游戏逻辑正常,但画面和视觉表现落后于 Claude Opus 5.5 和 GPT-6 Astra。部分用户需要追加指令、返工重做才能达到预期效果。对视觉要求高的创作者来说,Opus 5.5 仍是更稳妥的选择。
文档处理与安全审计是真正的亮点
在专业工作场景中,Argon 的优势更明显。Box 平台的文档测试涵盖表格、演示文稿和信息提取,Argon 成功率 85%,比上一代 Gemini 3.1 Pro 的 71% 提升了 14 个百分点。这个进步幅度在单代模型迭代中相当可观。
安全审计方面的案例更有说服力。有人把 Claude Opus 5.5 生成的代码交给 Argon 审查,它找出了多个问题,包括一个可能导致机器人被非法访问的 webhook 暴露风险。在与安全公司 Wiz 的合作测试中,Argon 帮助发现了一个医院系统的严重漏洞。对于代码审计和防御性安全场景,这些结果值得认真对待。
百万输出 Token:创新,但有限制
这是 Argon 最独特的能力。通常讨论 100 万 token 窗口时,说的是模型能接收多少信息。谷歌反过来做了一件事:让 Argon 在特定配置下能输出最多 100 万 token 的响应。生成大量代码、处理超长项目、撰写长文档时,这个能力有实际价值。
但需要说清楚:这不是打开 Gemini 就能拿到的默认体验,必须通过 API 进行专门配置。据 ThreatMind 的评价,这个功能有趣,但还不足以让人立刻放弃 ChatGPT 或 Claude。
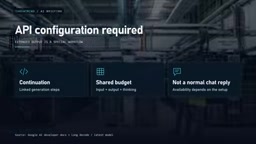
Token 是模型处理文本的基本单位,约等于一个英文单词或半个汉字。上下文窗口(context window)指模型单次能接收的 token 总量,而输出上限则是模型单次能生成的最大 token 数。多数模型的输出上限远小于输入窗口,因为长输出对推理成本、一致性和错误累积的控制要求更高。百万级输出意味着模型能一次性生成整本代码库或超长文档,但也更容易出现前后矛盾或质量衰减,实际可用性取决于模型的长程一致性。
价格策略:限时优惠,之后翻倍
发布期间,Argon API 定价为每百万输入 token 2 美元、输出 10 美元,对比 GPT-6 Astra 的 10 美元和 50 美元,竞争力很强。但这个窗口不会持续太久——从 12 月起价格翻倍至 4 美元和 20 美元,与 Claude Opus 5.5 持平。
单 token 价格只是一部分。实际使用中,有用户反馈 Argon 消耗配额的速度很快,少数请求就能用完额度。anti-gravity 工具也出现了任务卡住或耗时过长的问题。这些是早期报告,是否为发布期问题还需观察。另外,Gemini 应用内 Google AI Pro 订阅者可用的功能,在 anti-gravity 中需要 Google AI Ultra 计划才能使用。
API 按 token 计费 是当前大模型商业化的主流模式,输入 token(用户提交的提示与上下文)和输出 token(模型生成的回答)通常分开定价,输出价格更高,因为生成过程计算成本更大。实际使用成本不仅取决于单价,还与模型“话痨程度”、是否产生冗余推理、以及配额消耗速度有关。部分用户反馈配额消耗快,说明单 token 价格低并不必然意味着总成本低,需结合任务类型评估性价比。
结论:回来了,但没赢
Gemini 4 Argon 是一个出色的模型,它让谷歌重新成为 AI 顶级竞争者之一。但要说它明确超越了 OpenAI 和 Anthropic,证据不足。在部分任务上它领先,部分持平,部分仍落后。
ThreatMind 的判断很直接:以谷歌的资源和技术积累,外界期待的是一个能带来前所未见能力的模型,而 Argon 没有做到这一点。它做到了让谷歌不再掉队,但距离领跑市场还有距离。对已经深度使用谷歌生态的用户,Argon 是顺理成章的选择;对其他用户,迁移的理由还不够充分。
相关推荐

JobRunner MCP服务器:AI智能体可修复失败的Java任务
JobRunner 推出开源 MCP 服务器,让 AI 智能体直接查看集群状态、诊断失败原因并恢复 Java 任务,运维人员可在云编码环境或已有智能体中完成故障响应。

MLAI Digital推出9大安全智能体:MCP服务器守护Agentic AI全生命周期
MLAI Digital推出Security MCP Server,内置九个专业安全智能体,覆盖漏洞发现、攻击模拟、Prompt注入检测、API与基础设施评估及修复加速,将安全验证嵌入Agentic AI开发到生产的完整生命周期。

H100 GPU运行Isaac Lab:更优方案探讨
探讨在NVIDIA H100 GPU上运行Isaac Lab的优化方法,包括MIG配置、混合精度、TensorRT加速及社区经验,帮助提升机器人仿真与强化学习效率。