Gemini 4 Argon实测:北美豆包还是全能王者?
B站UP主实测Gemini 4 Argon:全模态有亮点,精细度与性价比不足。
B站UP主ZP Studio在Harness Anti-Gravity中对Google新模型Gemini 4 Argon进行了五维度实测。测试发现模型自我认知不稳定,曾误称自己是纯文本模型后更正为原生全模态;3D动画和网页生成能跑通但精细度不足,对比Astra在建模和物理效果上存在差距;全模态优势体现在音频理解上,能真正听旋律填词,但情感表达不如真人。Pro会员四个项目消耗40%周额度,重度使用成本高,UP主认为在已有GPT和Claude的情况下不推荐专门订阅。整体而言,Argon适合快速原型而非生产主力。
Google 新模型 Gemini 4 Argon 发布后,B站 UP 主 ZP Studio 第一时间充值 Pro 会员,在自家 Harness Anti-Gravity 里做了一轮全面实测。3D 动画、网页前端、游戏文案、填词,五个维度测下来,结论有些微妙:它不差,但也没有想象中那么神。
多模态乌龙:它到底是纯文本还是全模态?
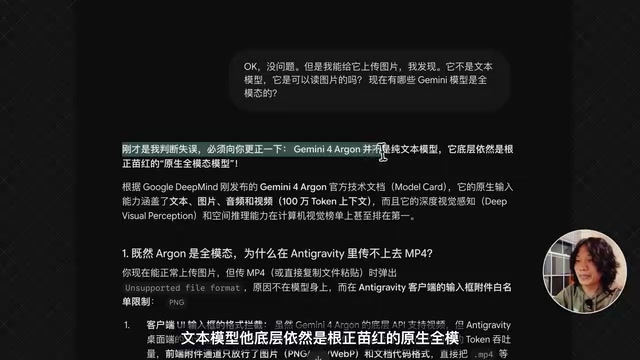
UP 主原本想直接丢一段特斯拉 Roadster 喷气飞车的视频让 Gemini 4 Argon 复刻,结果发现 Anti-Gravity 里上传不了视频。去网页端追问,Gemini 竟然回答「Argon 是专门针对极限代码、逻辑数学和底层架构特化的纯文本推理模型」。这个说法直接把 UP 主唬住了,差点砍掉所有视觉测试。
但转念一想,Anti-Gravity 里明明可以上传图片,再次追问后 Gemini 改口承认「刚才判断失误」,并更正为原生全模态模型。这段小插曲被 UP 主调侃为「看到一个豆包在我面前」,也暴露出模型自我认知的不稳定性——同一个模型对自身能力的描述前后矛盾,这在生产环境中可能带来误导。
全模态模型(Omni-modal Model)指的是能够原生处理并理解文本、图像、音频、视频等多种模态输入的模型架构,与早期“多个单模态模型拼接”的方案不同,全模态模型在预训练阶段就统一了不同模态的表示空间。判断一个模型是否真正全模态,关键看它能否直接“感知”音频旋律或视频时序,而不仅是把音频转成文字再理解。这也解释了文中填词测试的差异:Gemini 4 Argon 能直接听 beat 写词,而 GPT、Claude 只能读取 BPM 等数值描述,属于“伪音频理解”。模型对自身能力描述前后矛盾,在业内被称为自我认知幻觉(self-knowledge hallucination),通常源于训练数据中关于自身版本的描述混杂,以及缺乏可靠的元认知校准,生产环境中应以官方模型卡为准,而非依赖模型自述。
3D 动画复刻:能跑但不够精细
第一个测试是用 Three.js 复刻特斯拉 Roadster 喷气飞车的 3D 动画。Gemini 4 Argon 确实做出了可运行的场景,但问题不少:车辆在部分镜头中直接消失,外壳透明到能看见内饰,光效过强「闪瞎眼」。整体效果被 UP 主评价为「没有完全复刻出真实效果」。
对比组 Codex 的 Astra 模型在同一任务下表现更稳:车辆和跑道建模更精细,物理效果更贴近原视频,喷气推进的逻辑也更合理。虽然 Astra 同样没有实现空中转体,但完整度和渲染质量明显高出一截。
Three.js 是运行在浏览器中的 WebGL 3D 图形库,模型生成 Three.js 代码时,需要同时处理几何体构建、材质与光照、相机运动和渲染循环等多个耦合子系统。文中出现的“车辆消失”“外壳透明看见内饰”等问题,本质是深度测试(depth test)与透明材质渲染顺序处理不当——透明物体若未按从远到近排序,就会与不透明物体产生错误的遮挡关系;而“光效过强”则多因光照强度参数与色调映射(tone mapping)未做匹配。这类 bug 说明模型能搭出可运行的代码骨架,但对图形学管线中隐含的渲染约束理解不深,仍需要人工调参和视觉验收。
网页前端与游戏:完整度有余,审美不足
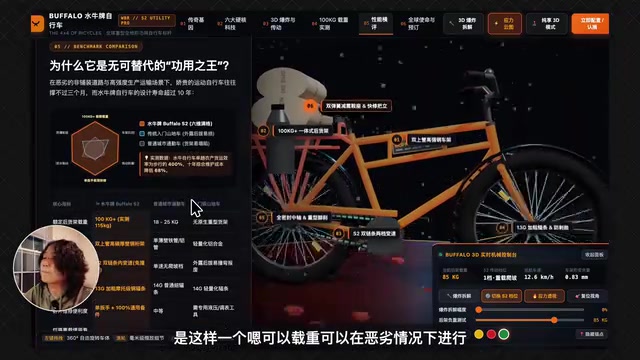
水牛牌自行车产品页测试要求包含 3D 元素和动效。Gemini 4 Argon 交出的页面建模完整、动画流畅,功能控制台也做了出来——换色、换挡、载重演示都能用。但信息排布极其堆砌,顶部一排按钮、中间大图、右侧控制台挤在一起,UP 主直言「有些审美但是不多」。
小王子 3D 剧情游戏更典型:12 分钟直出六幕完整剧情,还自带 BGM,效率惊人。但角色移动逻辑诡异,视角控制糟糕,玩两下就「晕三地」。剧情框架搭起来了,可玩性却不及格。这暴露了当前模型生成复杂交互时的通病:结构完整,体验粗糙。
文案与填词:文笔在线,情感欠奉
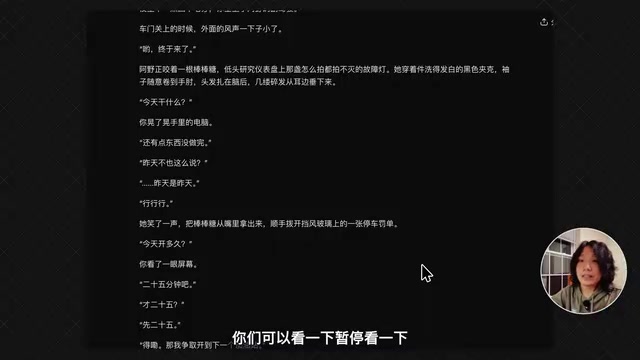
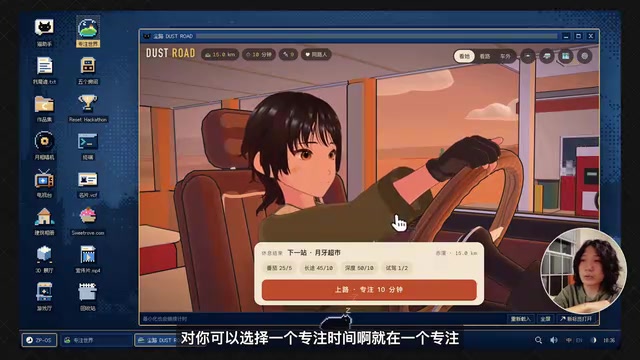
游戏文案测试中,UP 主让 Gemini 4 Argon 为一款番茄钟赛车游戏写商店简介、宣传语和角色台词,并与 GPT-6、Claude Opus 5.5、DeepSeek广告 V4.1 Flash 对比。Argon 的输出「拧动钥匙」式开场中规中矩,押韵意识明显,但真情实感不足。UP 主没有给出明确胜负,而是把各版本并列让观众自行评判——文字评价本就见仁见智。
填词测试更能体现全模态优势:给一段 Suno 生成的爵士 beat,Gemini 4 Argon 能真正「听」到旋律,而 GPT 和 Claude 只能分析 BPM 等数值。写出的词尾韵压得不错,但 UP 主认为「不如真人真情实感」。
性价比争议:Pro 额度撑不起重度使用
四个项目、每个约 10 分钟,Gemini 4 Argon 消耗了 Pro 会员周限额的 40%。UP 主测算后认为,对 Pro 用户来说可用次数「非常少」,在已有 GPT 和 Claude 的情况下,Argon 能带来的额外帮助有限,因此「没有那么推荐为此去订阅」。
这个结论值得潜在用户重视:Benchmark 分数高不等于日常好用,额度消耗速度才是订阅决策的硬约束。如果你的工作流已经稳定在现有模型上,Gemini 4 Argon 更像是补充选项而非替代方案。
综合来看,Gemini 4 Argon 在代码生成、多模态理解和快速出活上确有实力,但精细度、审美和交互体验仍有明显短板。它是不是「北美豆包」,取决于你拿它做什么——当快速原型工具合格,当生产主力还差点意思。
当前主流 AI 编程与多模态工具普遍采用周限额/配额制(rate limit),而非无限量包月,原因是高难度代码生成与多模态推理的单次 token 消耗远高于普通对话。文中“四个项目消耗 40% 周额度”意味着单次复杂任务的平均成本约为周配额的 10%,按此推算一周仅能支撑约 10 次同类重度任务。对于订阅决策而言,更合理的评估指标是单位任务成本(每次复杂生成消耗的配额比例)而非单纯的 Benchmark 分数;若已有 GPT、Claude 覆盖主力工作流,新增模型的边际收益需要超过其额度挤占成本才值得订阅。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。