Gemini 4 Argon实测:北美豆包能否翻身?

Gemini 4 Argon五项测试全过,Agent变稳但前端与创意退步,评价中规中矩。
B站UP主Able在纯净Harness环境下用五个高难度任务实测Gemini 4 Argon:赛车游戏、传送门解谜、GTA克隆、Blender+Godot直升机救援和中文剧情游戏,全部在30分钟至1小时内完成,Agent执行稳定性和后端完成度明显优于前代。但前端设计、人物建模、UI排版和文学叙事均有退步,GTA的NPC AI和直升机游戏的海面质量尤其糟糕。官方Benchmark宣称知识工作全面领先,第三方Artificial Analysis却只给出全球第六。API价格与Opus持平而能力无优势,UP主最终评价为"中规中矩"——可靠但缺乏惊喜。
谷歌的Gemini系列一直有个尴尬的外号——"北美豆包",调侃它背靠谷歌强大的数据和算力,模型表现却总差口气。尤其是代码和Agent任务,经常"流口水"般出错。Gemini 4 Argon被官方称为"时隔很久追上前沿旗舰"的翻身之作,B站UP主Able用五个高难度测试对它进行了全面检验:它真的翻身了吗?
测试设置:极简环境下的真实能力
为了公平,UP主搭建了纯净的Deep-Seek Harness环境,不提供任何skills、MCP或第三方工具,只给模型最基础的读写和Agent工具,所有素材(包括建模、美术)都要求模型自己生成。这比上一期测试本地模型Qwen 3.8时更苛刻——那次还给了音频和建模参考,而Gemini 4 Argon作为前沿模型,没有这种优待。
测试连接中出现了一些技术问题:Gemini 4 Argon会"雷霆大思考",单文件输出过长导致超时,调整配置缩短回复后才成功。但配置正确后,第一个任务仅用30分钟完成,远快于本地模型。
Harness(评测框架) 是让语言模型在受控环境中执行复杂任务的软件基础设施。它通常负责任务分发、工具调用封装、文件读写、多轮对话状态管理和结果回收,相当于模型的"操作系统外壳"。业界常见的 Harness 包括 SWE-bench 的官方 runner、OpenHands、Aider 等。文章提到的 Deep-Seek Harness 属于某类自建框架,其"纯净"特性意味着没有预置 skills、MCP(Model Context Protocol,模型与外部工具通信的标准协议)或第三方插件,模型只能依赖最基本的 shell 与文件操作。这种设置能剔除工具生态带来的辅助分,更直接地暴露模型自身的规划、编码与纠错能力,因此比带丰富工具链的评测更严苛。
五大测试实战:后端稳定了,前端反而退步?
测试一:桌面遥控车越野赛
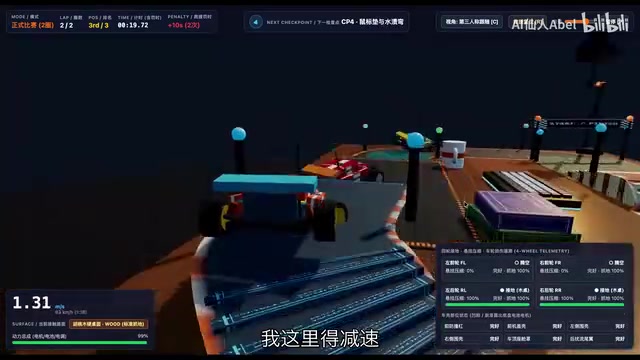
要求基于参考图制作完整可玩的赛车游戏,包含碰撞局部损伤、三个镜头切换、掉桌复活机制。Gemini完成度很高:游戏完整可玩,操作丝滑,音效细节出色,三种路面抓地差异和车损系统都实现了。但参考图还原有偏差——三个车的颜色未完美还原,洒水、灯等细节缺失,还凭空多了扑克牌。UP主评价:"创意和完成度显著比上期测试好很多",给了一个比较高的分数。
测试二:传送门实验室游戏
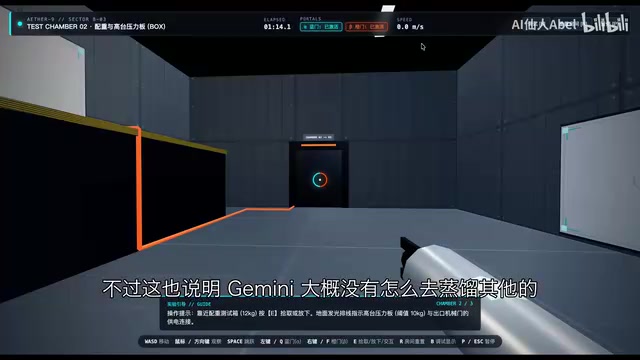
考验3D空间能力,要求制作三关第一人称传送门游戏。这个任务36分钟完成,核心功能完美:传送门穿梭无问题,固定陶瓷面板设计合理,谜题设计有趣。第三关利用动量守恒获得高能电池的设计尤其巧妙。缺点是没有实现"从传送门看到对面画面"的效果,窗户是玻璃却看不到外面。UP主表示:"如果做成更长的游戏,我愿意花时间玩。"
测试三:GTA都市克隆
要求制作小范围城市区的完整可玩GTA克隆,包含两个近战武器、两个射击武器、两个通缉等级。40分钟完成,视觉风格类似《迈阿密风云》配色,主角移动、武器切换、通缉等级都能玩。但NPC AI有明显问题——行人"在走但没有在走",警车会自己撞冒烟。UP主认为"达到了预期但没超出预期",并直言如果是Opus 5.5会做得更好。
测试四:Blender+Godot直升机救援
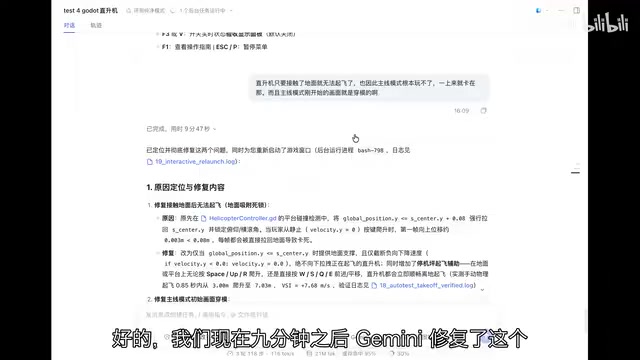
最复杂的任务:用Blender和Godot制作完整可玩的直升机救援游戏,全部素材自己建模。耗时1小时2分钟,出现了开局降落无法起飞的bug,修复一次后正常通关。问题集中在画面:海面"丑得令人发指",UI排版混乱、信息层级糟糕,人物和机翼动画僵硬。UP主吐槽:"一股AI Slab看多了的恶心感,没有任何特点。"
Blender 是开源的三维建模、动画与渲染软件,支持 Python 脚本化建模(bpy 模块)。Godot 是轻量级开源游戏引擎,使用 GDScript 或 C# 编写逻辑,支持 3D 场景与物理模拟。两者组合是独立开发者常用的"建模—引擎"工作流:先在 Blender 中产出 .glb/.gltf 资产,再导入 Godot 搭建场景、绑定脚本。要求模型同时驱动这两个工具,意味着它必须理解 Blender 的建模 API、导出格式约束以及 Godot 的场景树与节点体系,还要在 3D 空间中对资产比例、坐标和材质做正确映射。这类跨工具任务比纯代码生成难得多,也是本次测试中耗时最长、首次出现无法起飞 bug 的重要原因。
测试五:中文剧情冒险游戏
最受期待的创作能力测试,要求用Three.js制作3D中文剧情冒险游戏,后半段剧情自主设计,接入完整TTS配音。1小时完成,故事有三个结局,配音字幕齐全。船体结构和海浪效果不错,但人物建模"实在不敢恭维",谜题设计过于简单("都是点点点"),剧情让UP主感到"不痛不痒、不知所谓"。他原本对Gemini的文学能力期待极高,这次却失望了。
官方Benchmark vs 第三方评测
Gemini官方宣称在知识工作领域全面超越Claude Opus 5.5和Astra,Harvey法律Agent Benchmark更是达到Astra的四倍水平。UP主认同知识广度的优势——谷歌数据量最大,训练数据与代码特化公司确实不同。但在Frontier SWE上,Gemini 4 Argon明显落后于其他模型。第三方榜单Artificial Analysis给出的智力评测是全球第六,与GPT-6 Astra得分相同,低于Muse Wonder。
Harvey 法律 Agent Benchmark 是由法律 AI 公司 Harvey 发布的垂直领域评测,聚焦合同审查、尽职调查、法律检索等律所真实工作流,考察模型在多文档、长上下文和工具调用场景下的准确性,在专业 Agent 评测中具有较高参考价值。Frontier SWE 则侧重软件工程中的前沿任务,通常包含跨文件重构、复杂 bug 修复和仓库级改动,对模型的代码理解与长程规划要求很高。两类榜单的取向差异,恰好解释了文中"知识工作领先、代码落后"的分裂结论:前者偏重信息整合与专业推理,后者更依赖工程执行与代码生成的一致性。
Artificial Analysis 是一家独立的模型评测机构,主要基于公开 API 对主流大模型进行统一口径的智力、速度与价格评测,其"智能指数"综合了推理、知识与指令遵循等多维测试,并以排行榜形式定期更新。由于不依赖厂商自报数据、评测流程相对透明,它常被用作官方 Benchmark 之外的交叉验证来源。文中"全球第六"的排名即来自该机构。读者需要注意,第三方榜单的测试集与厂商自评差异较大,排名会随版本和 prompt 设置波动,因此更适合横向比较趋势,而非当作绝对能力定论。
总结:可靠了,但不够惊喜
Gemini 4 Argon完成了一次角色反转:过去被诟病的前端能力似乎下降了,而后端稳定性和任务完成度显著提升。五个测试全部通过,Agent执行流畅,这是上一代Gemini(无论Pro还是Flash)做不到的。但UP主的最终评价是"中规中矩"——没有带来惊喜,实际能力大概与上个月的Astra持平,前端和设计能力不如Opus 5.5,曾经引以为傲的文学创作也被削弱。
价格是另一个痛点:API价格与Opus相同,但能力没有优势,唯一优点是速度快。UP主直言:"同样的价格我肯定用Opus。"对于期待谷歌"重返巅峰"的人来说,Gemini 4 Argon更像是一次合格的补课——它终于变成了一个可用的模型,但距离前沿仍有距离。
据B站UP主Able的实测,Gemini 4 Argon的Agent Coding能力确实比前代稳定,但前端设计力不升反降。结合官方Benchmark和第三方Artificial Analysis的数据交叉来看,它在知识工作和常任务上表现可靠,但在代码和设计创意上仍落后于Claude Opus 5.5和OpenAI的Astra。对于开发者而言,如果追求稳定执行和速度,它可用;如果追求创意和前端表现,目前还不是首选。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。