Gemini 4 Argon实测:定价激进,3D能力需调教
Gemini 4 Argon 实测:调教后3D与移植能力突出,但零样本平庸且涨价存疑。
Google 发布 Gemini 4 Argon,科技博主 Bijan 实测显示其喜忧参半。限时定价输入2美元/输出10美元每百万token,11月30日后翻倍,届时将直面 Opus 5.5 和 Muse Wonder。技术上支持百万token上下文、输出可扩至百万级、原生多模态输入。前端审美拥挤,零样本3D结果基础,需多轮反馈调教;但调教后能生成前沿级3D汽车模拟器,并在2.5小时内将2000年游戏逆向移植到Linux,表现优于Meta Muse Wonder。目前或仅限Ultra订阅者,访问限制影响普及。低价区间竞争力强,涨价后优势待观察。
Google 终于发布了 Gemini 4 Argon,作为 Gemini 3.1 Pro 的继任者,这款模型承载着 Google 在高端 AI 竞争中扳回一城的期望。YouTube 科技博主 Bijan 在获得早期访问权限后,对其进行了深度实测,从定价策略到编程能力,再到 3D 场景生成,结果可谓喜忧参半。
定价策略:先甜后苦
Gemini 4 Argon 目前采用限时 introductory price,输入每百万 token 2 美元,输出每百万 token 10 美元,与 Sonnet 5.5、GPT-6.1 Soul 处于同一价位。但这个价格仅维持到 11 月 30 日,之后将翻倍至输入 4 美元、输出 20 美元,直接对标 Opus 5.5 和 Meta 的 Muse Wonder。
博主坦言,在低价区间,Argon 的竞争力“非常强”,甚至可能优于 GPT-6.1 Soul 和 Sonnet 5.5。但价格翻倍后,它需要面对更严苛的对比。他个人希望 Google 能维持 introductory price,毕竟到 11 月 30 日,竞品可能也已经迭代。
技术规格:超长输出与原生多模态
Argon 的技术参数有几个亮点。它原生支持多模态输入,涵盖文本、图像、视频、音频和 PDF,输出为文本。上下文窗口达到百万 token,默认最大输出为 65,536 token,但可扩展至略超百万 token——这在当前模型中相当罕见,通常 128k 输出已属优秀。
默认推理努力级别为“medium”,用户可以在 AntiGravity 平台中手动提升。博主提到,模型还提供了“boost”和“teamwork preview”等模式,前者适合短周期高强度任务,后者面向长周期任务。
零样本(Zero-shot)与少样本(Few-shot):零样本指模型在没有任何示例或额外训练的情况下直接完成任务;少样本则是在提示中提供少量示例。文章强调 Argon 并非“零样本高手”,意味着其首次输出质量有限,需通过多轮对话、反馈或示例引导才能达到更优结果。这与模型是否具备强指令遵循和泛化能力有关,也直接影响用户体验和调教成本。
推理努力级别(Reasoning Effort):这是部分新一代模型提供的可调参数,用于控制模型在生成答案前进行内部推理的“思考量”。级别越高,模型可能进行更长的链式推理,适合复杂任务但延迟和成本更高;级别越低则响应更快、成本更低。Argon 默认 medium,并允许在 AntiGravity 平台手动提升,体现了在质量、速度与费用之间权衡的设计思路。
前端审美与零样本能力:明显的短板
在 AntiGravity 中,博主让 Argon 生成一个“浏览器操作系统”。结果呈现了典型的 Gemini 风格:Synthwave 美学、密集的前端界面、内置音效。博主直言“我不是前端风格的粉丝”,界面过于拥挤杂乱。
更关键的是,Argon 并非“零样本高手”。首次生成的结果往往较为基础,需要用户多轮反馈甚至“吼它几句”才能产出更好的版本。博主在多个测试中重复了这一观察:初始输出不如 Claude 的 Sonnet 或 Opus 系列惊艳,但经过调教后有显著提升。
3D 与游戏生成:有深度,但需耐心
博主运行了多项传统测试,包括 C++ 滑板游戏、机器人手臂操作、Subway FPS 和 3D 汽车建模。
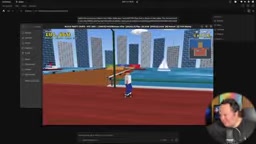
滑板游戏首次生成耗时约 39 分钟,结果“远比预期基础”,画面细节不足,但游戏逻辑和可玩性尚可。博主随后给模型提供了一分钟的视频参考(来自 Sonnet 5.5 的同类结果),要求它超越参考。经过约 1 小时 10 分钟,Argon 确实吸收了视频中的 splash 逻辑、NPC 评论和运动轨迹等元素,但图形保真度仍未达到 Claude 的水平。
机器人手臂测试中,Argon 用 22 分钟完成了任务,是第二快的成绩,且比之前某个“失败中成功”的 Claude 模型更胜任。它还表现出对物体朝向的细致关注,会调整夹爪使汽车保持与初始图像平行的方向。
Subway FPS 首次生成环境过于简单,但经过“AAA 风格”的反馈后,敌人模型、子弹孔和场景细节均有明显改善,甚至加入了列车晃动时把手同步移动的效果——此前仅在 Meta Muse 中见过。
最令博主印象深刻的是 3D 汽车建模与驾驶模拟。经过四天断断续续的交互,Argon 在 Blender 中构建了一辆 1980 年代 Saab 900 Turbo,并扩展成一个包含经销商、机械师和驾驶场景的小型模拟器。模型还原了中置钥匙孔、电池位置、仪表盘绿光等细节,甚至模拟了减速时的回火声。博主评价这是“前沿级结果”,但强调“绝非一次成型”,需要大量来回打磨。
逆向工程:两小时半的“疯狂”移植
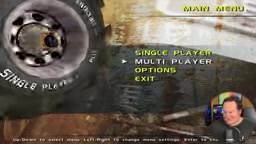
视频标题中的“Insane”很可能来自这项测试。博主提供了一款 2000 年的老游戏《Insane》的 heavily modified 版本,要求 Argon 将其“逐字节重编译”并原生运行在 Linux 系统上,同时提升性能。
结果,Argon 在 2.5 小时内完成了移植,游戏成功以原生分辨率运行,软体碰撞物理效果完好。博主随后要求它生成一段动画信息图解释过程,模型也顺利交付。作为对比,他用相同的提示和文件在另一台电脑上测试了 Meta 的 Muse Wonder,后者“直接卡死”,未能像 Argon 这样快速完成。
逐字节重编译(Byte-for-byte recompilation):通常指将为某一平台编译的二进制程序,通过反汇编、反编译或二进制翻译,重建为可在另一平台原生运行的代码或等价物。它要求模型理解底层指令集、内存布局、调用约定和平台差异。文章中的测试要求 Argon 将 2000 年 Windows 游戏移植到 Linux 并提升性能,属于高难度的系统级编程任务,能较好检验模型对代码语义和底层细节的把握。
软体碰撞物理(Soft-body collision physics):软体物理模拟可变形物体(如布料、果冻、轮胎形变)在碰撞中的行为,计算量远高于刚体物理,涉及连续介质力学、约束求解和数值稳定性。文章多次提到软体碰撞效果完好,说明 Argon 在生成或移植游戏逻辑时,能保留较复杂的物理模拟代码与参数,而不仅是界面或简单交互。
总结:有深度,但非全能
Bijan 的结论是,Gemini 4 Argon 是一个“非常强”的模型,尤其在视觉理解和长周期任务上展现出深度。但它不是那种一蹴而就的模型——前端审美不佳、零样本 3D 结果平庸,需要用户投入时间调教。目前它似乎仅对 Ultra 订阅者开放,访问限制也令博主不满。
在 2 美元/10 美元的价位上,Argon 极具竞争力;但若价格翻倍,它将直面 Opus 5.5 和 Muse Wonder 的竞争,届时优势是否还在,仍需观察。对于愿意花时间打磨的开发者,Argon 的深度值得挖掘;对于追求“一句话出神作”的用户,它可能不是首选。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。