Gemini 4 Argon真能排第一?对比Claude Opus 5.5与GPT-6 Astra

Gemini 4 Argon并非全能第一,长文档写作强、编码弱,选型需按场景。
文章以 YouTube 频道 Prom 的横向实测为线索,对比 Google Gemini 4 Argon、Claude Opus 5.5 与 GPT-6 Astra。Argon 在 Google 自选的 19 项测试中拿下 13 项第一,但在 Artificial Analysis 综合指数中仅列第二,落后于 Opus;换到 VALS 指数又重回第一,说明排名高度依赖测试选择。真实办公任务中 Argon 与 Opus 40 比 40 打平且单次成本更低、诚实度更高,但六场应用构建对决 Opus 全胜,代码审查误报严重。成本上 Argon 单价低却 token 消耗大,12 月涨价后单任务成本将反超 Astra。结论是三个模型各有所长,应按任务场景选择并自行实测。
Gemini 4 Argon真能排第一?对比Claude Opus 5.5与GPT-6 Astra
Google在9月30日发布Gemini 4 Argon时,宣传语只有一句:19项测试中13项第一。但诡异的是,最初几乎没人能用上它——Google只开放给负责拦截黑客的网络防御团队。直到10月13日,大门才向所有人敞开。那么,它真的是第一名吗?YouTube频道Prom把Argon请到镜头前,与Claude Opus 5.5和GPT-6 Astra同席而坐,用大量实测数据给出了一份独立答案。
纸面参数:百万级上下文与定价策略
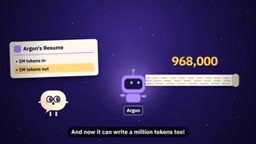
Argon的简历第一行写着:一次读取100万token,相当于好几本厚书。现在它也能一次写出100万token,而上一代模型停在6.4万。不过有个限制:写满100万需要开启特殊的长模式,普通回答的上限仍在6.5万token左右。视觉能力同样犀利,它能读图表、看长视频、处理成堆文档,在长视频测试中拿下91.7分。
定价方面,截至11月底,Argon的输入价格为每百万token 2美元,输出10美元。从12月起价格翻倍,与Opus持平。Astra则是输入10美元、输出50美元。
上下文窗口(context window) 指的是模型在一次对话或单次调用中能够同时“读到”的 token 总量,包括系统提示、历史对话、上传文档和待生成内容的全部。它决定了模型能否一次性消化整本书、长视频字幕或大型代码库,而不必分段摘要后丢失细节。Google 宣传的 100 万 token 输入能力属于当前业界顶级水平,但要注意“能读”与“能有效利用”并不等同:模型在超长上下文中对中段信息的召回率往往会下降,这也是各家在长上下文评测中单独设项的原因。另一方面,输出上限与输入上限是两个独立参数,长输出模式通常需要特殊开关并可能影响生成速度与计费方式。
Google的表格与独立评测的冲突
在Google自己发布的成绩表中,Argon确实在19个科目中拿下13个第一。法律工作测试中,Argon得分19.6,Opus仅为3.8。但关键问题在于:这张表是谁做的?Google自己选的科目、自己挑的对手。
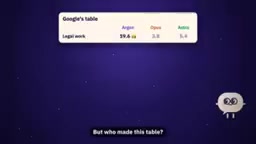
在终端编码测试中,Opus以66.4分获胜,Argon只有57.4分。于是Prom引入外部评分机构。独立实验室Artificial Analysis的综合指数显示:Opus 58分,Argon 53分,Astra 50分。但在另一项独立测试VALS指数中,Argon以68.9分拿下第一。同一款模型,换一个测试就换一个赢家。
独立评测机构与综合指数 是当前模型排名争议的核心背景。Artificial Analysis、VALS 等第三方机构通过统一提示词、标准化评分脚本和固定版本快照,对多个厂商的模型跑同一套基准,再把编码、数学、指令遵循、多语言等子项加权成一个综合分数。它们相对厂商自测的价值在于可复现、可横向比较,但局限同样明显:加权方式由机构自定,题库可能被训练数据污染,且综合分无法反映特定场景的强弱。因此同一模型在不同指数中名次互换是常态,读者应把指数看作“某一组任务上的抽样结果”,而非绝对能力排名。
真实办公任务:Argon与Opus打平且更便宜
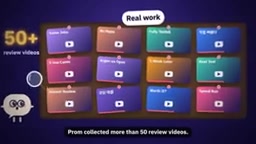
抛开分数,看实际工作。其他YouTuber已经试过同样的任务,Prom收集了50多个评测视频。在四项办公任务中——比如读取收据、做图表计算——Argon和Opus打成40比40平手。但Argon更便宜:单次任务成本0.21美元,Opus为0.37美元。
还有对比发现,Argon在将访谈整理成新闻简报、以及医学研究任务中表现最佳。它像一位文笔出色的新员工。但构建应用是另一回事:在六场应用构建对决中,Opus全胜。一位开发者反馈,Argon代码审查中78项发现里有56项是错的。在Prom自己的电脑上打开anti-gravity的模型列表,甚至还没看到Argon——Google表示,在anti-gravity中它仅对顶级Ultra套餐开放。
代码审查(code review) 是检验模型编码能力的典型任务,要求模型读懂一段 diff 或整个仓库片段,判断改动是否引入逻辑错误、边界条件遗漏、安全漏洞或风格问题,并给出可执行的修改建议。它与“写代码”侧重不同:生成代码看重从零构建的正确性与结构,代码审查则看重对既有代码语义的精确理解和对误报的控制。业界通常用精确率(报出的问题中真实存在的比例)和召回率(真实问题被找出的比例)来衡量,只统计发现数量而没有人工复核,容易高估模型的实际可用性。
成本账单:单价低不等于总价低
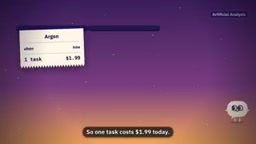
Argon的单价确实低,但它话多:每个任务平均消耗6.2万token,而Astra只用2.7万。算下来,今天完成一个任务,Argon花费1.99美元,Opus要5.98美元。但到了12月全价时,Argon的成本将比Astra的3.26美元高出3.98美元。
真正的转折在诚实度测试:模型有多常假装自己知道?Argon为15%,Astra高达51%。但准确率方面,Argon为50%,Astra为63%——Astra知道得更多。Argon更像是那个会说“我不知道”的新员工。
结论:没有全能冠军,只有场景匹配
那么Argon到底排第几?长文档处理、研究、报告写作、长视频总结——这是Argon的地盘,便宜且诚实。终端修代码、构建应用——Opus依然更强。如果追求答对最多,Astra是首选,但成本最高。
Prom把三个模型比作办公室里的三张桌子:Argon负责写作,Opus负责编码,Astra负责搜索答案。测试决定谁是第一。但请务必在你自己的任务上测试全部三款模型。记住,12月1日价格翻倍,而且最后还得由人来把关。
相关推荐

英伟达3万开发者用Cursor,代码提交量增3倍
Cursor现场工程师拆解企业AI编程从试点到规模化之间的五个缺口:战略清晰度、风险分级、治理审计、业务度量与运营战略。英伟达3万开发者每日使用Cursor,代码提交量增至3倍且缺陷率持平,关键在于重写SDLC而非叠加工具。

Ponytail:给AI编码代理装上资深工程师思维
Ponytail 是一个 GitHub 免费工具,为 AI 编码代理注入资深工程师思维,让 AI 先问代码是否必要。据 TamilDeck 介绍,它可将 AI 生成的 200 行代码压缩到 30 行,降低 token 成本,支持 Cursor rules 与 Claude Code skill 接入,但安全审查仍需人工把关。

Cursor AI 接入 GitHub MCP 服务器完整指南
手把手教你将 Cursor AI 接入 GitHub MCP 服务器:创建个人访问令牌、配置 mcp.json、用 ENV 块安全管理 token,并通过查询 PR 验证连接是否生效。