Gemini 4 Carbon:DeepMind网络安全与编程新旗舰
DeepMind 发布面向网络安全防御与编程的 Gemini 4 Carbon,受限开放、定价克制。
Google DeepMind 推出前沿模型 Gemini 4 Carbon,定位网络安全防御与代码能力。其在 Artificial Analysis Intelligence Index 上得 59 分,SEC-bench Pro 达 88.2%,显示安全任务上有针对性优化。访问权限优先向经审核的安全防御者开放,以平衡能力释放与滥用风险,但短期内限制生态扩散。定价为每百万 tokens 输入 2 美元、输出 10 美元,在前沿模型中相对克制,适合生产环境规模化调用。文章认为安全与编程绑定源于现代防御工作核心在代码层面,并指出前沿模型竞争正从综合榜单转向场景化定位,开放节奏是观察其口碑的关键。
Google DeepMind 又向前沿模型俱乐部投下一枚重磅炸弹。这次的主角名为 Gemini 4 Carbon,官方定位非常明确:面向网络安全防御与代码能力的前沿模型。与以往「全能型」发布不同,Carbon 一登场就带着鲜明的行业属性,同时在价格与开放策略上做出了取舍。
两项基准成绩,勾勒出能力轮廓
根据 MarkTechPost 的报道,Gemini 4 Carbon 在 Artificial Analysis Intelligence Index 上拿到 59 分,在 SEC-bench Pro 上取得 88.2% 的成绩。前者是衡量综合智能水平的第三方指数,后者则更贴近安全场景下的专业任务评测。两个数字放在一起看,说明 Carbon 并非只堆通用能力,而是在安全相关任务上有针对性地做了优化。
需要说明的是,单一分数并不能完全代表真实防护效果。安全领域的评测往往依赖特定数据集与任务设定,88.2% 的 SEC-bench Pro 成绩值得关注,但距离「无懈可击」仍有空间。对于打算引入该模型的安全团队来说,把它当作辅助研判与代码审计的强力工具,比当作全自动防线更现实。
Artificial Analysis Intelligence Index 是由第三方评测机构 Artificial Analysis 维护的综合智能指数,它把多个主流基准(如 MMLU、GPQA、HumanEval 等)的得分归一化后加权汇总,用来横向比较不同厂商前沿模型的整体能力水平。该指数并非官方标准,但在模型选型时常被引用作为参考坐标。需要留意的是,综合指数对特定垂直能力(如安全审计)的区分度有限,因此常需配合专项基准一起解读。
SEC-bench Pro 则属于安全领域的专业基准,任务通常围绕漏洞识别、恶意代码分析、补丁生成等真实防御场景设计,考察模型在代码层面的安全理解与推理能力。此类基准的分数受数据集构成与任务难度分布影响较大,不同版本之间不宜直接横比。
先给防守方:受限访问的策略意味
Carbon 的开放方式颇具信号意义——访问权限首先向经过审核的网络安全防御者开放。这不是一次面向公众的全面放量,而是带有甄别门槛的分批开放。
这种策略在安全模型领域并不陌生。攻防两端使用同一套能力,风险是不对称的:防御方需要工具来发现漏洞、分析恶意代码,而攻击方同样可能利用它寻找突破口。DeepMind 选择先服务「vetted cyber defenders」,本质是在能力释放与滥用风险之间寻找平衡点。代价则是普通开发者与中小企业短期内难以直接触达,生态扩散速度会受到限制。这条路线能否在安全社区形成正反馈,取决于后续开放节奏与审核效率。
「vetted cyber defenders」指的是经过身份与用途审核的网络安全防御方,通常包括安全厂商、企业安全团队、漏洞研究机构等。审核流程一般会核验组织资质、使用场景与合规承诺,通过后才开放 API 或模型访问权限。这种做法在双用途(dual-use)能力模型上较为常见,目的是在释放防御价值的同时降低被滥用于攻击的风险。对申请方而言,审核周期与标准透明度会直接影响接入意愿,也是评估该模型生态能否快速铺开的重要变量。
定价透露的定位:$2/$10 每百万 tokens
价格信息同样值得细读:输入 $2、输出 $10 每百万 tokens。在前沿模型梯队中,这一档定价处于相对克制的位置,尤其考虑到其面向安全与编程这类高价值任务。
对安全运营场景而言,成本结构会直接影响使用方式。漏洞扫描、代码审查、日志分析往往涉及大量上下文输入,较低的输入价格有利于把模型嵌入到持续性的工作流中;而输出价格相对更高,则提醒使用者优化提示设计,减少冗长回复带来的开销。这组定价不太像是面向实验性尝鲜,更像是为生产环境的规模化调用做准备。
每百万 tokens 定价是大模型 API 的通用计费口径:输入指送入模型的提示与上下文,输出指模型生成的回复,两者分别计价。安全运营场景中,日志、代码库、告警文本等上下文往往体量庞大,输入 token 消耗远高于输出,因此输入单价对总成本的影响更显著。输出单价较高则促使用户通过结构化提示、限制回复长度等方式控制开销。与前沿梯队中部分模型动辄每百万 tokens 数十美元的定价相比,$2/$10 属于偏低的档位,更贴近高频生产调用而非低频试验。
编程能力为何与网络安全绑定
把「cyber defense」和「coding」并列作为核心卖点,背后有清晰的逻辑。现代安全防御的很大一部分工作发生在代码层面:识别不安全依赖、审查提交中的风险模式、理解漏洞成因、生成修复补丁。这些任务本质上都是代码理解与生成的延伸。
Carbon 在这两个方向同时发力,意味着它可能更适合嵌入开发流程而非独立运行。安全左移的理念已被广泛接受,但落地一直受限于人力。一个在 SEC-bench Pro 上表现突出的模型,若能与 CI 流程结合,确实有机会把部分安全审查前置到编码阶段。当然,这要求团队具备相应的工程能力来搭建集成与验证环节,模型本身只是链条中的一环。
安全左移(Shift Left Security) 是指把安全审查与漏洞发现尽量前移到软件开发生命周期的早期阶段,而非等到上线后再做渗透测试或应急响应。落地手段包括在 CI/CD 流水线中集成静态分析、依赖扫描与代码评审机器人。大模型在这一环节的价值在于理解代码语义、识别风险模式并生成修复建议,但其输出仍需人工复核,且集成需要工程投入。模型能力只是安全左移链条中的一环,流程设计与验证机制同样决定最终效果。
前沿模型的竞争正在转向场景
Gemini 4 Carbon 的发布,折射出前沿模型竞争的一个变化:单纯比拼综合榜单的时代正在让位于场景化定位。Artificial Analysis Intelligence Index 的 59 分保证了它站在第一梯队,但真正让它有辨识度的,是安全防御与编程这两个明确锚点,以及配套的受限开放与分层定价。
对国内开发者和安全从业者而言,短期内更实际的动作是关注其开放范围是否扩大、审核标准如何界定,以及是否有面向企业的合作通道。能力再强,触达不了也只是纸面参数。Carbon 能否在真实攻防场景中积累口碑,接下来几个月的开放节奏会是关键观察窗口。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
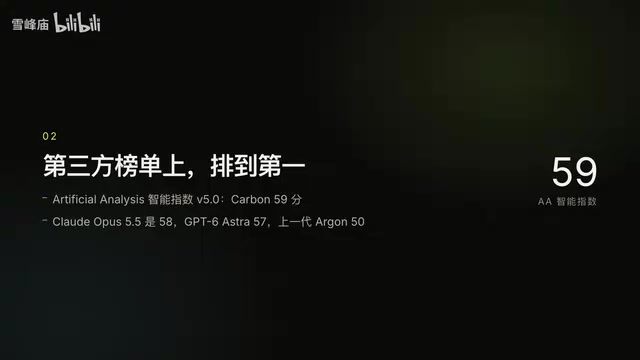
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。