Gemini 4 Carbon登顶却难用?三周实测真相
Gemini 4 Carbon号称最强,但测试口径、访问限制与独立验证均存疑。
Google DeepMind发布的Gemini 4 Carbon被独立评测机构Artificial Analysis列为榜首,但发布三周后公开可用版本与宣传版本存在差距。其安全分数在关闭安全护栏下测得,对应Fairwind白名单访问方式,而非公开API能力。独立评测第一仅领先第二名1分,且消耗约2亿输出Token,远超中位数7100万,分数靠算力堆出。CWE Bench上Carbon只有单次尝试71%的成绩,在4次尝试口径下落后于竞品。幻觉率从Argon的4%升至11%,模型更敢说也更敢错。Fairwind计划门槛高、案例均为Google转述,公开可复现的独立验证仍然缺位。Carbon是强信号,但还不是可复现的评测。
Google DeepMind在10月28日发布了号称“目前最强”的模型Gemini 4 Carbon,独立评测机构Artificial Analysis将其排在榜首。但发布后三周,真正能用上它的人寥寥无几——这个“第一”背后,藏着测试口径、访问限制和独立验证的多重问号。
一个“最强模型”的三周困境
Carbon建在两周前推出的Argon之上,主打两件事:长周期工程任务和网络安全。所谓长周期,是让它在一个大代码库里连续跑好几天,自己找bug、改完再验证。听起来像是软件工程的理想助手,但发布三周后,公开可用的版本和Google宣传的版本之间,隔着一条不小的鸿沟。
11月10日,Carbon终于向付费开发者和企业开放,模型ID为Gemini 4 Carbon,Google AI Ultra用户也能用。但网络安全相关的版本是另一个SKU,仍在白名单里。换句话说,你花钱调用的API,和Google用来刷榜的那个模型,并不是同一个东西。
分数很漂亮,但测法有前提
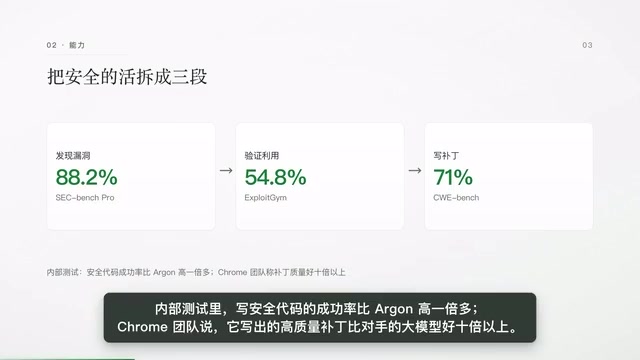
Google给出的网络安全三段式分数是:找漏洞88.2%,做利用54.8%,写补丁71%。内部测试里,写安全代码的成功率比Argon高一倍多。Chrome团队甚至说,它写出的高质量补丁比对手的大模型好10倍以上。
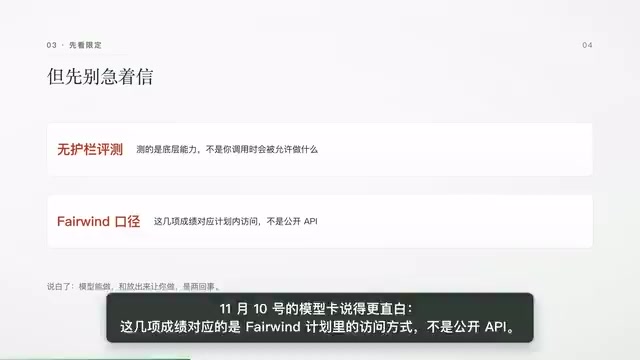
但这些数字有个关键前提——Google自己写明,测试是在关闭安全护栏的情况下进行的。测的是模型“底层能够使用”,而不是你调用时“会被允许做什么”。11月10日的模型卡更直白:这几项成绩对应的是Fairwind计划里的访问方式,不是公开API。
这就像一辆赛车在封闭赛道上跑出了惊人圈速,但卖给消费者的版本被限了速。分数本身不假,但它不代表你买到的产品能力。
独立评测:第一名的分差只有1分
Artificial Analysis把Carbon排在第一,得分59。但这个第一非常薄——第二名Cloud Opus 5.5是58分,只差一分。
更说个细节成本。Carbon在这个测试里烧掉了大约2亿输出Token,中位数只有7100万。分数是拿算力堆出来的,这个第一的性价比要打个折扣。
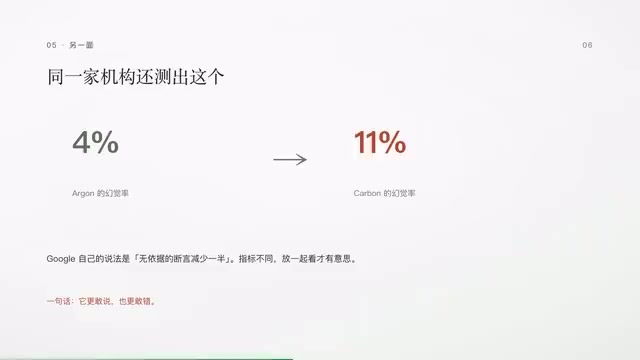
同一家机构还给出了另一个不太好看的数字:Carbon的“幻觉率”(原文称“换绝率”)从Argon的4%涨到了11%。Google自己的说法是“无依据的断言减少了一半”。两个指标测的不是一回事,放一起看才有意思:它更敢说,也更敢错。
CWE Bench(Common Weakness Enumeration Benchmark)是一个针对大模型安全能力的基准测试,由安全研究社区维护,任务要求模型在给定代码片段中识别、利用或修复特定类型的软件弱点(如缓冲区溢出、注入漏洞)。评测通常采用“单次尝试”或“多次尝试”两种口径:单次尝试指模型只生成一次答案即判定对错,多次尝试则允许模型在反馈下反复修正,更接近实际开发中“试错—迭代”的流程。多次尝试成绩通常显著高于单次尝试,因为模型有机会从错误中调整,但也更容易通过暴力搜索或模式匹配“刷分”。因此,跨模型比较时必须对齐尝试次数,否则单次成绩与多次成绩直接对比会严重失真。
CWE Bench:换个口径,领先就没了
Google拿来领跑的CWE Bench成绩是71%,单次尝试。但在独立榜单上,4次尝试的口径里,Cloud 4.7是81%,Opus 5.5是79%,Carbon还没有4次尝试的成绩。
单次尝试和多次尝试是两种完全不同的评测逻辑。多次尝试允许模型反复试错,更接近真实工程场景,但也更容易刷出高分。Carbon目前只报了单次成绩,在可比口径上,它还没有证明自己领先。
所以,谈领先之前,得先问一句:按什么测的?
Fairwind计划:谁能用上真正的Carbon
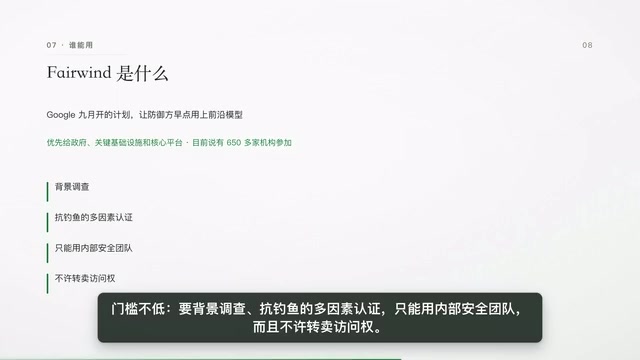
Fairwind是Google在9月开启的计划,让防御方早点用上前沿模型。优先给政府、关键基础设施和核心平台,目前据说有650多家机构参加。门槛不低:要背景调查、抗钓鱼的多因素认证,只能用内部安全团队,而且不许转卖访问权。
已经有一些成果被讲出来。Google说,Waze拿它在两家大型SaaS厂商那里,两小时内找到了零日漏洞(原文称“零日落”)。它的云漏洞研究团队确认了两个开源bug确实能利用,帮维护者把级别改成严重,然后发了补丁。还有基于Carbon的agent,帮忙验证了Signal协议的核心安全保证。
这些成果都是Google转述的,不是第三方独立测的。它们说明Carbon在某些受控场景下确实有用,但也仅此而已。
提示注入(Prompt Injection)是LLM应用中的一类攻击方式:攻击者将恶意指令伪装成正常输入(如用户消息、网页内容或文档),诱使模型忽略原有系统指令,执行攻击者预设的行为,例如泄露系统提示、越权调用工具或输出有害内容。它与传统注入攻击的区别在于,攻击面是自然语言而非代码,防御难度更高,因为模型难以可靠区分“数据”与“指令”。Google报告的“提示注入攻击成功率0%”通常指在特定攻击集上模型未产生预期越狱行为,但这并不代表模型对所有注入手法免疫;攻击集覆盖范围、模型部署时的系统提示和过滤机制都会影响结果,因此该指标需结合测试条件解读。
零日漏洞(Zero-day)指尚未被厂商发现或发布补丁的软件安全缺陷,攻击者可在无官方修复的情况下利用它。发现零日漏洞通常需要深入理解代码逻辑、内存模型或协议实现,传统上依赖安全研究员人工审计或模糊测试(Fuzzing)。大模型被用于辅助漏洞挖掘时,优势在于能快速阅读大规模代码库、识别可疑模式并提出假设,但最终确认漏洞可利用性仍需人工验证和动态测试。文中Waze案例中“两小时内找到零日漏洞”属于高度受控的辅助发现,而非模型独立完成端到端利用;这类成果的价值在于缩短初筛时间,不能等同于模型具备自主发现并利用零日漏洞的通用能力。
安全指标:0%不等于零风险
Google报的安全指标也挺漂亮:提示注入攻击成功率0%,作弊尝试降到0.4%,内部高严重度失调告警少了近8成。
但0%只说明这次测的攻击没成功。换一批攻击、换一种接法,风险会重新冒出来。这些数字也大多是Google自己测的——外面拿不到的,本质上也不算是独立验证。
怎么看Carbon:强信号,但还不是可复现的评测
Carbon是一个很强的信号:AI做长周期工程和安全防御,确实在往前走。Chrome团队的补丁质量反馈、Fairwind计划里的实际案例,都指向这个方向。
但它还不是一份你能自己付现验证的评测。公开API的能力和白名单版本的能力之间有差距,领先幅度在独立口径下大幅缩水,安全成绩的测试条件也非公开环境。
等访问放开,等别人独立测过,再下结论不迟。对于开发者来说,现在能做的,是关注11月30日优惠结束后的定价变化(输入从2美元/百万Token涨到4美元,输出从10美元涨到20美元),以及安全版本何时走出白名单。
排行榜第一是个好故事,但产品好不好用,得自己跑过才算。
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
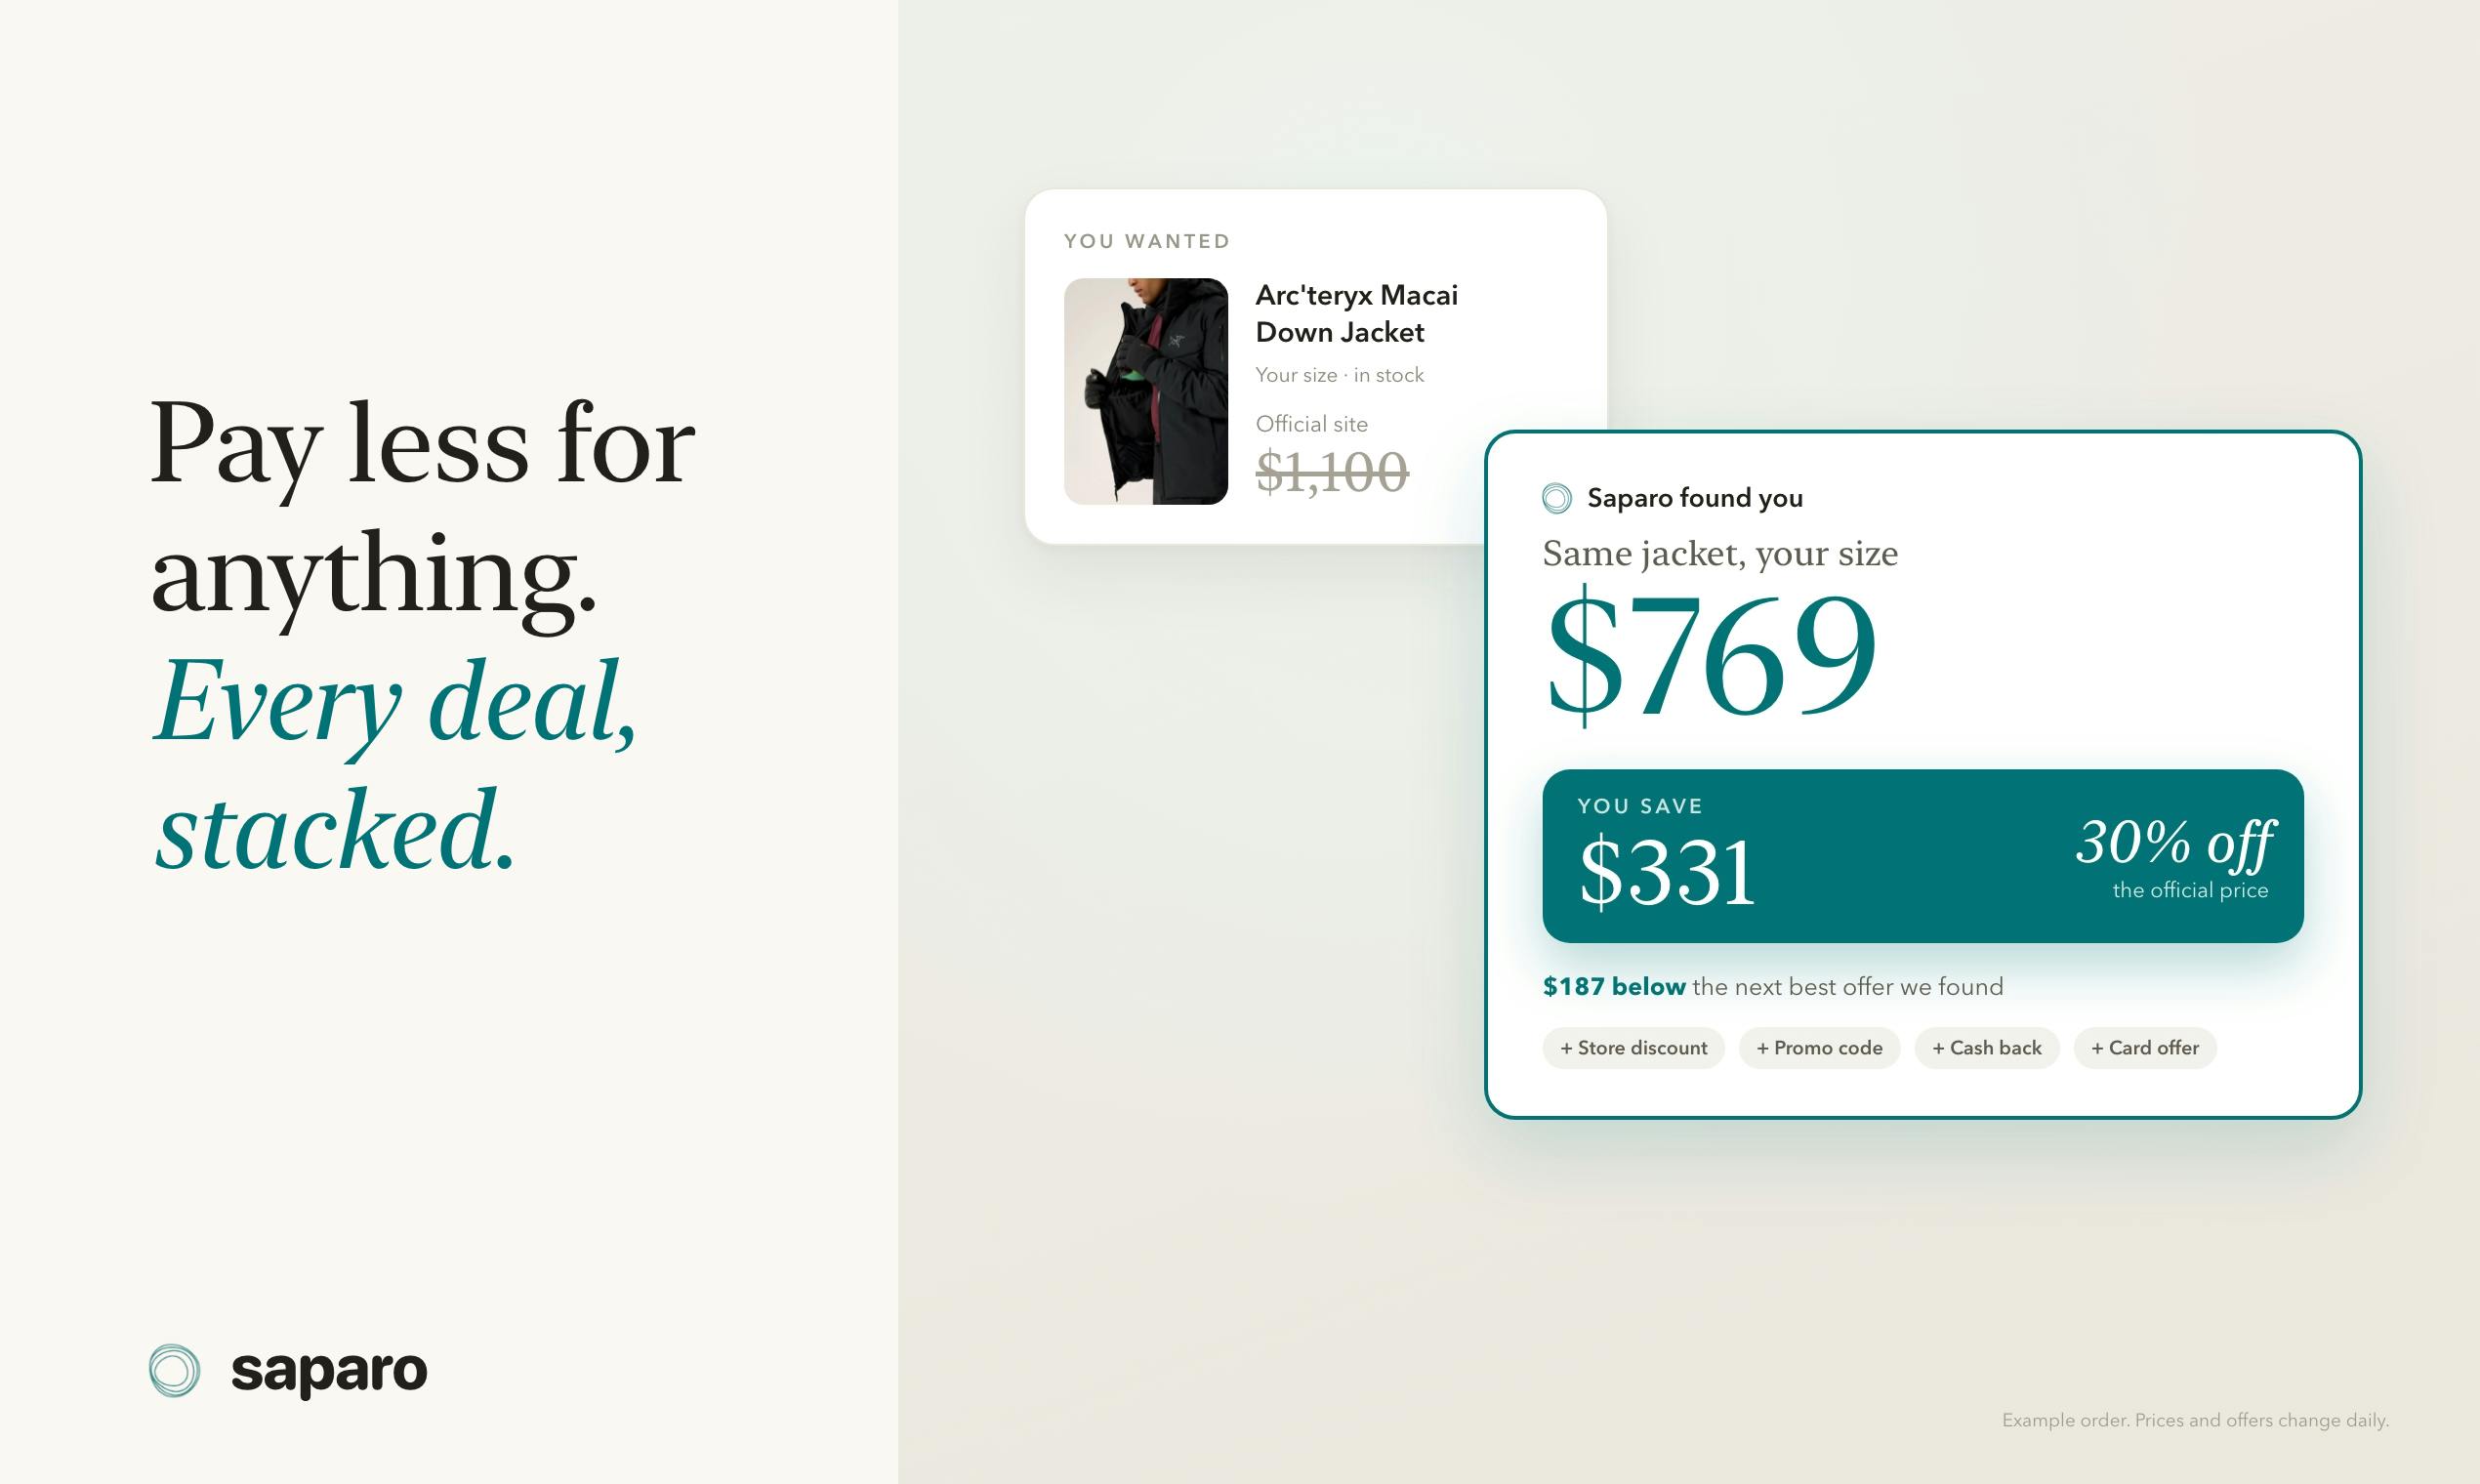
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
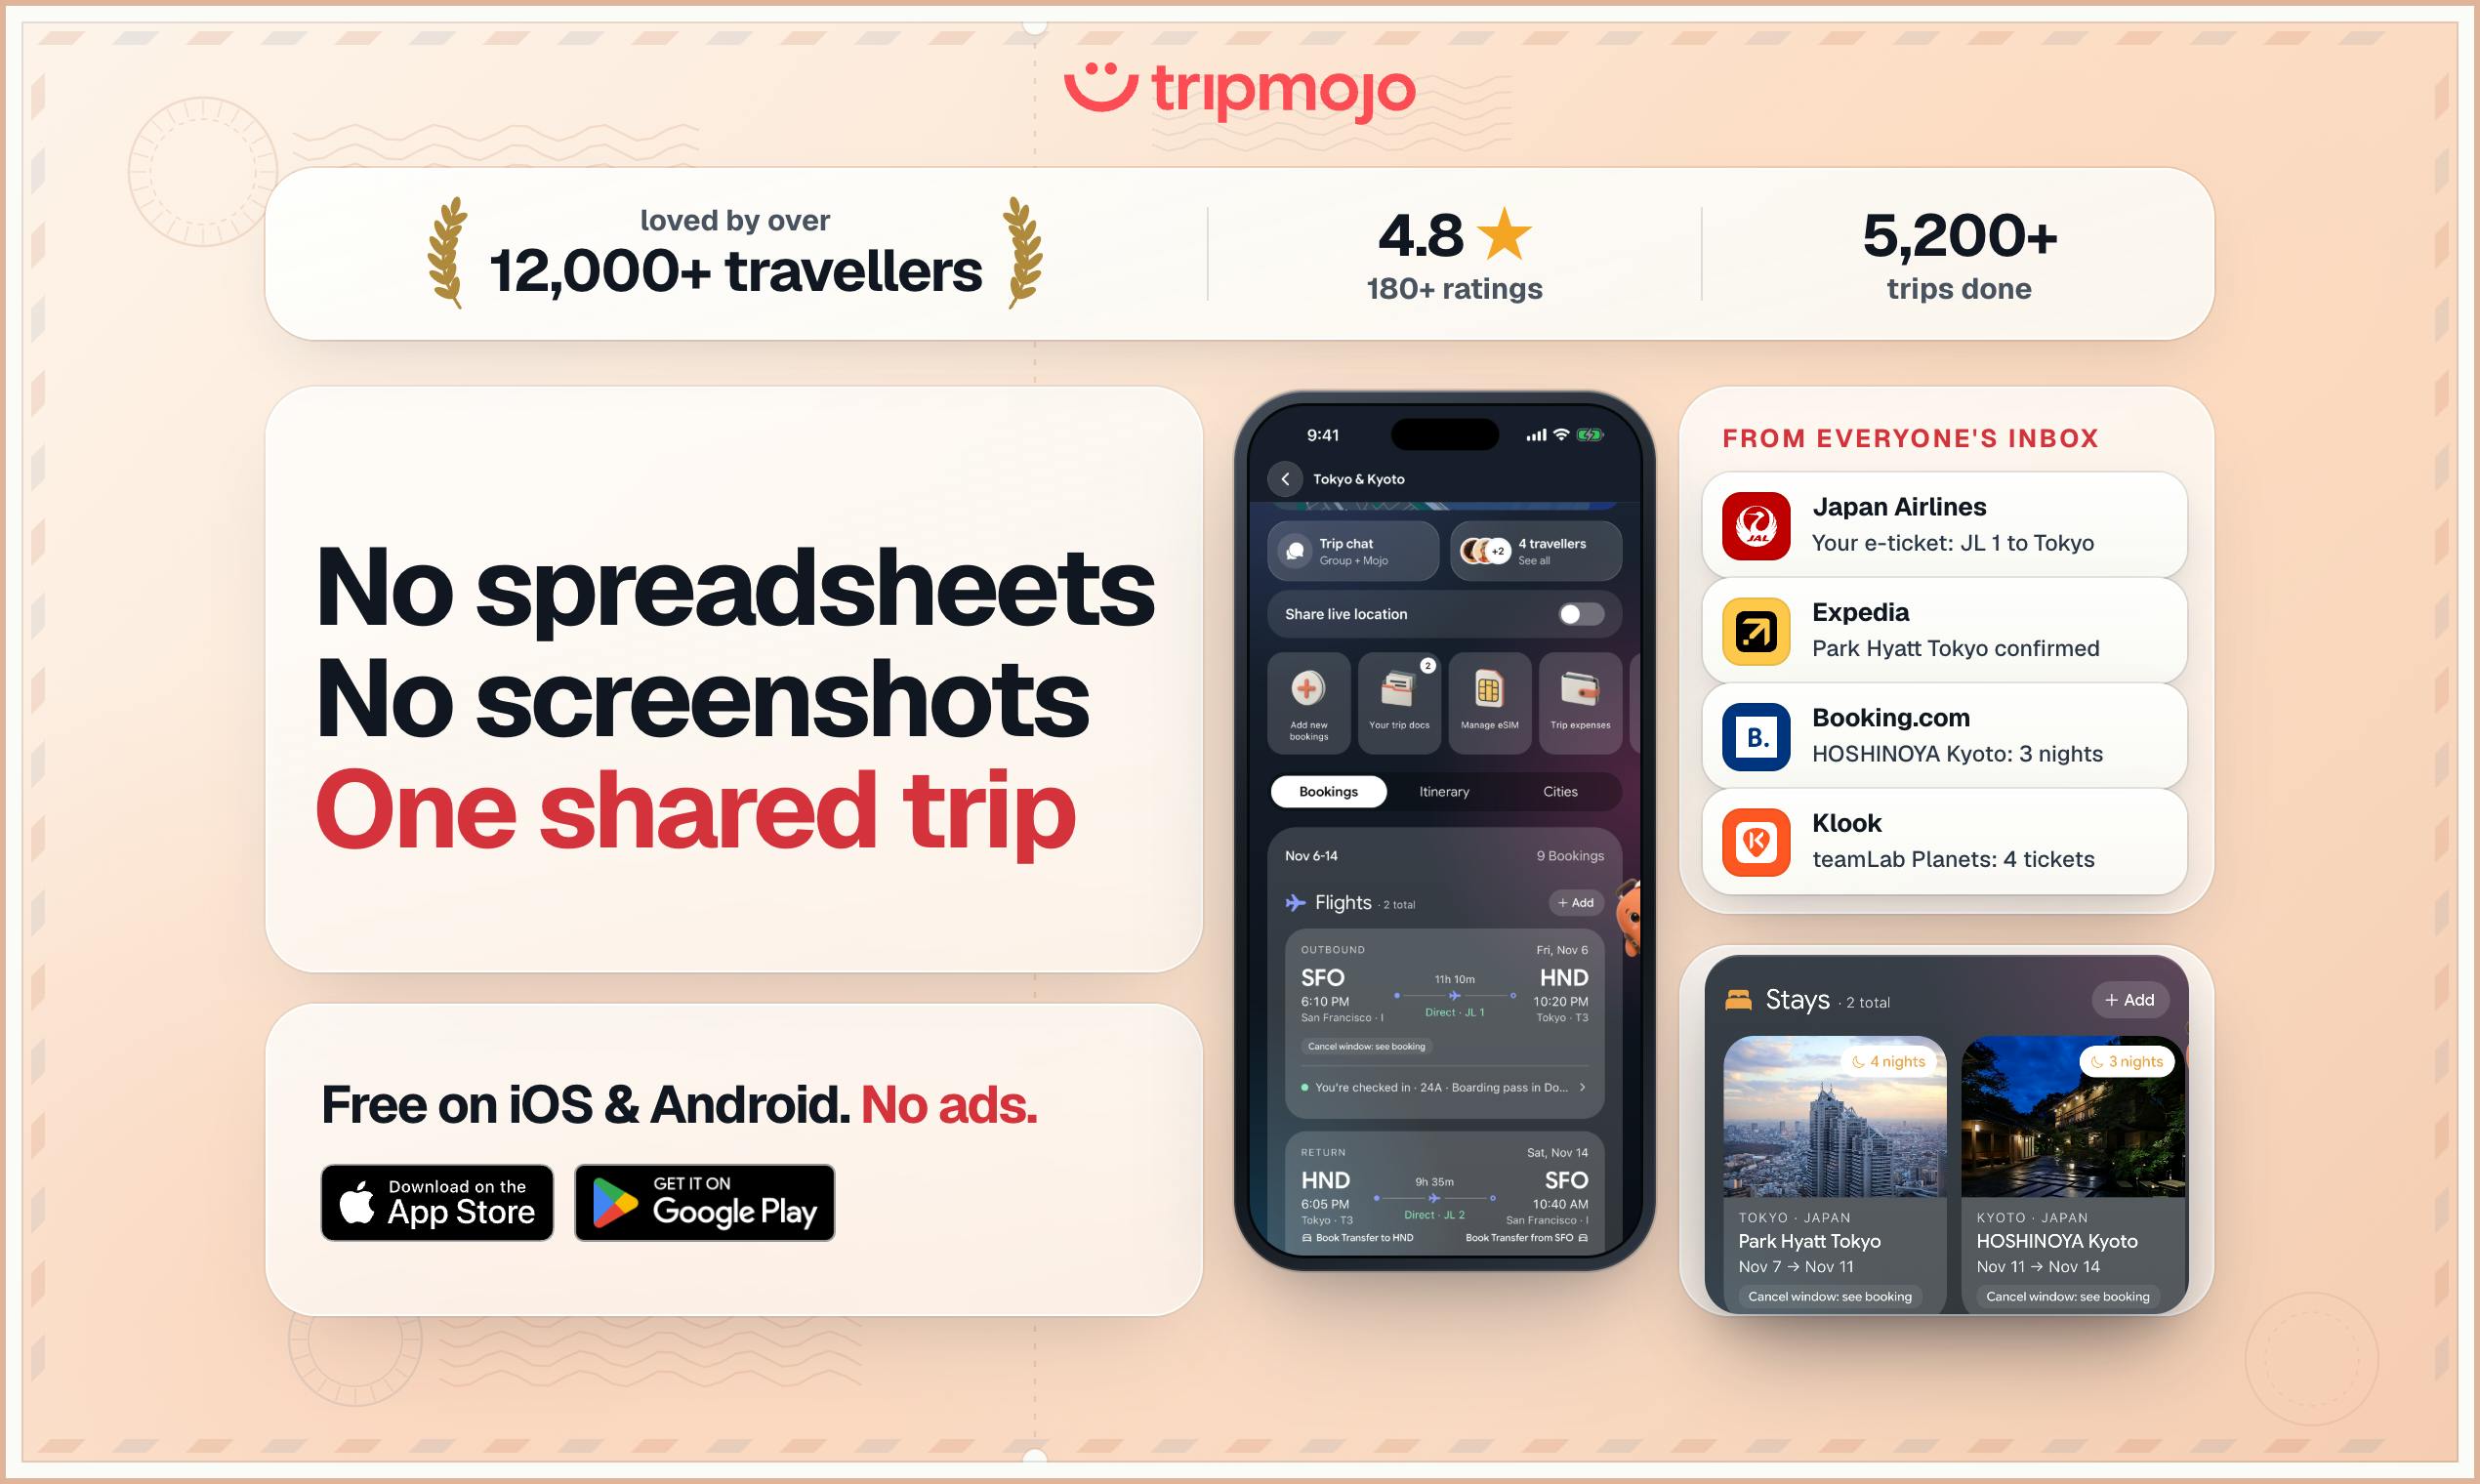
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。