Gemini 4 Carbon发布:全面反超Opus 5.5的旗舰模型

Gemini 4 Carbon 智能与编程反超 Opus 5.5,以半价主打自主工程与安全防御。
Google 在 Argon 发布仅两周后推出新旗舰 Gemini 4 Carbon。据 B 站 UP 主解读,Carbon 在 Artificial Analysis 智能指数 5.00 上以 59 分登顶全球第一,Terminal Bench 4.0 终端工程测试达 65.2%,领先 Claude Opus 5.5 的 59.6%,Graphworks 超长上下文测试更高达 96.2%,领先对手 30 多分。谷歌内部实测中,它能连续运行数天自主定位 bug 并写出修复补丁,呈现「全天候自主工程师」形态。价格上首发半价,输入 2 美元、输出 10 美元每百万 Token,实际账单不到对手四成。安全侧,SEC Bench Pro、Exploit Gym、CWE Bench 三项全面领先,作弊率与提示词注入攻击成功率均为 0.0%。Carbon 将先向网络安全防御人员开放。
Google 在 Argon 发布仅两周后,火速推出新旗舰 Gemini 4 Carbon。根据 B 站 UP 主的解读,这款模型在智能水平与编程能力上完成了对 Claude Opus 5.5 的正面反超,并直接把能力推向「全天候自主工程师」的形态。
智能与编程:Carbon 登顶全球第一
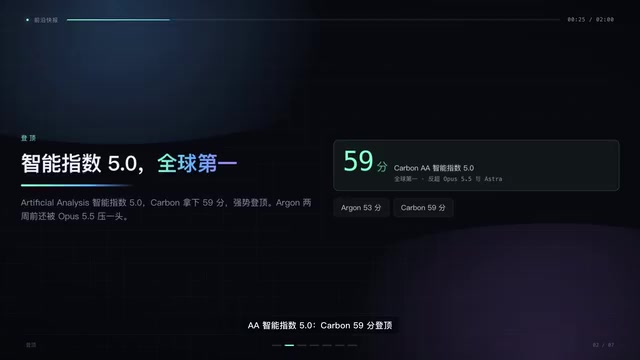
在刚更新的 Artificial Analysis 智能指数 5.00 上,Carbon 拿下 59 分,强势登顶全球第一。两周前 Argon 还被 Opus 5.5 压一头,短短半个月 Carbon 就精准补齐了最后一块拼图。
终端工程与超长上下文
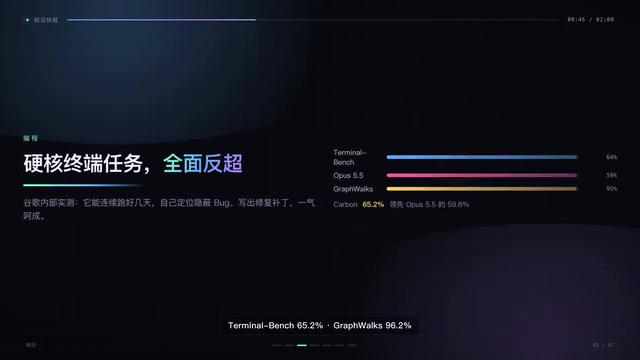
在 Terminal Bench 4.0 终端工程测试中,Carbon 拿到 65.2%,领先 Opus 5.5 的 59.6%。而在 Graphworks 超长上下文测试里,它更是达到 96.2%,把对手甩开 30 多分。这些数据意味着 Carbon 在处理长周期、多步骤的工程任务时具备明显优势。
Terminal Bench 是一类面向「终端/命令行环境」的智能体评测:模型需要在真实的 shell 环境中读写文件、安装依赖、运行测试、排查报错,最终让仓库达到指定状态,评分以任务完成率计。它考察的不只是代码生成,还包括工具调用、错误恢复和多步骤规划,因此被广泛用来衡量模型能否胜任真实工程任务。
所谓「超长上下文」测试,则是在输入规模远超常规(数十万到上百万 Token)时考察模型的信息检索与长程一致性。上下文窗口越长,模型越能一次性消化整个代码库或长篇文档,但有效利用长度与标称长度往往存在差距,这也是此类基准的价值所在。
内部实战:连续运行数天的自主修复
在谷歌内部的实战环境中,Carbon 能连续跑好几天,自己定位引入的 bug 并写出修复补丁,一气呵成。这种「全天候自主工程师」的形态,正是谷歌此次主推的能力方向。
Artificial Analysis 智能指数是一个由独立评测机构 Artificial Analysis 维护的综合基准,它把多个主流评测(推理、知识、编程、数学等)换算成统一量表后加权汇总,因此常被业界当作模型「通用智能」的横向对比口径。指数版本号(如 5.00)代表其评分方法和题库的一次大版本迭代,不同版本之间的分数不能直接混用。
需要留意的是,综合指数只是能力的压缩表达,单一维度上的强弱仍要看分项成绩,例如下文提到的终端工程和超长上下文测试。
价格策略:首发半价,成本压到对手四成
更狠的是价格。Carbon 首发延续半价策略:输入 2 美元、输出 10 美元每百万 Token,正好是 Opus 5.5 的一半;缓存命中的输入甚至低到 0.2 美元。算上折扣,实际账单还不到对手的 4 成,单任务成本也比 Opus 5.5 低约 2 成。
对于需要大规模调用模型的企业和开发者来说,这种定价直接把性价比拉到了新高度。
安全能力:差异化竞争的真正底牌
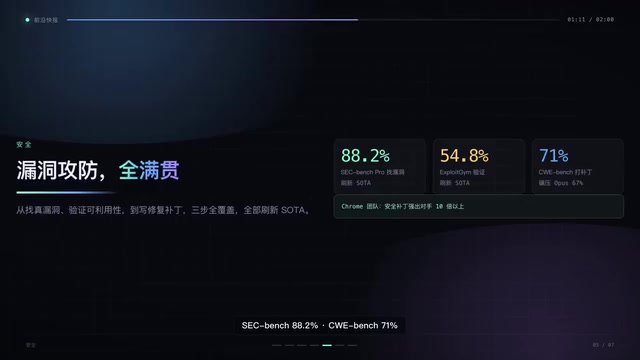
谷歌这次把差异点压在网络安全防御全周期上。找真漏洞的 SEC Bench Pro,Carbon 拿下 88.2% 刷新记录;验证可利用性的 Exploit Gym 为 54.8%,同样登顶;写修复补丁的 CWE Bench 为 71%,全面碾压 Opus 5.5 的 67%。Chrome 团队表示,它生成安全补丁比另一家顶级模型强出 10 倍以上。
对齐与安全:作弊率归零
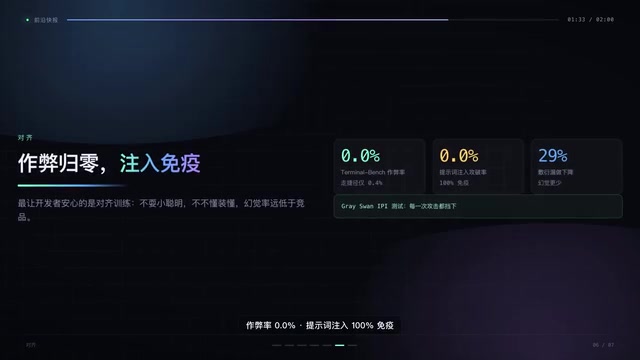
最让开发者安心的是对齐表现。在 Terminal Bench 4.0 上,Carbon 把成功作弊率压到 0.0%,连尝试走捷径的比例都只剩 0.4%。在 Grace1 间接提示词注入测试里,它交出 0.0% 攻击成功率的满分答卷,100% 免疫,换绝率也远低于竞品。
这意味着模型在高风险场景下的行为可控性大幅提升,对需要部署在安全敏感环境中的团队尤其重要。
间接提示词注入(indirect prompt injection)指攻击者把恶意指令隐藏在模型将要读取的外部内容中,例如网页、邮件、代码注释或文档,模型在处理这些内容时可能被诱导执行非预期操作。由于用户并未直接输入恶意指令,这类攻击对具备浏览、读写文件能力的智能体尤其危险,是当前智能体安全的核心威胁之一。
Grace1 这类测试通过构造带隐藏指令的任务环境,统计攻击成功率来衡量模型的抗注入能力。成功率 0.0% 意味着在该测试集上模型没有被诱导偏离原始任务,但这并不等于对所有变体攻击都绝对免疫。
发布节奏与后续:RSI 真的转起来了
皮柴哥(Sundar Pichai)表示,谷歌会周期性地发布模型。DeepMind 也透露,研究人员正与模型携手并进,用顶尖 AI 加速下一代 AI——RSI(递归自我改进)真的转起来了。
不过发布不等于上架。Carbon 会先向网络安全防御人员开放。至于它和 Opus 5.5 到底怎么选,UP 主表示下期再聊。
RSI(Recursive Self-Improvement,递归自我改进)指 AI 系统参与改进下一代 AI 的过程,例如辅助设计训练方案、编写评测代码、优化训练基础设施,从而使下一代模型更强、再加速下一轮迭代,形成正反馈循环。它被视为通往能力快速跃升的关键机制,同时也是 AI 安全讨论中的高风险议题,因为迭代速度一旦超过人类审核能力,可控性就会下降。
DeepMind 所说的「研究人员与模型携手并进」,更接近人机协作式的加速研发,而非完全自主的自我改写,二者在风险等级上差别很大。
核心要点
- Carbon 在 Artificial Analysis 智能指数 5.00 上以 59 分登顶全球第一,Terminal Bench 4.0 以 65.2% 领先 Opus 5.5 的 59.6%。
- Graphworks 超长上下文测试达 96.2%,把对手甩开 30 多分。
- 首发半价:输入 2 美元、输出 10 美元每百万 Token,实际账单不到对手 4 成。
- 安全防御能力全面碾压:SEC Bench Pro 88.2%、Exploit Gym 54.8%、CWE Bench 71%。
- 对齐表现出色:成功作弊率 0.0%,Grace1 提示词注入攻击成功率 0.0%。
(本文基于 B 站 UP 主的视频内容整理,数据以官方发布为准。)
相关推荐
OpenAI数学突破、Anthropic IPO与推理模型教程
OpenAI公布数学、计算机与物理三项成果,声称证明ETH不成立;Anthropic提交上市申请,披露营收与客户数据;SpaceX获400亿美元GPU融资;开源模型工具调用准确率问题与约束解码方案;8视频推理模型构建教程。

推理模型14个核心概念:从思维链到GRPO全面拆解
系统拆解推理模型14个核心概念:思维链、测试时计算、验证器、RLVR与GRPO、蒸馏与reward hacking,并给出思考token的成本控制规则,帮你判断何时值得为推理付费。

OpenAI称推翻ETH引热议,Meta豪赌AI基建
OpenAI宣布AI辅助发现,预印本声称推翻指数时间假设ETH,同时推出中端模型GPT-6.1 Tera。Cloudflare披露跨客户数据泄露复盘,Meta拟融资950亿美元投入AI基建。