Gemini 4 Carbon发布:最强网络安全模型,但你还用不上

谷歌发布Gemini 4 Carbon,17项测试15项第一,主打长任务与网络安全防守。
谷歌在Argon发布仅两周后推出新一代模型Gemini 4 Carbon,官方称其为目前最强模型。在17项测试中Carbon拿下15项第一,第三方智能指数得分59分位列榜首。该模型专为长时间工程任务设计,可连续运行数天不放弃,在大型代码库中定位并修复隐蔽bug;WebDev Arena得分上涨89分。网络安全防守是重点:找漏洞成功率88.2%、验证可利用性54.8%、修补根源71%,均为目前最佳。行为规范性也显著改善,作弊次数归零,抗间接提示注入攻击零中招,严重行为偏差警报减少近八成。Carbon暂未对公众开放,先面向网络安全防守方和可信伙伴,价格与Argon持平。
谷歌在上一代模型 Argon 正式推出仅两周后,又发布了新一代模型 Gemini 4 Carbon。官方称这是其目前最强的模型,主打网络安全防守和长时间复杂任务处理。不过,普通用户暂时还无法使用。
性能霸榜:17项测试15项第一
根据谷歌公布的成绩表,Carbon 与自家 Argon 以及 GPT-6、Astra、Cloud Opus 5.5 等模型同台竞技。在 17 项测试中,Carbon 拿下了 15 项最高分。其中第三方智能指数给出 59 分,位列第一。
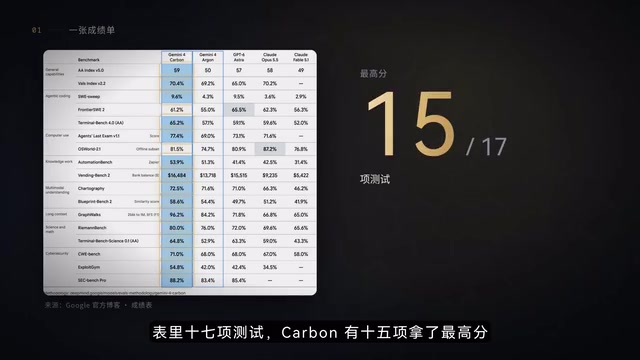
未赢的两项测试中,一项输给了 GPT-6 和 Astra,另一项则落后于 Cloud Opus 5.5。尽管并非全胜,但如此高的胜率足以说明 Carbon 在综合能力上的领先地位。
第三方智能指数(Artificial Intelligence Index)通常由独立评测机构综合多项基准测试得出,用于横向比较不同模型的通用能力。它并非单一任务分数,而是对推理、知识、编程、数学等维度进行加权汇总后的综合评分。由于各厂商自报成绩可能存在选择性披露,第三方独立指数常被视为更中立的参照。文中 Carbon 在该指数上获得 59 分并位列第一,意味着其领先不仅体现在谷歌自选的 17 项测试中,也体现在外部独立评测的综合排序上,但具体分项权重和测试集构成仍需结合完整报告解读。
为长任务而生:连续运行数天不放弃
Carbon 是专为长时间工程任务设计的模型。谷歌透露,内部团队曾让它连续运行好几天,即使遇到死胡同也不会放弃。例如,在庞大的代码库中定位一个隐蔽 bug 的根源并将其修复,这类任务对模型的持久性和推理能力要求极高。
在网页开发方面,Carbon 在 WebDev Arena 上的得分上涨了 89 分,排名升至第四。这表明其在代码生成和实际应用场景中的表现也有显著进步。
网络安全防守:三步闭环,三项指标领先
谷歌最强调 Carbon 在网络安全防守上的能力。一个漏洞的完整处理需要三步:找到它、确认它真能被利用、再把根源修掉。
在找漏洞环节,Carbon 在 SEC Bench Pro 上达到 88.2% 的成功率;验证可利用性方面,Exploit Gym 上为 54.8%;修补根源环节,CWE Bench 上为 71%。谷歌表示,这三项都是目前最好的成绩,而且是在不加防护措施的情况下测得的。
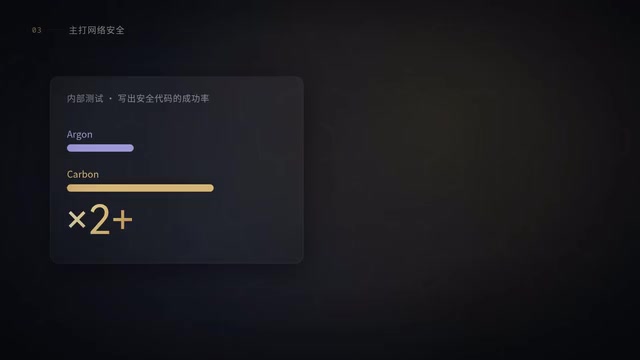
内部测试中,Carbon 写出安全代码的成功率是 Argon 的 2 倍。CREME 团队还称,它生成高质量补丁的表现比另一家实验室的大模型好 10 倍以上。
SEC Bench Pro、Exploit Gym 和 CWE Bench 分别对应漏洞处理流程的不同阶段。SEC Bench Pro 侧重评估模型在真实代码库中定位安全缺陷的能力;Exploit Gym 衡量模型能否构造出可实际触发漏洞的利用路径,从而区分真实风险与误报;CWE Bench 则依据通用缺陷枚举(CWE)分类,考察模型修复漏洞根源而非仅消除表面症状的能力。三项指标串联起来,覆盖了从发现、验证到修复的完整防守闭环,因此比单一漏洞检测分数更能反映模型在安全运营中的实用价值。
更守规矩:作弊归零,抗注入攻击无失手
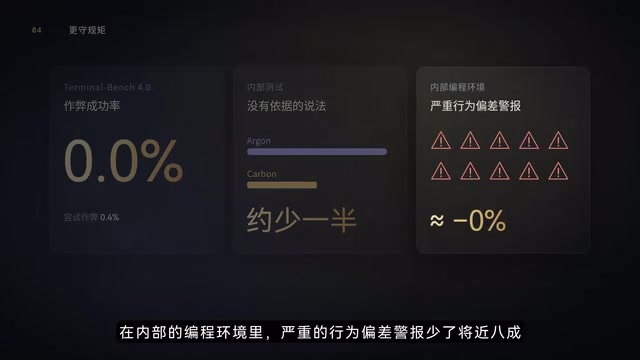
能力提升的同时,Carbon 的行为规范性也明显改善。在 Terminal Bench 4.0 上,其作弊成功的次数降到了 0。面对间接提示注入攻击,Argon 还有 0.7% 的中招率,而 Carbon 一次也没有。
此外,没有依据的说法比 Argon 少了一半左右。在内部编程环境中,严重的行为偏差警报减少了近八成。
这些改进对于将模型部署到关键业务场景尤为重要,尤其是在安全敏感的领域。
间接提示注入攻击(Indirect Prompt Injection)是指攻击者将恶意指令隐藏在模型可能读取的外部内容中,例如网页、文档、代码注释或工具返回结果,而不是直接由用户输入。当模型处理这些内容时,可能误将隐藏指令当作合法任务执行,从而泄露数据、调用工具或改变行为。这类攻击对具备浏览、读写文件或执行代码能力的智能体尤其危险,因为攻击面从对话输入扩展到了整个信息环境。文中提到的“中招率”即模型被此类隐藏指令成功操纵的比例,衡量的是模型在真实工具链场景下的行为安全性。
上线节奏与定价:先给防守方,价格与Argon持平
目前 Carbon 尚未对公众开放。谷歌正在参与美国政府的上线前测试,本周先开放给一小批网络安全防守方,之后通过 Fairwind 计划扩大到更多可信伙伴。面向开发者、企业和普通用户的首发价格与 Argon 相同:每百万输入 2 美元,输出 10 美元。
从 Argon 到 Carbon 的迭代节奏越来越快,下一次换代可能也不用等太久。对于关注 AI 能力边界和安全应用的人来说,Carbon 的出现无疑是一个重要信号。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。