Gemini 4 Carbon实测:进步明显,但还不是编程首选
Gemini 4 Carbon 幻觉率减半但代码审查仍不可靠,网络安全表现亮眼,速度与成本存陷阱。
一位获得早期访问权的科技博主对 Gemini 4 Carbon 进行了深度评测,结论充满矛盾。Carbon 在代码分析中的虚假声明率从 Argon 的 36% 降至 18%,但仍远高于主流模型,代码审查场景不可用。实测速度远慢于宣传,低推理档位平均耗时 22 分钟,而 Opus 仅约 3 分钟;定价为 introductory price,12 月 1 日后翻倍,且缓存机制不透明导致实际成本更高。然而,Carbon 在网络安全场景表现突出:提示注入成功率 0%,作弊率大幅下降,并在真实漏洞修复中提出高质量方案,获得 Opus 5.5 和 Muse 的 9 分评价。DeepMind 团队对开发者反馈响应积极,快速修复了 ACP 绑定问题。博主最终认为,Carbon 相比前代是巨大进步,但并非日常编程默认选择,锁定 Gemini 生态的用户值得升级。
从失望到意外:一次充满反转的评测
Google 的 Gemini 4 Carbon 终于向开发者、企业和消费者开放。一位获得早期访问权的 YouTube 科技博主在深度使用后,给出了一个充满矛盾的结论:它比前代 Argon 进步巨大,但离"好用"仍有距离。这位博主原本准备了一期"吐槽向"视频,却在最后关头被一个意外的表现打动——这期评测因此变成了一场关于"模型能力边界"的诚实记录。
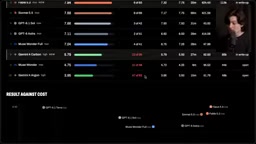
据该博主透露,他同时参考了 Artificial Analysis 等第三方评测数据。Gemini 4 Carbon 在发布时的综合得分曾短暂领先,但随后被其他新模型超越。这种"纸面排名"与真实体验之间的落差,构成了整期评测的核心张力。
幻觉率减半,但仍不够可靠
博主最关注的指标是代码分析中的"虚假声明率"。在他的 Rust 代码库架构评审测试中,Argon 提出了 36 条声明,其中 24 条为假;Carbon 提出了 79 条声明,虚假声明为 23 条。
跨所有评测,虚假声明比例从 Argon 的 36% 降至 Carbon 的 18%。
这一数据与 DeepMind 团队向他透露的"约两倍改善"吻合。但博主指出,18% 的幻觉率仍远高于其他主流模型(多数在 0 到 1 条之间,少数为 3 到 4 条)。它会编造数据库表的列名、不存在的行号、以及与实际架构不符的描述。对于代码审查和代码库分析这类任务,博主明确表示"绝对不要用"。
虚假声明率(False Claim Rate)是评估大语言模型在代码分析任务中可靠性的关键指标,指模型在回答或评审中提出的、与事实或代码库实际情况不符的声明所占比例。该指标不同于通用幻觉率,它聚焦于模型是否编造了具体的代码结构、变量名、行号或架构描述。在代码审查场景中,虚假声明率过高意味着开发者需要花费大量时间验证模型输出的真实性,从而抵消了自动化带来的效率提升。业界通常通过人工标注或自动化比对来统计这一比例,并以此判断模型是否适合直接用于生产环境的代码分析。
速度与成本:纸面参数之外的真实代价
Carbon 被宣传为"快速模型",但博主的实测给出了相反结论。在 Artificial Analysis 的测试中,Carbon 在低推理档位的平均任务耗时为 22 分钟,高档位为 27 分钟;作为对比,Opus 的低档位仅需约 3 分钟。博主强调,token 生成速度(TPS)不等于实际可用速度,首字延迟和往返时间才是决定体验的关键。
价格方面同样存在"陷阱"。Carbon 的定价为每百万输入 token 2 美元、输出 10 美元,但这是" introductory price"——截至 12 月 1 日,价格将翻倍至输入 4 美元、输出 20 美元。博主还发现 Gemini API 的缓存机制不够透明:在 5 秒窗口内有 20% 概率缓存未命中,30 秒窗口为 34%,120 秒窗口更高。缓存未命中会导致请求量最多增加 50%,实际成本远超标价。
首字延迟(Time to First Token, TTFT)和往返时间(Round-Trip Time, RTT)是衡量模型实际交互体验的核心指标。TTFT 指从发送请求到收到第一个输出 token 的时间,直接影响用户感知的响应速度;RTT 则涵盖请求在网络中往返及模型处理的总耗时。与 token 生成速度(TPS)不同,这两个指标更贴近真实使用场景,尤其是在多轮对话或需要快速迭代的编程任务中。高 TTFT 和 RTT 会导致交互卡顿,即使 TPS 很高,用户体验依然不佳。因此,评测模型速度时需综合考量这些端到端指标。
网络安全:被低估的真正亮点
评测中段,博主承认自己"睡过了"网络安全这个板块。Google 在发布时强调 Carbon 在网络安全能力上的前沿表现,并已通过 Fair Wind 计划向安全防御者开放。
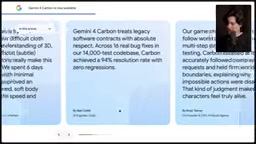
据 Google 披露,Carbon 在 Project Fortify 中相较 Argon 取得了 25% 的相对提升,并在流行开源项目中发现了两个严重程度堪比 PHP 远程代码执行漏洞的缺陷。在提示注入测试中,Carbon 取得了 0% 的注入成功率;在评估中作弊的频率也从 Argon 的 4% 大幅下降。
博主最初对这些宣传持怀疑态度,但一次真实的安全报告处理改变了他的看法。一位独立开发者通过 Anthropic 的安全计划发现 T3 Code 存在两个安全问题。博主先让其他模型处理,结果要么拒绝、要么给出不切实际的方案(例如要求用户手动在另一台机器上生成六位验证码)。而 Carbon 在理解问题后,直接提出了"硬隔离已知机器流与原始 URL 流"的方案,并额外发现了两个报告未提及的衍生问题。
最终,该修复方案获得了 Opus 5.5 和 Muse 的 9 分评价。博主坦言:"我没想到处理这些报告的最佳体验,来自这个模型。"
提示注入(Prompt Injection)是 LLM 安全领域的一类攻击方式,攻击者通过在输入中嵌入恶意指令,诱导模型偏离原始任务或泄露敏感信息。在网络安全评估中,提示注入成功率是衡量模型鲁棒性的重要指标,0% 的成功率意味着模型能有效识别并拒绝此类攻击。Project Fortify 是 Google 发起的一项计划,旨在利用 AI 发现开源软件中的安全漏洞,并通过与安全社区合作推动修复。Carbon 在该计划中的表现,反映了其在真实漏洞挖掘和修复建议方面的能力。
工程协作与生态:DeepMind 的响应速度值得肯定
博主通过 T3 Code 的 ACP 绑定使用 Gemini。早期版本中,ACP 绑定存在数据传输问题,导致模型无法获得行号等关键上下文,这也是部分幻觉的来源。
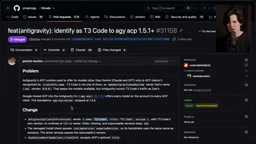
DeepMind 团队在收到反馈后审计了 ACP 实现并完成了修复,还为 T3 Code 添加了特殊标识以提供更优体验。博主对此给予高度评价:"如果按实验室修复问题的意愿排名,我会把 DeepMind 排第一。"不过他也指出,Gemini CLI 已不再开源,这与早期策略形成对比。
ACP 绑定(Agent Communication Protocol Binding)是 Gemini 与外部工具(如 T3 Code)集成的一种协议实现,用于在模型与开发环境之间传递上下文信息(如行号、文件结构等)。当 ACP 绑定存在数据传输问题时,模型无法获取完整的上下文,导致生成内容与实际情况脱节,进而加剧幻觉。DeepMind 团队对此类集成问题的快速修复,体现了其对开发者生态的重视,也影响了模型在实际工程场景中的可用性。
该不该用?分场景的结论
不要用 Carbon 的场景:
- 代码审查与代码库分析(幻觉率仍偏高)
- 3D 内容生成(实测效果明显落后于预期)
- 需要快速响应的交互式编程
- 大型代码库理解(博主认为它难以驾驭规模较大的项目)
可以考虑的场景:
- 网络安全事件响应与漏洞修复方案设计
- 在 Gemini 生态内需要升级的现有用户
- 愿意" babysit"模型、逐步引导的探索性任务
博主最终的判断是:Carbon 相比 Argon 是"巨大的一步",日常使用体验明显更顺畅,也能更好地保持任务焦点。但它仍不是他日常编程的默认选择——Opus 在性价比、响应速度和工程质量上依然领先。
"我不会说 Google 这次'烹饪'成功了,但它确实没那么糟糕了。"博主在结尾写道。他正在考虑将 Carbon 从自己评测体系中的" Jester"等级中移出,以观察其长期表现。对于锁定在 Gemini 生态的用户,这是一次值得的升级;对于有选择权的开发者,它暂时还不是第一选择。
相关推荐
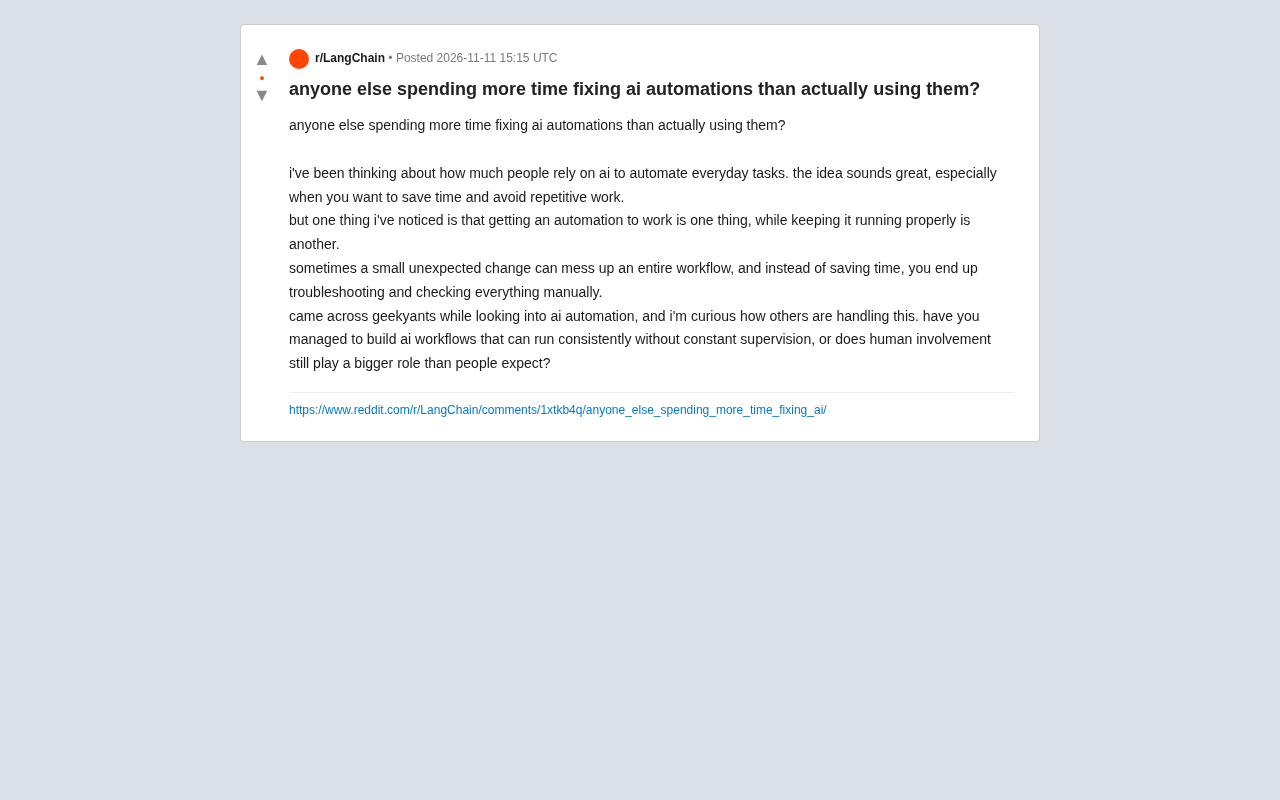
AI自动化越用越累?维护成本被低估了
Reddit热议:AI自动化搭建容易维护难。本文分析工作流脆弱性的来源、维护成本的三个层面,以及人机协作与期望管理的务实思路。
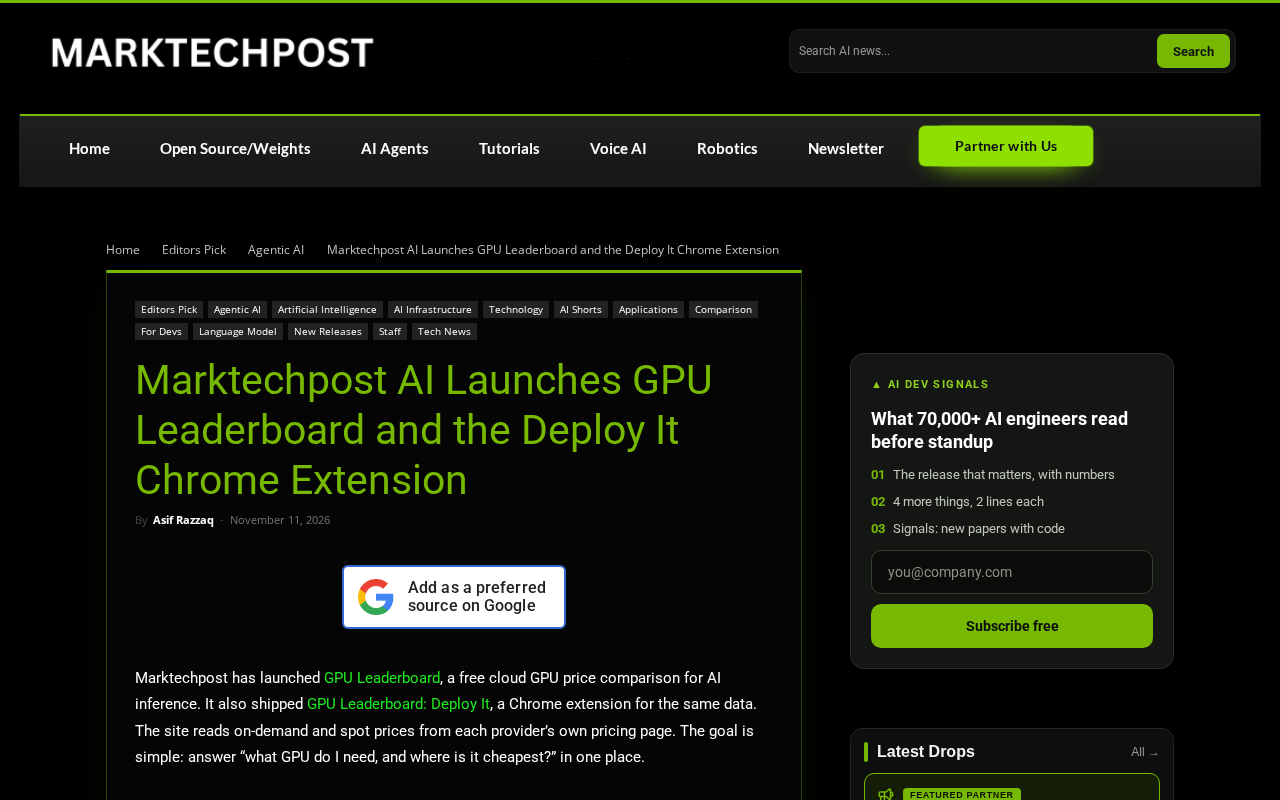
Marktechpost推出GPU排行榜与部署工具扩展
Marktechpost推出GPU Leaderboard与Deploy It Chrome扩展,前者聚合GPU在AI负载下的性能对比,后者尝试在浏览器内简化模型部署流程。本文梳理两项工具的功能定位、信息缺口与对开发者的实际参考价值。
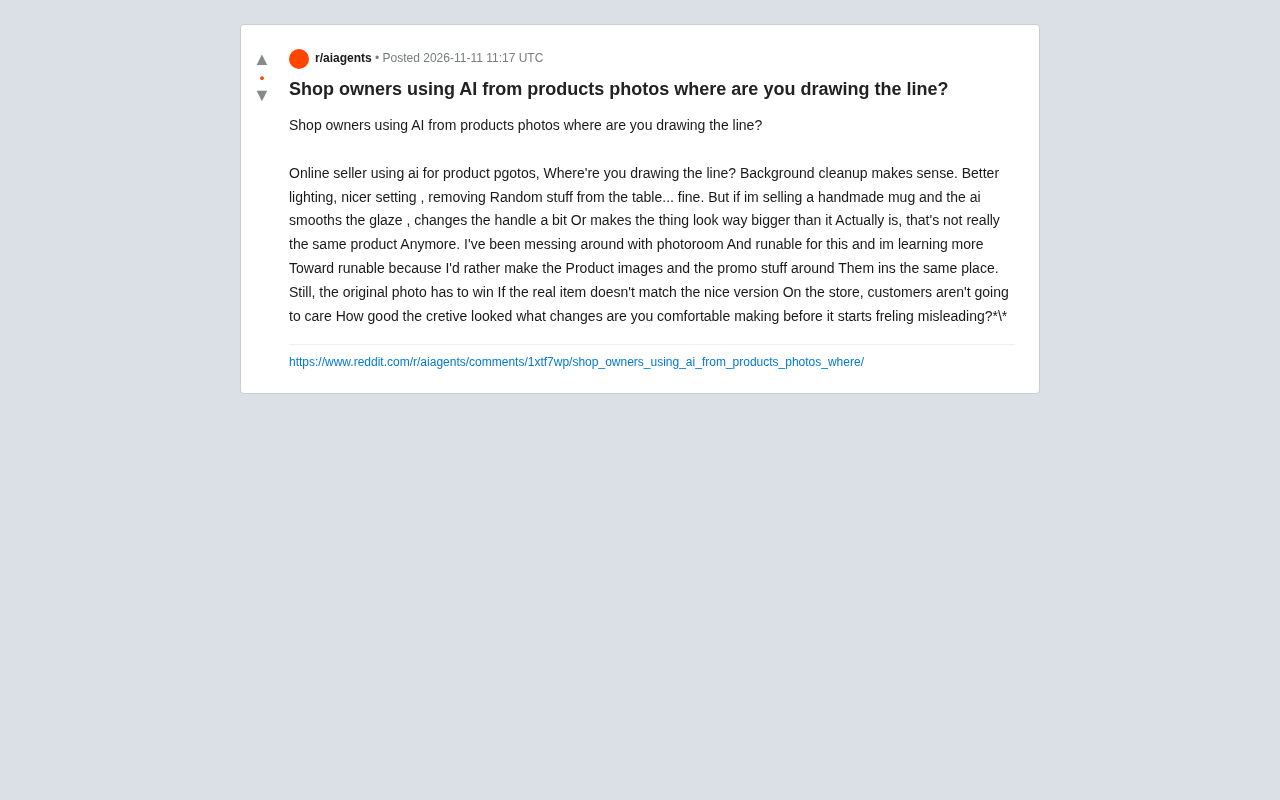
AI修图边界在哪?电商卖家如何避免产品照误导消费者
电商卖家如何划定AI产品修图的边界?清理背景、优化光线可以接受,但改变产品形状、纹理和尺寸就可能构成误导。本文梳理Reddit卖家的实战经验与工具选择建议。