Marktechpost推出GPU排行榜与部署工具扩展
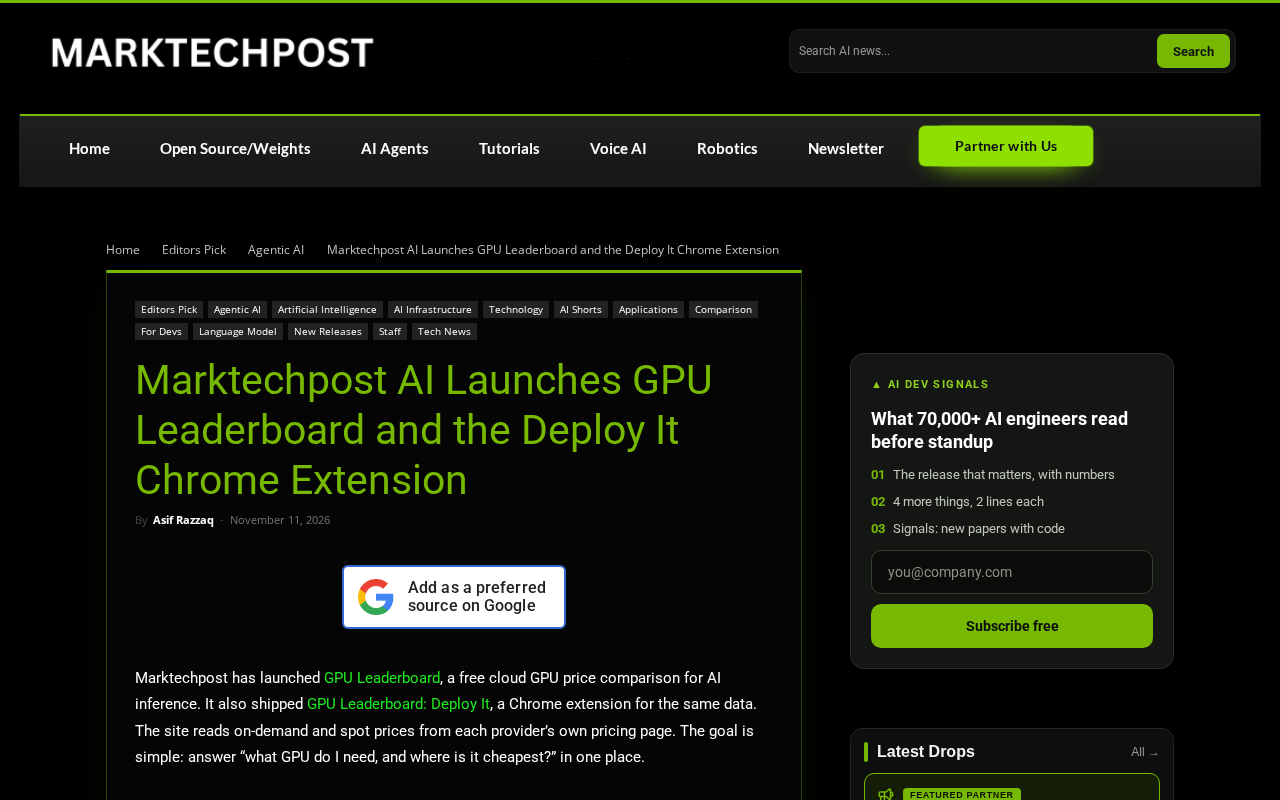
Marktechpost推出GPU排行榜与Deploy It扩展,向工具服务延伸。
科技媒体Marktechpost上线两款面向AI开发者的工具:GPU Leaderboard聚合不同GPU在AI工作负载下的性能数据,旨在降低硬件选型的调研成本;Deploy It是一款Chrome扩展,定位为浏览器内的轻量部署入口。文章指出,这两项发布反映技术媒体从内容向服务化延伸的趋势。但官方尚未披露排行榜的测试方法、覆盖型号与更新频率,也未说明扩展支持的部署目标、账号体系及免费付费边界,实用价值有待后续文档验证。开发者可将排行榜作为调研起点,但需与官方规格和独立基准交叉比对;扩展适合尝鲜,生产部署前应确认权限范围与数据安全策略。
科技媒体Marktechpost近期上线了两款面向AI开发者的工具:一个GPU性能排行榜,以及名为「Deploy It」的Chrome浏览器扩展。这两项发布指向同一个需求——在硬件选型和模型部署环节,开发者需要更透明的参考信息和更顺手的操作入口。
GPU排行榜:给硬件选型一个参考坐标
据Marktechpost官方公告,GPU Leaderboard旨在集中呈现不同GPU在AI工作负载下的表现数据。对于需要采购算力或搭建训练/推理环境的团队来说,这类横向对比信息长期分散在厂商白皮书、第三方评测和社区讨论中,缺乏统一口径。排行榜的价值不在于给出唯一答案,而在于把分散的测试结果聚合到同一视图下,降低前期调研成本。
目前公开信息尚未披露排行榜的具体测试方法、覆盖的GPU型号范围以及数据更新频率。这些细节决定了榜单的实用程度——测试基准是否贴近真实训练场景、是否区分推理与训练负载、是否纳入性价比维度,都会影响开发者的采信意愿。如果后续能补充透明的方法论说明,这个工具才可能从「信息聚合页」升级为「决策依据」。
基准测试(Benchmark)与测试口径是评估GPU性能时的核心概念。业界常见的AI基准包括MLPerf(覆盖训练与推理的标准化套件)、各类吞吐量/延迟测试,以及针对特定模型(如ResNet、BERT、LLM推理)的专项评测。不同榜单的差异往往不在硬件本身,而在于测试口径:批大小(batch size)、精度(FP32/FP16/INT8)、是否启用张量核心、功耗上限与散热条件都会显著改变结果。此外,训练负载通常关注吞吐量与多卡扩展效率,推理负载更看重首token延迟与单位成本吞吐。因此,看到任何GPU排行榜时,应先确认其标注的基准、精度与场景,再判断数据能否迁移到自己的实际工作负载。
Deploy It扩展:把部署动作收进浏览器
另一项发布是Chrome扩展「Deploy It」。从命名和形态判断,它的定位是在浏览器内简化模型或应用的部署流程。传统上,从本地原型到线上服务需要切换多个平台、配置环境、处理凭证,扩展类工具的思路是把这些步骤压缩到当前页面内完成。
Marktechpost并未在公告中详细说明该扩展支持哪些部署目标(云平台、容器服务或边缘节点)、是否需要绑定账号体系、以及免费与付费功能的边界。这些信息缺失使得外界难以评估它的实际覆盖范围。可以确定的是,浏览器扩展这种分发形式门槛低、安装快,适合作为部署流程的轻量入口,但复杂配置场景仍需回到专业控制台处理。
浏览器扩展的权限模型是评估此类工具安全性的关键。Chrome扩展通过manifest声明所需权限,如读取和修改用户在所有网站上的数据、访问剪贴板、调用网络请求等;权限越宽,潜在风险越大。部署类扩展若需要访问云平台控制台或持有API凭证,通常涉及OAuth授权或令牌存储,用户应确认凭证保存在本地还是经过第三方服务器。此外,浏览器环境天然不适合处理长时间运行的任务和复杂配置,扩展更适合充当触发器和向导,真正的构建、编排与回滚仍需依赖CI/CD流水线或云平台控制台。
媒体做工具:内容平台的延伸尝试
Marktechpost长期以AI论文解读和技术资讯为主,此次同时推出数据型工具(排行榜)和操作型工具(扩展),反映出技术媒体向「服务化」延伸的趋势。对读者而言,资讯停留于阅读,工具则带来留存和复用;对平台而言,工具能积累使用行为数据,反哺内容选题。
这一路径也伴随挑战。排行榜需要持续维护测试环境,扩展需要跟进各部署平台的接口变更,两者都是长期投入。若更新滞后,工具的公信力会快速流失。从目前公开的信息量来看,两款产品更像是早期版本,功能边界和运营节奏仍有待观察。
开发者可以关注什么
短期内,GPU排行榜可作为硬件调研的起点,但建议与厂商官方规格、独立基准测试交叉比对后再做采购决策。Deploy It扩展适合尝鲜体验,实际用于生产部署前应确认其权限范围与数据安全策略。对关注AI工程化工具链的读者,这两个发布值得加入观察列表,等待后续的方法论文档和版本更新说明。
原文发布信息可参见Marktechpost官网公告。
背景补充
技术媒体的服务化延伸在行业内已有先例。Hugging Face从模型社区扩展出推理端点与Spaces,Papers with Code以论文—代码—榜单的聚合形成研究基础设施,部分媒体也通过排行榜、数据集索引或API目录增强用户粘性。这类转型的共性在于:内容积累带来流量,工具沉淀使用行为,二者形成数据飞轮。但工具业务对工程维护、版本迭代与运营投入的要求远高于内容生产,能否持续更新方法论与兼容性,往往决定其是成为长期基础设施,还是短期的品牌曝光动作。
相关推荐
Gemini 4 Carbon实测:进步明显,但还不是编程首选
深度评测Gemini 4 Carbon:幻觉率从36%降至18%,网络安全能力成为最大亮点,但速度慢、缓存机制不透明、代码分析仍不可靠。多场景实测揭示这款模型真实的适用边界。
AI自动化越用越累?维护成本被低估了
Reddit热议:AI自动化搭建容易维护难。本文分析工作流脆弱性的来源、维护成本的三个层面,以及人机协作与期望管理的务实思路。
AI修图边界在哪?电商卖家如何避免产品照误导消费者
电商卖家如何划定AI产品修图的边界?清理背景、优化光线可以接受,但改变产品形状、纹理和尺寸就可能构成误导。本文梳理Reddit卖家的实战经验与工具选择建议。