Gemini 4 Hydrogen 代理编程实测:半价挑战GPT-5.4
Gemini 4 Hydrogen 输出价格减半、基准接近顶尖,但代理工具类任务偏弱,硬任务需实测验证。
Gemini 4 Hydrogen 以 GPT-5.4 一半的输出价格(每百万 token 7.50 美元 vs 15 美元)和约低 47% 的混合费率,在 Artificial Analysis 智能指数上得分 51,接近顶尖模型。它在 Terminal Bench 4.1 上以 57% 通过率远超 Gemini 3.8 Flash 的 18.2%,但代理和工具类别得分仅 62,落后于 Claude Sonnet 5.5 的 63.9%。速度方面,官方宣称快 2.5 倍,第三方实测每任务时间差距仅约 10%。实际任务中,Hydrogen 能主动发现隐蔽的货币转换 bug,VibeCodeBench 得分 87.8%,但超高设置下每任务成本约 3.16 美元,且完整索引运行可能消耗巨额 token。与 Carbon 协作可减少 24% 配额使用并提升 19% 速度,但单独使用效果需独立验证。
Google 新推出的 Gemini 4 Hydrogen 以 GPT-5.4 一半的输出价格,在独立排行榜上几乎打平。这款模型在代理编程任务中表现如何?本文基于多源实测数据,拆解其性价比与代理能力边界。
价格优势:输出成本减半,混合费率显著降低
Gemini 4 Hydrogen 的定价策略是其最大卖点。每百万输出 token 收费 7.50 美元,而 OpenAI 的 GPT-5.4 为 15 美元;输入 token 方面,Hydrogen 为 1.50 美元,GPT-5.4 为 2.50 美元,输入折扣达 40%。按输入输出 3:1 的混合比例计算,混合费率约为每百万 token 3 美元,而 GPT-5.4 约为 5.63 美元。这意味着,如果两个代理使用相同数量和比例的 token,原本 100 美元的 token 账单在 Hydrogen 上只需约 53 美元。
Google 在 Hydrogen 的百万 token 上下文窗口上采用相同费率,该窗口大约能容纳九本小说的文本量。但需要注意的是,输入、思考过程和输出共享这一空间,因此如果加载超大代码库,必须为模型留出足够的工作空间。
基准测试:整体接近顶尖,代理工具项成短板
在 Artificial Analysis 智能指数上,Hydrogen 默认高设置下得分 51,与 Gemini 4 Argon 的 50 分接近;调至超高设置后可达 54。Google 报告称,Hydrogen 在 Terminal Bench 4.1 上以 57% 的通过率远超 Gemini 3.8 Flash 的 18.2%,后者仅为其三分之一左右。
然而,在同一榜单上,Hydrogen 的弱项恰恰是代理和工具类别,得分 62,低于推理(70)和编码(69)。这意味着它可能擅长编写补丁,但在围绕补丁的多步骤流程中容易遇到困难。
据 Google 模型卡显示,Claude Sonnet 5.5 在相同的 TerminalBench 4.1 测试中得分 63.9%,领先 Hydrogen 6.9 个百分点。Sonnet 还在 OS World 桌面应用任务测试中领先,而 Hydrogen 在 SWE sweep 行以 13.5% 对 3.1% 胜出。选择哪个模型,取决于你手头的工作更接近哪类任务。
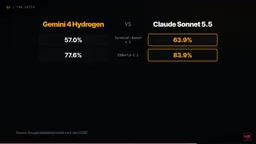
Terminal Bench 是一个用于评估大语言模型在真实终端环境中执行命令行任务能力的基准测试。它模拟开发者日常操作,如文件导航、进程管理、软件安装与调试等,要求模型在多步骤、有状态的环境中正确执行命令并达成目标。该基准强调代理能力(agentic capability),即模型能否在动态反馈中调整策略,而非仅生成单步代码。Terminal Bench 4.1 是其较新版本,通过率反映模型独立完成终端任务的可靠性。对于代理编程场景,该分数是衡量模型能否自主运维、调试和部署的重要参考,但需注意其侧重命令行交互,不完全覆盖 IDE 内编码或复杂工具链协作。
OS World 是评估 AI 代理在桌面操作系统环境中执行跨应用任务的基准测试。它要求模型通过图形界面或系统 API 完成如文件整理、邮件发送、表格编辑等复合操作,考验模型对多窗口、多应用工作流的理解与规划能力。与 Terminal Bench 侧重命令行不同,OS World 更贴近普通用户的桌面自动化场景,能反映模型在真实办公环境中的代理水平。Sonnet 在该测试中领先 Hydrogen,说明其在跨应用任务编排上可能更具优势。对于需要桌面自动化的代理项目,OS World 分数比纯编码基准更具参考价值,但需注意测试环境与生产环境的差异。
速度与思考成本:官方宣称 vs 第三方实测
Google 声称 Hydrogen 在默认高设置下完成任务的速度是 Gemini 3.8 Flash 的 2.5 倍。但模型路由厂商 Orca Router 基于 Artificial Analysis 数据的对比显示,每任务时间差距约为 10%。两个来源测量的是不同工作负载,如果你计划按“快一倍”来安排预算,外部对比数据建议你先自行测试验证。
调高思考等级会带来显著的时间成本。在高设置下,Artificial Analysis 测得输出速度为每秒 168 token,首个回答 token 出现前需等待 17.6 秒;在超高设置下,流式速度提升至每秒 174 token,但首个回答需要等待 43.3 秒。文本一旦开始输出确实更快,但你为此多等了一倍以上的时间。
实际任务表现:能发现隐蔽 bug,但成本需精细管理
一位实操评测者给 Hydrogen 一个宽泛目标,模型自行发现了涉及日元和韩元的货币转换 bug,偏差达 100 倍。评测者并未直接指向转换逻辑,Hydrogen 在宽泛目标下主动定位了问题,这种在代码上线前发现隐患的能力,比代码生成速度更有价值。Google 的演示还展示了一次性生成可探索的 3D 岛屿和带 WebGL 着色器的电商网站,用户可以直接上手操作并判断原型是否值得继续迭代。
在 VibeCodeBench 上,Hydrogen 在超高设置下得分 87.8%,在 128 个模型中排名第 13。如果你的任务清单包含交互式原型,这个成绩值得认真对待;但如果涉及修改老旧代码并在测试套件中追踪失败,则需要专门验证。
成本方面,Artificial Analysis 报告 Hydrogen 在超高设置下完整索引运行消耗 3.04 亿输出 token,按公布费率计算仅这些 token 就花费 2280 美元,在追踪的 79 个模型中接近最冗长的末端。不过,平均每任务成本在高设置下约为 1.87 美元,超高设置下约为 3.16 美元。建议从高设置起步,只在能明确看到收益的任务上升级到超高。
VibeCodeBench 是一个聚焦于“氛围编程”(vibe coding)能力的基准测试,评估模型根据自然语言描述生成可交互原型、小型应用或可视化页面的能力。它强调快速将想法转化为可运行、可体验的代码,而非严格遵循工程规范。测试任务通常包括生成带交互的网页、简单游戏或数据可视化,评分兼顾功能完整性与用户体验。Hydrogen 在超高设置下得分 87.8%,排名第 13(共 128 个模型),表明其在原型生成类任务上具备较强竞争力。但该基准不覆盖大型代码库修改、测试套件调试等硬核工程任务,因此高分不能直接等同于代理编程的全面能力。
多模型协作与安全考量
Google Anti-Gravity 编排器展示了协作潜力:Carbon 负责规划,Hydrogen 负责编辑代码和运行测试,需要更多规划时可交回 Carbon。据 Anti-Gravity 团队称,这种设置接近 Carbon 的成功率,同时配额使用减少 24%,运行速度提升 19%。原本覆盖 100 个任务的配额,大约可覆盖 132 个同类任务。但这一结果属于两个模型协作的成果,单独使用 Hydrogen 时仍需独立衡量节省效果。
安全方面,Google 报告其内部评估中过度干预减少了最高 81%,但模型卡也显示,与 Gemini 3.8 Flash 相比,不合理拒绝率上升了 5.57 个百分点,尤其是在组合不同类型输入的提示上。完整安全报告在模型发布时仍待公布。
模型卡(Model Card)是模型发布方提供的标准化文档,用于披露模型的预期用途、性能基准、局限性、伦理考量及安全评估结果。它类似于产品说明书,帮助开发者判断模型是否适合特定场景。本文引用的 Google 模型卡包含 Terminal Bench 4.1、OS World 等测试分数,以及过度干预和不合理拒绝率等安全指标。模型卡中的数据通常由发布方自行评测,可能与第三方独立测试存在差异,因此建议结合外部基准交叉验证。对于企业选型,模型卡是了解模型能力边界与风险的重要起点,但不应作为唯一决策依据。
结论:性价比真实,但硬任务仍需验证
Hydrogen 的输出价格优势真实存在,基准测试整体接近顶尖模型,但在代理和工具类任务上落后于 Claude Sonnet 5.5。建议从可复现的 bug 排查、可试用的原型和带测试的编辑任务入手,给两个代理相同的任务单,对比尝试次数、测试通过率和需要手动修复的比例。输出价格给了 Hydrogen 一个领先起跑线,但最终完成的任务质量才决定你能保留多少优势。
本文综合 Google 模型卡、Artificial Analysis 数据、Orca Router 对比、Mind Studio 评测及 Google Anti-Gravity 团队信息,多源交叉验证关键结论。
相关推荐
在终端里看片:Codex多智能体打造SSH流媒体服务
创作者用Codex多智能体工作流在终端搭建SSH流媒体服务,包含规划、云端异步开发、AI绘制电影场景和同步直播频道,展示AI编程工具如何快速实现个人创意。
阿拉斯加新州长:一位维基百科资深编辑
阿拉斯加当选州长 Jonathan Kreiss-Tomkins 拥有超过 13,000 次维基百科编辑记录。本文分析这一身份背后的信息素养与协作能力信号,以及对技术从业者的启示。
AI卖脸:微短剧新趋势还是好莱坞陷阱?
演员将面部授权给微短剧初创公司,用AI数字分身出演内容。这一模式在中国已流行,专家担忧其进入好莱坞后带来控制权流失、议价能力稀释等长期风险。