Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet

实测显示Gemini 4 Hydrogen完成日常CRUD任务仅耗1%周配额,远低于Anthropic模型的7%。
一位巴西开发者用同一个笔记删除CRUD任务对比Gemini 4 Hydrogen与Anthropic Sonnet。两者均正确实现权限控制、删除按钮和确认框,并通过全部测试与格式化。Sonnet速度更快,但Gemini的handoff展示和UI对齐更优。最关键的差异在配额:Gemini仅消耗5小时配额的2%、周配额的1%,而Anthropic模型消耗15%和7%。开发者认为,对于定义清晰的日常任务,昂贵模型并非必需,模型具备自我验证能力才是更实际的效率杠杆。
在AI编程助手竞争白热化的当下,一个关键问题浮出水面:日常开发任务到底需要多强的模型?一位巴西开发者通过实际测试给出了有趣答案——用Google的Gemini 4 Hydrogen和Anthropic的Sonnet分别完成同一个CRUD任务,结果发现前者不仅表现相当,而且配额消耗极低。
测试设计:一个典型的删除功能
测试任务非常具体:实现笔记删除功能,仅允许作者删除自己的笔记,在个人或公司页面显示删除按钮并弹出确认框。API行为明确——204表示成功,403表示无权删除他人笔记,404表示笔记不存在。
据该YouTube频道的分析,这种“well-scoped”任务是日常开发中最常见的类型:前后端联动、明确的接口契约、基本的测试验证。开发者刻意选择这类任务,因为“它没有太多发挥智能的空间”,正好用来观察模型在真实工作流中的表现。
测试环境值得注意:Gemini 4运行在“high”推理级别,Sonnet同样使用“high”设置。两个模型在各自的终端中同时执行相同的提示词。
CRUD 是 Create(创建)、Read(读取)、Update(更新)、Delete(删除)的缩写,指大多数业务应用中最基础的数据操作集合。CRUD 任务通常具有明确的输入输出契约,例如本例中删除笔记的 API 行为被严格定义为 204(成功)、403(无权删除他人笔记)、404(笔记不存在)。这类任务之所以适合用来对比模型,是因为它们边界清晰、验证路径标准,模型很难在需求理解上产生发散,从而更能暴露其在代码组织、测试执行和工具使用上的真实差异。
执行过程:速度与细节的微妙差异
据该YouTube频道的分析,Sonnet“非常快”,仅用一分半钟就完成仓库分析和代码修改,直接进入测试和格式化环节。Gemini 4 Hydrogen则多花了两分钟左右,但它的“handoff”展示明显更友好——清晰地显示了正在修改的位置,让开发者对进度一目了然。
从修改范围看,Gemini改动了更多文件,开发者在视频中强调:“这非常关键”。他提到自己在代理编程课程中反复教授的要点:如果模型具备自我验证能力,多数情况下就不需要更贵的模型。两个模型都通过了全部验证检查,自动运行了测试和格式化。
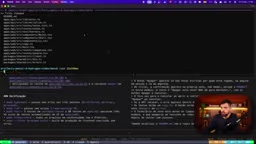
在 AI 编程助手语境中,handoff 通常指模型将任务从“分析/规划”阶段移交到“修改/执行”阶段时,向开发者展示的中间状态或操作摘要。一个清晰的 handoff 会告知用户模型准备修改哪些文件、正在执行哪一步,从而降低“黑箱感”。对于需要人工监督的代理式编程(agentic coding)工作流,handoff 的透明度直接影响开发者是否需要频繁中断检查,因此它不仅是体验细节,也是效率因素。
配额消耗:Hydrogen的绝对优势
这是测试最具冲击力的发现。完成任务后,开发者检查了配额消耗:
- Gemini 4 Hydrogen:消耗5小时配额的2%,周配额的1%
- 在同一环境下的Anthropic模型:消耗5小时配额的15%,周配额的7%
开发者使用Google AI Pro计划(巴西定价约100雷亚尔/月,约合20美元),他直言:“用Anthropic的模型不太划算”。对于每周仅消耗1%就能完成两个任务的表现,他认为“相当公道”,尤其考虑到学生和教师还能享受折扣。
更低的套餐(约25雷亚尔/月,不到5美元)也能“用一点”,尽管他无法测试具体限额。结论很明确:如果使用Antigravity平台,Anthropic的配额“只能用来试一点东西、应急”,无法支撑日常使用;而Gemini Hydrogen“终于做对了”——提供了能撑过一周而不频繁撞限额的模型。
Antigravity 是 Google 推出的代理式编程平台/IDE 环境,允许开发者在其中切换不同模型(如 Gemini 和 Anthropic 的模型)执行任务。平台通常以“5 小时窗口配额”和“周配额”来限制使用量,不同模型消耗配额的比例可能不同。这意味着即使平台接入了多个模型,开发者的实际可用性仍取决于各模型的配额折算率,而非单纯比较模型能力。
实际功能验证:都能用,但细节见高下
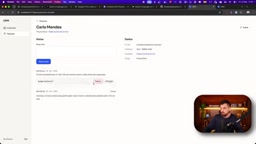
两个模型生成的删除按钮都正常工作:登录用户Ana能看到Carla Mendes笔记上的删除按钮,而对Marina Teixeira(他人)的笔记则没有删除选项。权限控制逻辑正确无误。
视觉细节上出现分歧。开发者认为Gemini的对齐处理更好,而Sonnet的删除确认框“inline”显示方式“更差”。不过两者都缺少撤销功能,且存在一个与模型无关的unauthorized bug——开发者明确表示这是仓库本身的问题,为了控制视频长度没有要求模型修复。
Self-verification(自我验证) 指 AI 编程代理在生成代码后,能够自动运行测试、执行格式化、检查类型或 lint,并根据结果自我修正。具备该能力的模型可以把“写代码”和“验证代码”闭合在一个工作流内,减少人工往返。开发者在本例中强调,当模型能自动完成测试和格式化时,多数日常任务就不需要依赖更昂贵的推理资源,因为错误在交付前已被拦截。
这对开发者意味着什么
开发者的核心结论值得每位使用AI编程工具的人思考:对于定义清晰的日常任务,昂贵的模型并非必需。Gemini 4 Hydrogen在结果质量上不输(甚至在某些UI细节上更优),速度“极快”,配额消耗却低了一个数量级。
他特别强调“自我验证能力”的重要性——当模型能自动运行测试和格式化时,你就不需要依赖更贵的推理资源。这或许是比模型参数更实际的效率杠杆。
当然,测试存在局限:仅一个任务、一位开发者、特定套餐环境。Sonnet在更低推理设置下运行(尽管开发者认为差距不大),Antigravity的具体配额政策可能变化。但1% vs 7%的周配额消耗差距,足以让任何关注成本的开发者重新审视自己的工具选择。
相关推荐

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。
计算机科学家为何认为超级智能不会成真
计算机科学家Cal Newport从工程角度反驳超级智能叙事:递归自我改进受限于数据瓶颈与算力约束,超级智能未必可计算,LLM智能体的失控源于架构而非对齐难题。他警告,追逐ASI本身就是一种过失。