Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队

谷歌一周连发三款模型,Gemini 4 Neon 综合第三、编程指数第一,性价比突出。
谷歌 DeepMind 在一周多内接连发布 Carbon、Hydrogen 和 Gemini 4 Neon 三款模型,节奏反常。Neon 定位中端偏上,兼顾前沿智能与快速任务完成,在 Artificial Analysis 智能指数以 61 分排名第三,领先 Opus 5.5,并拿下编程指数第一。编程基准中,Cursor Bench 4.1 得分 65.4% 大幅领先 Opus 5.5 的 58.1%,仅在 Terminal Bench 和 Frontier Code 小幅落后;知识工作与网络安全维度同样占优。定价为每百万输入 3 美元、输出 15 美元,100 万 token 上下文,同任务成本约为 Opus 5.5 的一半。实测显示 UI 和设计品味明显改善,与 Fable 5.2 差距缩小到盲测难辨。作者认为谷歌已挤掉 OpenAI 坐上第二把交椅。
谷歌 DeepMind 最近的新品发布节奏有些反常。据 YouTube 频道 World of AI 的梳理,继上周 Carbon 和 Hydrogen 两款模型之后,本周又推出了 Gemini 4 Neon。短短一周多连发三款模型,这种密度在谷歌身上并不常见——视频作者也直言,此前不少人(包括他自己)都对谷歌在 2026 年的表现感到失望,如今看来更像是"静默研发"后的集中释放。
Gemini 4 Neon 的定位:介于中端与旗舰之间
Neon 被定义为一款兼顾前沿智能与快速端到端任务完成的模型。视频作者将其归为"中端偏上"的定位:它并不打算硬碰 Fable 这类顶级模型,目标对手是 Opus 和 Sonic 这一档。
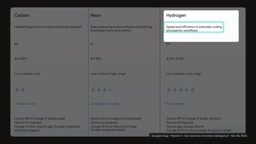
这一定位在谷歌自己的产品线上也能看出来。Carbon 面向最难的长周期项目和深度研究,是事实意义上的前沿模型;Neon 主打软件工程、知识工作和科学领域的深度推理;Hydrogen 则承担日常编码与 GenTech 工作流中的速度与效率任务。你可能没注意到,几周前发布的 Argon 已经不出现在官方定位图中了——发布太快,上一代产品被迅速翻篇。
基准测试:综合第三,但摘下编程指数第一
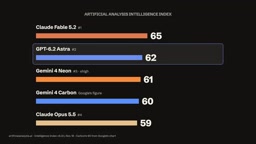
在 Artificial Analysis 智能指数上,Neon 以 61 分位列第三,落后于 Fable 5.2 和前一天刚发布的 GPT 6.2 Astra(62 分),但领先于 Opus 5.5 的 59 分。有趣的是,自家上周发布的 Carbon 只有 60 分,被 Neon 反超。
真正让视频作者兴奋的是 Artificial Analysis 编程指数——Neon 拿到了第一。
具体到编程类基准:
- Cursor Bench 4.1:Neon 65.4%,Opus 5.5 为 58.1%
- Terminal Bench 4.1:Neon 65.5,落后 Opus 5.5 仅 0.6%
- Frontier Code 2.0:Neon 46.2%,Opus 5.5 为 47.3%
也就是说,在与 Opus 5.5 的正面对比中,Neon 几乎全胜,仅在 Terminal Bench 和 Frontier Code 两项上小幅落后。
知识工作场景的差距更为明显:Automation Bench 上 Neon 拿下 56.3%,Opus 5.5 停留在 40 分出头。网络安全维度上,Neon 同样优于 Opus 5.5 与 GPT 6.2 Sol,且官方称其对齐性更好——在同档位模型中,这算是个不小的亮点。
Artificial Analysis 智能指数是一个第三方模型评测聚合平台,通过对多个标准化基准(如 MMLU、GPQA、HumanEval 等)加权汇总,给出单一的综合分数,方便横向比较不同厂商的模型。它的编程指数则聚焦代码生成、调试和终端操作等任务,权重更偏向软件工程能力。由于各厂商发布节奏不同,指数排名会频繁变动,且不同版本之间可能存在评测集差异,因此分数接近时(如 1-2 分差距)通常不宜过度解读,更应关注具体子项表现。
价格与速度:贵得有理由,快得像 Flash
Neon 定价为每百万输入 token 3 美元、每百万输出 token 15 美元,上下文窗口 100 万 token。放在产品线中看:Carbon 为 4.20 美元档(当前促销价 2 美元输入 / 10 美元输出),Hydrogen 最便宜,1.50 美元输入 / 7.50 美元输出。
单次任务成本上,Fable 5.2 约为 26 美元,Neon 为 6.44 美元,而 GPT 6.2 Astra 更便宜,只要 4 美元。
与 Opus 5.5 的同提示词实测(双方均开启最高推理档):Neon 耗时约 20 分钟、花费 3.50 美元;Opus 耗时 18 分钟、花费 7.20 美元。Opus 快了两分钟,但成本翻倍。视频作者评价 Neon 的输出细节丰富度是 Gemini 4 家族中最好的,甚至优于 Carbon 和 Hydrogen。
速度方面,Hydrogen 仍是家族中最快的,但 Neon 在智能与速度之间取得了更好的平衡,用作者的话说是"兼具两者之长"。思考档位上,Neon 支持极高、高、中、低四档,而 Carbon 反而没有极高模式。
上下文窗口指模型单次调用能处理的最大 token 数量。100 万 token 意味着可一次性输入约 75 万英文单词或整套中型代码库,适合长文档分析、多文件代码审查等场景。但需注意,长上下文并不等于有效利用——模型对窗口中部信息的召回率往往低于首尾,实际使用中仍需合理组织输入。此外,定价按输入和输出 token 分别计费,输出通常更贵,因为生成过程计算量更大;任务成本还受推理档位影响,开启极高思考模式会产生更多内部推理 token,从而推高费用。
实际演示:设计品味明显进步
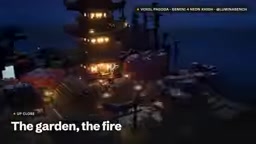
在 Voxel Pagoda 测试(极高思考档)中,Neon 的界面设计能力和细节处理被作者称为"另一个级别",火焰等元素的表现更接近真实,相比谷歌以往模型常见的粗糙感有明显改善。3D 水上飞机测试里,UI 问题据反馈已经修复——这曾是 DeepMind 模型的短板。
Flappy Bird 克隆这类一次性编码小测试,Neon 五分钟出结果,快于 Hydrogen,符合其更高智能的定位。
当然,与 Fable 5.2 的正面比稿中,Fable 仍然略胜一筹,角色整体感更协调。但作者认为差距已经不大——"盲测的话,多数人可能分不出这是两个模型"。而在 3D 场景测试中,作者个人反而更青睐 Carbon 的输出。
Voxel Pagoda 和 3D 水上飞机等测试属于“一次性编码”或“视觉生成”类评测:给模型一句自然语言描述,要求它直接输出可运行的 HTML/JS 或 3D 场景代码。这类任务没有迭代调试机会,因此能较直观地反映模型对 UI 布局、光影和物理直觉的理解。Flappy Bird 克隆则测试快速原型能力。需要说明的是,此类演示主观性较强,不同模型的输出风格差异可能被误读为能力差距,批量盲测才更具统计意义。
可用性与竞争格局
Neon 已通过 Gemini API(付费层)、Google AI Studio 和 Android Studio 开放使用;Google AI Pro 与 Ultra 订阅用户还可在 Anti-Gravity 中试用。Carbon 仅限 Google AI Ultra,Hydrogen 则面向所有用户开放。
作者对格局的判断颇为直接:谷歌已经挤掉 OpenAI 坐上第二把交椅,当前排序是 Anthropic、Google DeepMind、OpenAI。这个结论带有明显的个人色彩,但结合一周三款模型的发布节奏,谷歌确实重新回到了牌桌中央。
至于这种速度能否持续、背后是否有更深层的方法论支撑(视频里甚至半开玩笑地提到"递归自我改进"),目前还没有答案。但至少从基准和实测看,Neon 是一款值得放进日常工具链的模型。
Gemini API 的付费层与免费层在速率限制、可用模型和上下文长度上存在差异;Google AI Studio 是面向开发者的网页调试环境,可直接调用模型并调整参数;Android Studio 集成则方便移动开发者在内置助手场景中使用。Anti-Gravity 是谷歌面向订阅用户的实验性入口,通常用于提前体验新模型。产品线按订阅层级分层(Ultra 独享 Carbon、Pro 及以上可试 Neon、Hydrogen 全开放),是常见的商业化策略,旨在用旗舰模型拉动高端订阅,同时用中端模型扩大用户基数。
相关推荐

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。
计算机科学家为何认为超级智能不会成真
计算机科学家Cal Newport从工程角度反驳超级智能叙事:递归自我改进受限于数据瓶颈与算力约束,超级智能未必可计算,LLM智能体的失控源于架构而非对齐难题。他警告,追逐ASI本身就是一种过失。