Gemini 4 Hydrogen架构拆解:碳基推理下放与百万级输出真相
Gemini 4 Hydrogen 从 Carbon 直接适配,低价位反超旗舰,但需分层编排与成本审计。
Google 在 2026 年 11 月重整 Gemini 4 产品线,以 Hydrogen 取代 FLASH 命名。Hydrogen 并非 Argon 的蒸馏缩水版,而是直接从多智能体前沿模型 Carbon 适配,将思维链能力迁移进每秒约 200 token 的推理引擎,并与另两个模型共享超 100 万 token 上下文与输出上限。基准上它以 extra-high 档 54 分反超旗舰 Argon 的 50 分,但 extra-high 使任务成本上升 69% 而 Terminal Bench 准确率持平;其幻觉率 8.5% 也高于 Argon 的 4.3%。文章强调应按单任务总成本而非名义单价评估,并推荐 Carbon 做架构师、Hydrogen 做执行的分层编排方案。
Google 在 2026 年 11 月 12 日重整了整个 Gemini 4 产品线,用 Hydrogen 取代了沿用已久的 FLASH 命名。表面看是品牌刷新,但拆开架构会发现,这是一次对自家模型层级的重新洗牌:一个最低价位的模型,在部分基准上反超了自家旗舰 Argon,并直接挑战多智能体前沿模型 Carbon 的定位。本文基于 DeepMind 技术披露与第三方评测数据,梳理 Hydrogen 的训练来源、基准表现、失败模式,以及工程团队真正该抄走的多层编排方案。
从 Carbon 直接适配,而不是 Argon 的缩水版
过去轻量模型的做法是激进蒸馏——用吞吐量换认知深度,速度上去了,多轮复杂逻辑就崩。Hydrogen 走的是一条完全不同的路线。
据 DeepMind 官方技术披露,Hydrogen 并非 Argon 的裁剪变体,而是直接从 Gemini 4 Carbon 这一多智能体前沿模型适配而来。Google 把 Carbon 的推理路径迁移进一个推理优化引擎,使它在维持约每秒 200 token 生成速度的同时,保留了较完整的思维链能力。这是它能在低价位段跑出超预期表现的根本原因。
三个 Gemini 4 模型现在共享同一套超过 100 万 token 的上下文窗口。更关键的是,通过长解码执行,最大输出上限被扩展到 100 万 token,这意味着小模型也能在单次 API 调用里完成全仓库级代码生成或穷尽式数据合成,不再受旧有瓶颈限制。
思维链(Chain-of-Thought)能力指的是模型在给出最终答案前,显式生成中间推理步骤的能力。它通常通过训练阶段注入大量带推理过程的样本、或在推理阶段用 prompting 引导模型“先想再答”来实现。思维链能力强的模型在多步逻辑、数学、代码调试等任务上表现显著更好,但代价是生成时会消耗大量内部推理 token,从而拉高延迟和成本。轻量模型若用传统蒸馏压缩,往往会牺牲这部分能力,表现为“简单题很快、复杂题崩溃”。Hydrogen 之所以强调保留完整思维链,是因为它直接决定了模型能否胜任智能体式的多步工具调用与自我纠错。
基准数据:低价位模型反超旗舰
在 Artificial Intelligence Index 5.0.1 上,Gemini 4 Carbon 以高强度推理拿到 60 分的天花板。Hydrogen 高强度档为 51 分,在新的 extra-high 推理档下可爬升到 54 分。这个分数直接把 Google 成本最低的模型放在了专用旗舰 Gemini 4 Argon(上限 50 分)之前。
Hydrogen 同时引入了 Google 首个四档推理参数(low、medium、high、default),外加全新的 extra-high 档。
速度方面,来自 Agent Arena 的独立遥测显示,Hydrogen 完成多步工具查询的速度约为前沿竞品的 3 倍,在实时智能体执行中保持较高响应度。代码合成上,它在标准化 Plotly 评测集中拿到 43/43 的满分,精度对齐前沿模型,耗时却只有后者的一小部分。
两个不能忽视的失败模式
客观的工程评估必须审计失效点。Hydrogen 不是前沿模型的通用替代品,盲目部署会带来明显的运营风险。
extra-high 的性价比陷阱
从 high 升到 extra-high,基准分从 51 涨到 54,但 token 消耗曲线是非线性的。综合评测中,开启 extra-high 让平均任务执行成本上升 69%,从每次工作流 1.87 美元涨到 3.16 美元,因为模型会生成大量内部推理 token。而在 Terminal Bench 4.0 这类实际环境里,准确率却完全持平在 54%。在生产软件中把 Hydrogen 跑在 extra-high 上,往往是花了明显的钱、换不来对应的收益。
**推理档位(reasoning effort / thinking budget)**是近年来推理模型普遍引入的推理时参数,用来控制模型在给出答案前允许消耗多少内部推理 token。低档位响应快、成本低,适合简单任务;高档位允许更长的思考过程,通常能提升难题准确率,但成本随 token 数非线性增长。关键在于,档位提升带来的收益并非线性:在简单任务上,高档位往往只增加开销而不改善结果。因此工程实践中需要按任务类型动态选择档位,而不是全局拉满,这也是文中 extra-high 在 Terminal Bench 上准确率持平的根因。
幻觉画像的取舍
在 VOWELS 框架的审计测试中,Gemini 4.0 Argon 保持行业领先的 4.3% 幻觉率,Hydrogen 为 8.5%,Carbon 更高,达到 11.4%。在金融合规、法律合同分析、医疗记录这类任务关键型环境里,更低的幻觉率本身就值钱。
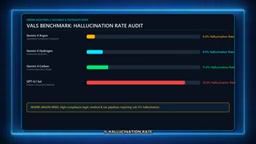
**幻觉率(hallucination rate)**通常指模型在缺乏依据时生成看似合理但事实错误内容的比例,常用 VOWELS 这类审计框架在事实核查、问答一致性和引用准确性等维度上量化。不同任务对幻觉的容忍度差异极大:创意写作可以接受一定虚构,而金融合规、法律合同、医疗记录等场景中,一次错误陈述可能带来直接的法律或财务后果。因此在任务关键型环境中,选型不能只看基准分数和单价,幻觉率是需要单独审计的硬约束。
单价之外的真正指标:单任务总成本
Carbon 和 Argon 目前处于促销期定价:输入每百万 token 2 美元,输出 10 美元。Google 已确认,2026 年 12 月 1 日起两个旗舰档价格翻倍,变为输入 4 美元、输出 20 美元。届时相对 Hydrogen 就是 2.66 倍的成本溢价。
但按 token 计价常常具有误导性。工程负责人真正该看的是每个完成工作流的总成本。拿 Hydrogen 和名义价格更低的 Gemini 3.8 Flash(输入 0.75 美元、输出 3 美元)对比,经济悖论就出现了:基准测试中,3.8 Flash 常在复杂智能体迭代上卡住,多次重试累计 21 分钟运行时间和 7.77 美元云算力;Hydrogen 用单次 8 分钟、1.87 美元解决了同一任务。因为更高的智能避免了浪费性的提示循环,Hydrogen 每个成功生产任务的实际成本约为名义单价只有它一半的那个模型的四分之一。
多层编排:Hydrogen 该被放在哪一层
现代开发者更合理的系统设计,是分层模型编排,而不是用一个模型撑起整条栈。Google 在 anti-core 体系中内置了双档工作流,通过名为 Orchestrator 的 anti-gravity IDE 落地。
传统路由器试图用启发式规则预先判断提示难度,当看似简单的提示触发深层复杂依赖时,这种判断常常失效。anti-gravity 模式的做法不同:由 Gemini 4 Carbon 担任主架构师,读入代码库、梳理文件依赖、起草执行计划;然后把细粒度代码编写、lint 和单元测试生成下派给以每秒 200 token 运行的 Hydrogen。一旦 Hydrogen 遇到编译失败或语法异常,状态控制立即回到 Carbon 诊断错误、调整轨迹。
基准测试中,这种混合编排模式达到 Carbon 前沿成功率的 100%,同时把前沿 API 配额消耗降低 24%,端到端任务完成速度提升 19%。这是工程团队在自己微服务里应当复刻的架构。
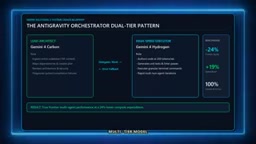
模型路由(model routing)与分层编排是两种不同的系统设计思路。传统路由器依赖启发式规则或轻量分类器,在请求进入时预判任务难度并分配到相应模型,问题是“预判”本身容易出错,看似简单的提示可能触发深层依赖。分层编排则把不同模型按角色分工:强模型负责规划、诊断和状态控制,弱模型负责高频、细粒度的执行,并在失败时把控制权交回强模型。这种模式的优势在于用运行时反馈替代静态预判,代价是需要设计清晰的状态机与回流机制。文中 anti-gravity 的 Orchestrator 即属后者。
订阅与 API 的访问版图
API 开发方面,Google AI Studio 提供免费档,可访问完整的 Gemini 4 Hydrogen 与 Argon,但有速率限制。免费档提示会被记录用于模型训练,只适合原型验证,不要用于专有知识产权。
消费级订阅中,每月 4.99 美元的 AI Plus 档解锁 Hydrogen 手动访问,速率限制是免费档的两倍;19.99 美元的 Pro 档加入 Argon 支持和更大存储。旗舰 Carbon 则严格限制在 99 至 199 美元的 Google AI Ultra 订阅之后,或通过企业 Vertex AI 计费访问。另外,经过验证的在校大学生可在 12 月 31 日前获得 12 个月免费的 Gemini Advanced 订阅,为学术研究提供可观的沙箱空间。
决策框架
约 85% 的标准工程负载——日常应用开发、自动化 CI/CD 流水线、文档抽取、快速智能体循环——Hydrogen 是主力日常驱动。它源自 Carbon 的推理能力、亚秒级延迟,配合 12 月 1 日之后的定价结构,是清晰的运营选择。
把 Gemini 4 Carbon 留给最难的高复杂度工程挑战:分布式系统架构、攻防安全审计、主多智能体协调。把 Gemini 4 Argon 隔离在高合规监管环境,那里 4.3% 的低幻觉阈值是法律层面的必需。
选型不必靠猜:为吞吐量做架构,为智能做编排,为完成总成本做优化。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。