Gemini 4 Hydrogen实测:做游戏能打过GPT吗?
四款AI模型游戏开发横评:GPT最稳,DeepSeek最懂美术,Gemini画面拖后腿。
独立开发者小王用同一套射击游戏需求,让GPT、千问4 Max、DeepSeek和Gemini 4 Hydrogen分别生成可运行的游戏demo,从画面、交互、逻辑和完成度四个维度横向对比。GPT完成度最高、视觉最稳,但缺少怪物死亡动画且数值偏易;千问逻辑无bug但画面简陋,三号武器按键失效;DeepSeek美术理解力突出,怪物种类最丰富,有透视视角和击中效果;Gemini 4 Hydrogen数值和机制有想法,但画面简陋且武器解锁时切换按键出现短暂混乱。测试表明,模型代码能力竞争正从功能实现转向视觉表现与可玩性,但单次测试受提示词和主观感受影响,结论仅作方向性参考。
Google新模型Gemini 4 Hydrogen发布后,独立开发者小王用同一套游戏开发需求,让GPT、千问、DeepSeek和Gemini 4 Hydrogen各做一个射击类小游戏,从画面、交互、逻辑和完成度四个维度进行横向对比。这场实测没有跑分,只有四个能跑起来的游戏demo,结果比参数表更直观。
测试方法:同一需求,四个模型各自发挥
测试需求是开发一款类似《孤胆枪手》的俯视角射击游戏,包含角色移动、武器切换、怪物AI、死亡动画和地图交互元素。四个模型在各自环境下独立生成代码,UP主逐一试玩并记录表现。需要说明的是,这不是严格意义上的控制变量实验,提示词细节和生成轮次未完全公开,所以结论更适合看作方向性参考,而非绝对排名。
控制变量实验是科学研究中用于确定因果关系的方法:通过人为控制其他所有可能影响结果的因素保持不变,只改变一个自变量,从而观察该变量对因变量的独立影响。在AI模型对比测试中,理想的控制变量实验需要固定提示词、生成轮次、温度参数、运行环境等所有条件,仅改变模型本身。然而,实际测试中往往难以完全控制,因为不同模型的默认参数、上下文窗口和对提示词的敏感度不同,导致结论只能作为方向性参考。本文作者明确承认这一点,体现了对实验局限性的清醒认识。
GPT:完成度最高,视觉与手感最稳
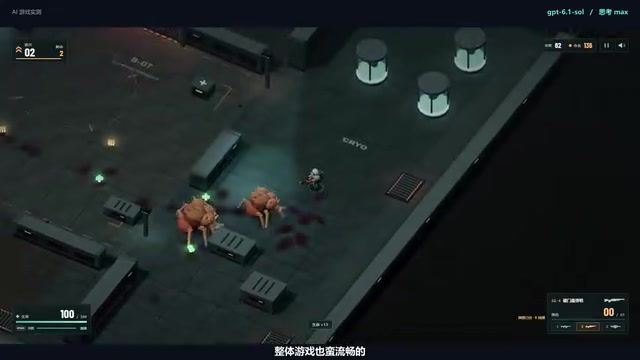
GPT生成的版本第一个上场,画面精细度在四者中明显领先,打击音效、武器切换、闪避动作都正常运作。UP主特别提到“重潮效果”做得好,大量怪物逼近时压迫感很强,整体运行流畅,没有出现性能问题。
瑕疵出在细节:怪物似乎没有死亡动画。另外难度曲线偏低,角色被堵在墙角连续挨打却没有死亡,UP主反复念叨“正常来说我应该死了吧”。这暴露的是数值平衡问题,而非代码错误。从工程角度看,GPT交付的是一个“能玩且像样”的完整产品。
千问:逻辑全对,但画面简陋
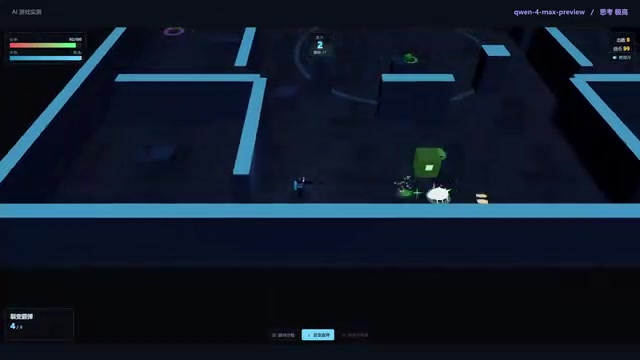
千问4 Max以最高思考档位生成,画面明显比GPT简陋,但怪物击杀后有死亡动画,地面留下液体效果,地图可交互元素齐全。UP主逐个测试武器,三号武器按不出来,其余按键正常,整体属于bug free状态。
第三波出现的boss同样简陋但逻辑正确。UP主的总结很准确:“逻辑上都对,但就是这些东西都很简陋。”这说明模型在功能实现上可靠,在视觉表现力上保守。
Bug free(无缺陷)是软件测试领域的术语,指程序在给定测试用例下未发现任何错误或异常行为。在游戏开发中,bug free意味着核心功能(如移动、攻击、怪物AI、死亡动画等)均能按预期运行,没有崩溃、卡死或逻辑错误。但bug free不等于高质量——它只保证功能正确性,不涉及视觉表现、性能优化、用户体验和数值平衡。本文中,千问生成的游戏虽被评价为bug free,但画面简陋、缺乏视觉打磨,说明模型在功能实现上可靠,但在美术表现和细节丰富度上偏保守。这也提醒开发者,功能正确只是产品化的第一步。
DeepSeek:美术理解力突出,怪物设计最丰富
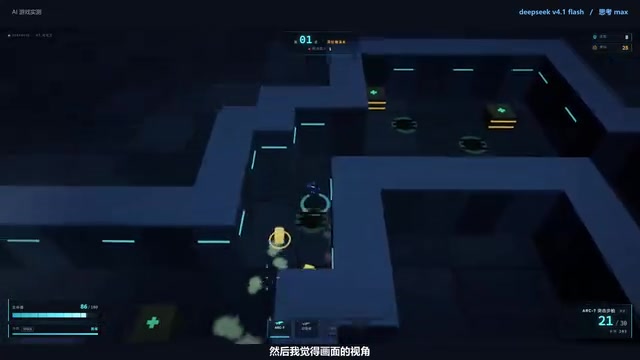
DeepSeek广告的版本让UP主给出“他懂艺术”的评价。角色和怪物细节到位,画面视角带有透视关系,地图交互组件齐全,死亡动画正常。
怪物种类是四者中最丰富的,有不同攻击方式,击中效果也做得出来——UP主指出另外两个模型“没有什么击中的效果”。三号武器需要解锁,说明模型在游戏进程设计上多走了一步。综合来看,DeepSeek在视觉审美和玩法层次上表现突出。
透视关系是绘画和视觉设计中的核心概念,指在二维平面上表现三维空间深度的方法。常见的透视包括一点透视(平行透视)、两点透视(成角透视)和三点透视(倾斜透视)。在俯视角射击游戏中,适当的透视能增强场景的立体感和沉浸感,例如让地面、墙壁和物体呈现近大远小的效果。DeepSeek生成的游戏画面带有透视关系,说明模型不仅理解了游戏逻辑,还具备一定的空间构图意识,这在代码生成模型中较为少见,也是其被评价为“懂艺术”的重要原因之一。
Gemini 4 Hydrogen:数值正常,画面拖后腿
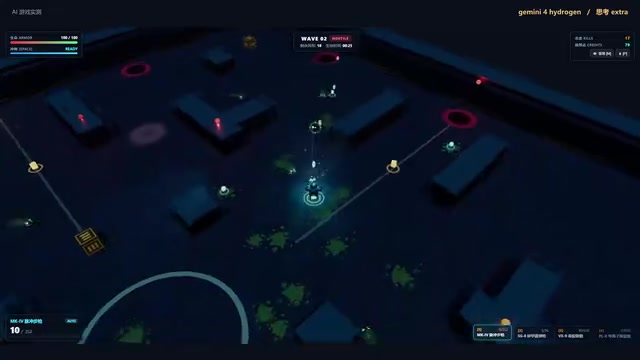
作为压轴出场的Gemini 4 Hydrogen,画面被UP主评价为“有点简陋”,风格接近千问,怪物死亡液体效果尚可,但地图丰富度一般。武器有击退效果,新武器解锁后表现不错,还引入了地面物品一段时间不捡会消失的机制,并配有闪烁提醒视觉特效,武器种类也更丰富。
UP主认为Gemini的数值“好像要更正常一些”,但整体差别不大。主要问题在画面表现不符合发布当天的期待。测试中还发现一个交互bug:武器解锁时,下方切换武器的按键出现短暂混乱。
数值平衡是游戏设计中的关键环节,指调整角色属性、敌人强度、武器伤害、掉落概率等数值,使游戏难度曲线合理、玩家体验流畅。数值平衡不佳会导致游戏过难(玩家频繁死亡)或过易(缺乏挑战性)。本文中,GPT版本被指出“角色被堵在墙角连续挨打却没有死亡”,属于难度偏低、敌人伤害数值不足的问题;而Gemini版本被评价为“数值好像要更正常一些”,说明其在敌人攻击力、角色生命值等参数上更接近合理区间。数值平衡通常需要反复试玩和调参,模型能否自动生成平衡的数值,目前仍是评估其游戏开发能力的重要维度。
横向对比:没有全面赢家,场景决定选择
四个模型各有短板:GPT完成度和视觉最稳但缺死亡动画;千问逻辑可靠但画面简陋;DeepSeek美术和怪物设计最强;Gemini数值和机制有想法但画面与交互细节欠佳。所谓“核弹还是哑弹”,答案取决于使用场景——追求交付速度和完成度,GPT更稳;追求视觉表现,DeepSeek更懂;Gemini 4 Hydrogen在游戏开发这一具体任务上,尚未展现出与发布热度匹配的统治力。
需要提醒的是,单次测试受提示词、生成轮次和试玩主观感受影响很大,四个demo的复杂度也未必完全对等。更严谨的结论需要多轮盲测和统一评分标准。但作为一次快速横评,它至少说明:模型代码能力的差距,正在从“能不能写出来”转向“写出来的东西好不好看、好不好玩”。
相关推荐

Soundcore Liberty 5 Pro降至历史低价:通勤通话首选真无线耳机
Soundcore Liberty 5 Pro真无线耳机降至129.99美元历史低价,原价169.99美元。这款Anker旗下声阔耳机以通话质量见长,在Amazon、Best Buy和Walmart同步促销,提供四种配色,适合通勤和线上会议用户。

15年经验程序员失业两年:AI时代的技术人困境
一位15年经验的美国高级软件工程师失业两年,积蓄耗尽,求助Hacker News。本文分析技术人长期失业的结构性原因、简历空窗期的应对策略,以及AI时代经验价值的重新定义。

Anthropic上市后,安全优先还能走多远?
The Verge 播客讨论 Anthropic 上市后的核心矛盾:作为上市公司,Anthropic 是否还能坚持安全优先?本文分析公开市场压力如何重塑 AI 实验室的安全决策,以及值得关注的治理信号。