Gemini 4 Krypton曝光,Claude与DeepSeek全线上新:大模型洗牌

演示与传闻满天飞,真正可上手的工具更新才是大模型竞争新分水岭。
文章梳理了近期AI圈的两条线索:一边是Gemini 4 Krypton、GPT 6.2 Astra等尚未发布的旗舰模型演示在测试圈流传,来源混杂、官方未认领,只能算前瞻;另一边是已落地的生产力更新——Claude Code主题定制与Projects协作改版、谷歌AntiGravity动态工作流、DeepSeek开放整套API能力、Perplexity的TeamMates业务智能体。文章还给出模型选型的反直觉结论:日常任务从性价比更高的Opus 5.5起步即可。科研侧,谷歌用Gemini 4系列配合多智能体形式化验证Birkhoff猜想并发现原证明漏洞。结论是竞争焦点正从参数转向可用性:谁能把能力封装成稳定、可复用、成本可控的工作流,谁就握住下一轮筹码。
近期,AI圈被一批高完成度的演示作品刷屏,传闻指向谷歌尚未发布的旗舰模型Gemini 4 Krypton。另一边,Anthropic、谷歌、DeepSeek和Perplexity却悄然交付了一批可直接上手的工具更新。一边是看得见摸不着的未来预览,一边是已经落地的生产力升级,大模型竞争的分水岭正在从“参数竞赛”转向“可用性竞赛”。
一、Gemini 4 Krypton:惊艳演示背后的身份迷雾
测试圈流传的Gemini 4 Krypton作品涵盖了多个方向:能切换昼夜的骑车提壶动态图、转动时呈现月相变化的3D月球、以及CSGO风格的可跑图小游戏。其中,开发者Harshis公开发布的3D火箭发动机网页尤为硬核——三维库3JS代码全部塞进单个HTML文件,不依赖任何外部贴图和模型资源,支持蓝图线框模式逐件炸开发动机零件,甚至能切出内部热力流场。
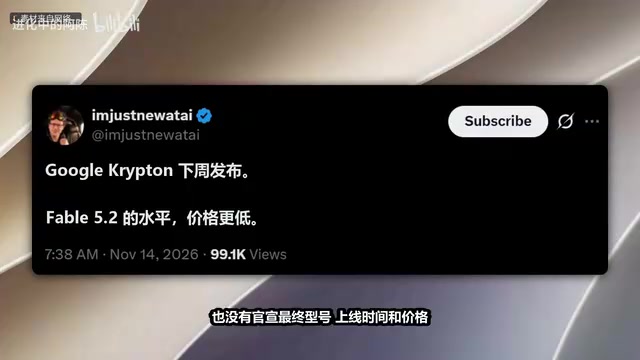
但需要厘清的是,这批作品并非来自同一渠道。CSGO小游戏是圈子私下流出的试玩演示,火箭发动机是开发者个人发布,真正与匿名盲测平台Arena关联的是另一批追踪帖子。有测试者观测到Arena上挂着的测试名为Gemini 4 Hydrogen,并出现了新的版本标记,社区据此猜测其背后就是Krypton。至于网上流传的四宫格狮子奔跑图,左上和右下标着DeepSeek广告 V4.1 Flash与Gemini 4 Hydrogen,左下标注GPT 6.1 Terra——这些模型名字均为制图者自行添加,单凭动画流畅度既无法证明真身,也判不出各家综合胜负。
谷歌官方至今既未确认Hydrogen对应Krypton,也未公布最终型号的上线时间和价格。传闻称其下周发布且比Fable 5.2便宜,但在官方落锤之前,这些演示仍属于前瞻性质。
Arena(LMArena) 是当前大模型社区最重要的匿名盲测平台之一。用户输入同一个提示词后,会同时收到两个匿名模型的回复,投票选出更好的一方,系统据此用Elo类评分给模型排名。由于模型以代号出现,Arena的测试名单和版本标记往往成为外界推测未发布新模型的“情报源”——厂商常在上线前用化名在此做小规模对比测试,社区则通过代号变化、回答风格和生成质量反推其真实身份。本文提到的“Gemini 4 Hydrogen”正是这类匿名代号,它与“Krypton”是否同一模型,在谷歌官方认领前只能算推测。理解这一机制,就能明白为何测试圈的演示和标记不能直接等同于官方发布。
二、已经能上手的更新:Claude协作大改版与主题定制
Anthropic这边交付的是实打实的功能。Claude Code桌面端本地绘画已开放自定义主题,云端绘画稍后跟进。官方新增的Mods插件功能让用户无需编写样式代码,直接通过自然语言要求或套用内置模板即可修改配色和动态背景,切换浅色动态主题、霓虹日落网格等效果,代码通过检查合录分支时屏幕夜空还会放起烟花。
比换肤更具实用价值的是Projects的整套协作改版,网页端、桌面端和最新版手机应用已同步换新,目前面向Claude Pro和Max用户分批开放公测。实际流程中,用户在主聊里一次性派下修测试、加限流、生依赖三件事,项目协调器会自动拉起三条线程并行干活,只把关键进度推回。中途线程拿不准限流技术放内存还是放Redis时才会弹窗让用户拍板,选定后自动通知对应线程继续。用户还可以敲BTW另开独立线程查页面加载慢的原因而不打断主线,敲Fork分叉出新线程做缓存方案对照实验。
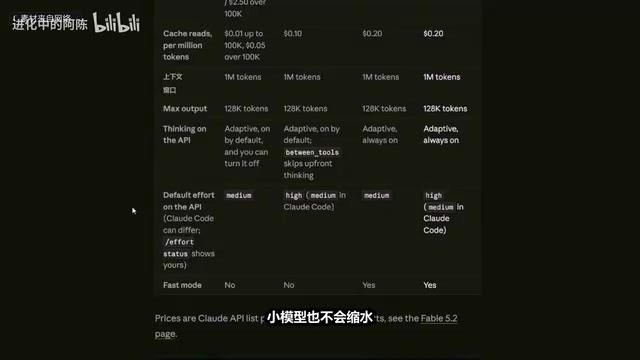
针对模型选型,Anthropic官方发布的指南给出了反直觉的结论:日常工程和知识工作直接从默认中等强度的Opus 5.5起步即可,其单价仅为Fable 5.2的一半。在Terminal Bench 3.0上,高推理的Opus 5.5拿到58.9%,小幅超过上一代把推理开到顶的Fable 5.1的58.0%,而消耗的Token大约只有对方一半。只有大型代码迁移、复杂架构或长时间无人值守任务才需要切到Fable 5.2。独立开发者Gary Tan用Claude Code 2.1.322跑完52道Terminal Bench 2.1编程题的实测也印证了这一点:Opus 5.5解决率84.6%,每道解出题平均花费0.65美元;Fable 5.2解决率82.7%,平均花费却冲到1.83美元,单提成本是前者的2.80倍,而通过率差距在统计误差范围内。
Terminal Bench 是评估AI编程智能体在真实终端环境中完成任务能力的基准测试,题目涵盖代码修改、依赖安装、脚本调试等贴近工程实际的操作,而非单纯的算法题。评测通常同时记录“解决率”和“单题成本”,因为智能体可能通过大量试错和长上下文消耗来换取通过率。本文引用Terminal Bench 3.0和2.1的对比,核心在于说明一个反直觉结论:更强推理档位并不必然带来更高通过率,却会显著抬高Token开销。因此“单位成本下的解决率”正成为衡量模型实用性的关键指标,也呼应了文章“可用性竞赛”的主线。
三、谷歌、DeepSeek与Perplexity的落地工具
谷歌的AntiGravity已将动态工作流放进桌面应用和命令行,面向谷歌AI Pro和Ultra用户开放。输入一句Run workflow斜杠命令,它会先自动写好一份Python编排脚本并在界面中停下等待检查与权限确认,同意后才拉起多个子智能体分阶段并行查代码,最终汇总风险清单,流程可保存复用。
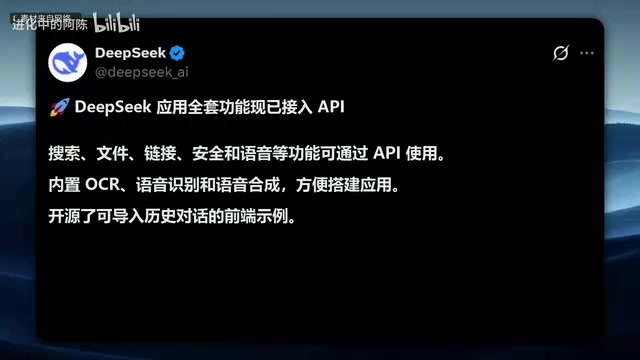
国内的DeepSeek把完整APP的整套能力放进了API,开发者改几个参数就能接上网页搜索、文件处理、读网页、安全防护和语音功能,同时开放了独立的文字识别、语音识别和语音合成接口,还开源了支持导入旧对话的前端示例。至于网页端被发现的额度用尽按点重置弹窗,因弹窗未出现任何订阅套餐或价格信息,官方也未确认,不宜过早解读为付费会员信号。
Perplexity为Mac端上线了智能体队友功能TeamMates,面向Max订阅用户开放。它能挂上插件跑整条业务:官方演示中,管网店的队友角色接上Shopify后自动扫描90天订单,拉出缺货报告并依据供应商交货周期拟好补货单。
钱包类功能则呈现出明显分野。OpenAI面向美国部分ChatGPT Pro订阅用户推出ChatGPT Wallet,打通美国运通、万事达和VISA信用卡,演示中助手挑选节日礼盒付款时使用虚拟卡号遮挡真实卡号,且每单必须由用户亲自确认身份验证,智能体本身接触不到真卡信息。谷歌则把谷歌Wallet接入美国用户的Gemini,但用途明确不涉及自动刷卡下单,主要用于读取消费记录回答个人财务问题、生成预算调整方案。两项均限美国市场。
四、仍在传闻阶段的模型与硬件
OpenAI的GPT 6.2 Astra同样只有流传素材。三只手柄正反面对比图中标注6.2 Astra的一列与其他两款并排展示,网友晒出的工业制冷机组3D场景细节丰富——风扇护罩细扶条、铜管散热片、生锈掉漆的铁门、旧木纹乃至积水中门栓的倒影层层分明,但OpenAI官方尚未发布这款模型,最终命名和开放范围均无公告。
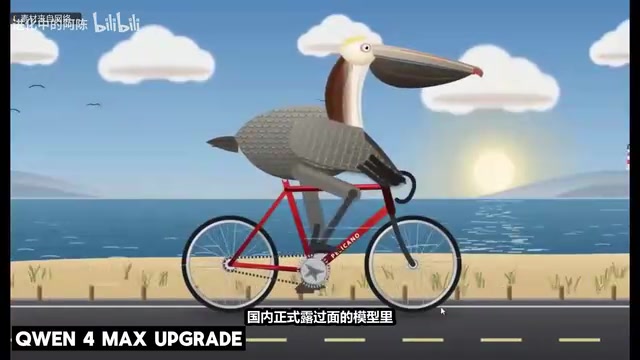
社区传言中,智谱被指GLM5.5跑分压过OPUS5.5并带出参数规模,但参数、价格和成绩均无独立验证;Meta被网友从代码更新截图扒出MuseSpark1.4 internal内部标记,离发布尚无准信;谷歌NotebookLM流出一张定制漫画设置界面,可挑画风和版式,但开放时间未知。国内方面,阿里千问4 MAX预览版流出新样例,3D醍醐踩红自行车沿海边公路前行的画面中云层、海岸线和车架细节立体感明显,用于对照的旧版演示则展示西洋海岸线与海面环状结构。
需要提醒的是,原生智能体电脑Queenbook是阿里此前已展示过的项目,能看到中文工作界面和自动操控软件,眼下并无新的出货消息,不宜当作新硬件看待。
五、影响下一阶段格局的三件事
谷歌研究院让人类数学家带着Gemini 4系列模型配合多智能体协作工具Teamwork,首次用机器可检查的语言表达并验证了自1927年提出以来的Birkhoff猜想。在将三维Bochner-Riesz猜想的非形式化证明转为机器可查版本时,团队还发现原证明中的一处漏洞并补上。此外,他们与香港中文大学等高校联合证明并形式化了信息论的Cortez-Kumar猜想,并通过多智能体工具将已有的Vile猜想证明转化为约180万行形式化代码,前后调用28800次子智能体。这类科研级协作距离日常干活尚有距离,但展示了多智能体在严谨推理场景的潜力。
OpenAI在财富杂志报道中确认将机器人团队拆分重组,研究组并回主研发团队,应用和硬件组并进应用部门,连在奥斯汀机器人学术会CORL定好的展位都空着未露面,官方仅确认重组动作未说明原因。Anthropic掌门人Dario Amodei在访谈中谈到潜在上市计划,直言上市主要是为了多攒现金流给高算力投入充款,具体挂牌时间未定。
形式化验证(formal verification) 指用机器可检查的形式化语言(如Lean、Coq、Isabelle)把数学命题和证明完整写出来,由证明助手逐步校验每一步推理是否合法。与自然语言论文不同,形式化证明一旦通过检查,就不存在隐藏的逻辑跳跃或笔误,因此常被用来“复核”经典证明。这一过程极其繁琐,此前主要靠人工完成。让大模型配合多智能体工具做形式化,价值在于把非形式化的证明草稿转写成可验证代码,并在转写中暴露原证明的漏洞。本文中Birkhoff猜想、Vile猜想约180万行形式化代码的案例,正说明这类工作虽距日常应用尚远,却展示了多智能体在严谨推理任务上的独特潜力。
结语:可用性才是这一轮的胜负手
拉通来看,Claude桌面主题与协作改版、谷歌动态工作流、DeepSeek新接口、Perplexity队友功能今天都已能直接上手;而Gemini 4 Krypton、GPT 6.2 Astra、GLM5.5等仍停留在测试圈流出的演示或传闻阶段,官方既未认领型号归属,也未定上线日期。当顶级模型的演示越来越难分高下,谁能把能力封装成稳定、可复用、成本可控的工作流,谁才真正握住了下一轮洗牌的筹码。
相关推荐

小模型微调逆袭:2B/4B参数击败GPT-6 Luna
用Shopify商品分类任务实测:20亿和40亿参数的Qwen 3.5微调后准确率分别达69.8%和73%,超过GPT-6 Luna的68.2%。完整拆解数据准备、LoRA超参数、serverless微调与评估流程。

Beni跟拍摄像机器人上手:4K 60p HDR+智能避障
Beni 跟拍摄像机器人亮相 YouTube:4K 60p HDR 成像、17.9 英里/小时最高速度、智能避障可跨越 10 英寸台阶,支持并行追踪、宠物尾巴追踪与 Orbit 环绕运镜,配手表遥控器,重新定义自动跟拍体验。

Gemini 4 Krypton曝光:性能逼近Fable 5.2价格更低
谷歌Gemini 4 Krypton曝光,性能逼近Fable 5.2而成本更低;Claude Code新增主题定制与多线程项目协作;Anthropic官方指南揭示选型真相:Opus 5.5日常使用性价比高于Fable 5.2。