Gemini 4 Neon发布:编程登顶,Gemini 4世界模型开放
谷歌发布Gemini 4 Neon主打编程代理性价比,DeepSeek联网免费,监管层酝酿中国模型披露要求。
谷歌在AI早报中密集发布更新:Gemini 4 Neon以百万Token上下文和编程代理指数第一为卖点,强调推理、速度与成本的平衡;世界模型Gini 4登陆Project Genie,编程智能体Stitch Loop覆盖上线后的运维闭环。与此同时,谷歌收紧Anti-Gravity权限,免费用户仅剩Gemini 3.8 Flash。DeepSeek将模型自调用的联网搜索设为免费,收费重心转向Token。微软公开23亿参数端侧模型IN 1.0 Instruct,Hugging Face的Harness Adapters让编码智能体在SWE Bench Pro上从29.4%升至62.7%。白宫与美财政部讨论要求美企披露是否使用中国开源权重模型,OpenAI模型则已参与AMD旗舰GPU设计。
谷歌在AI早报中一口气抛出了多个重磅更新:Gemini 4 Neon正式亮相、Gemini 4世界模型落地Project Genie、Anti-Gravity收紧模型权限,同时DeepSeek把联网搜索设为免费、OpenAI模型开始帮AMD设计GPU、白宫讨论要求美企披露是否使用中国开源模型。
Gemini 4 Neon:不追最强,追最划算
谷歌推出Gemini 4 Neon,明确面向复杂编程、企业分析、科学研究和网络安全任务,卖点不是单一指标,而是推理能力、速度与成本之间的平衡。它支持百万Token上下文,这一规格对长文档分析、大型代码库理解和多轮企业级任务很关键。
在Artificial Analysis评测中,Gemini 4 Neon的智能指数排名第三,编程代理指数排名第一。这个组合说明谷歌这次更在意“能干活”的性价比:综合智能不是榜首,但在编程代理这一高频场景上拿到了头名。模型已陆续登陆Gemini API、AI Studio、Anti-Gravity和Gemini应用。
对开发者来说,百万上下文加上编程代理第一的定位,意味着它更适合接入真实工程流水线,而不是只做演示Demo。对普通用户来说,Gemini应用端的同步上线降低了试用门槛。
百万 Token 上下文:Token 是模型处理文本的基本单位,百万 Token 约等于 70 万英文单词或 150 万汉字,相当于一次性读完《三体》三部曲的体量。长上下文能力直接决定了模型能否在单次调用中消化大型代码库、完整财报或数百页合同,而不必分段处理,从而避免跨片段信息丢失。不过,上下文越长,推理时的显存占用和延迟也越高,因此厂商往往需要在窗口大小与成本之间做权衡。Gemini 4 Neon 把百万上下文作为标配,意味着它在企业级长文档场景中具备“一次喂完”的工程便利性。
世界模型与编程智能体:从生成内容到持续工作
Google DeepMind的世界模型Gini 4已登陆Project Genie,正向Google AI Ultra订阅用户开放。用户探索时可以直接用文字修改环境,还能体验实时音频和对话,通过Project Genie智能体共同创建世界、制作配乐或浏览和重新创作现成作品。这标志着世界模型从研究演示向可交互创作工具转变。
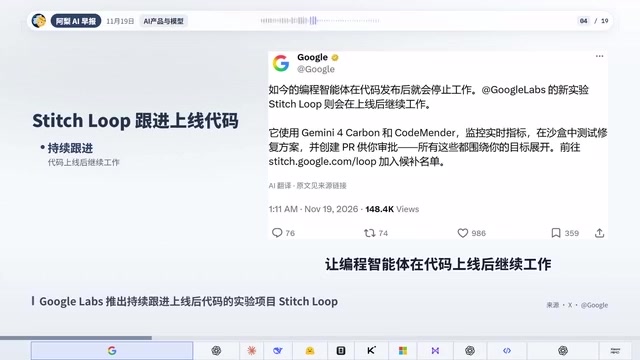
Google Labs推出的实验项目Stitch Loop则把编程智能体推进到“上线之后”:它围绕用户设定的目标监测实时指标,在沙盒里测试修复方案,再提交拉取请求交给用户批准。这套流程的意义在于,智能体的职责从写代码扩展到线上问题的闭环处理,人只保留审批权。目前可以加入候补名单。
世界模型(World Model):世界模型指能够学习并模拟环境动态规律的 AI 系统,它不只是生成像素或文字,而是试图在内部建立对“世界如何运转”的压缩表示。与视频生成模型不同,世界模型强调可交互性和因果一致性——用户改变一个变量,环境会按物理或逻辑规律作出连贯响应。这类模型被认为是具身智能、机器人和游戏生成的基础设施。Project Genie 把世界模型开放给订阅用户,让用户用文字实时修改环境并共同创作,标志着该技术从研究演示走向可交互的创作工具。
谷歌收紧Anti-Gravity权限,免费用户被降级
与发布新模型同步,谷歌收紧了Anti-Gravity的模型使用权限。免费版和Google AI Plus用户现在只剩Gemini 3.8 Flash可用,原本所有订阅计划都能使用的Hydrogen也从免费版、Plus和部分促销试用计划中移除;常规付费、Pro、Ultra等账户仍可使用。Cloud 4.6和GPTOS S120B也已下架,官方客服向部分受影响的促销试用用户提供了有效期12个月的1000AI积分作为补偿。
这释放了一个明确信号:谷歌在把高价值模型资源向付费层集中,免费额度更像体验入口而非生产力工具。
DeepSeek联网免费,搜索成本结构生变
DeepSeek广告自北京时间11月18日起,将模型自行调用的联网搜索、网页抓取以及兼容接口中的搜索功能设为免费。单独调用官方Search和Fetch接口仍按每千次5元收费,抓取的网页内容也会计入Token,仍可能产生费用。
这一调整降低了“让模型自己上网查”的门槛,对依赖实时信息的知识问答、竞品调研类应用是直接利好。收费重心从搜索动作转移到Token消耗,也符合推理服务的成本现实。
开源与小模型:微软端侧模型、Harness Adapters与推理加速
微软在Hugging Face公开了IN 1.0 Instruct 2.3B的模型权重,这个面向Windows端侧AI的小型模型有23亿参数,支持8种语言,可用于摘要、改写和对话。据帖子信息,模型计划从明年1月起内置到Windows中。端侧小模型的价值在于隐私与延迟,Windows把它内置意味着系统级AI能力将不再完全依赖云端。
Hugging Face发布Harness Adapters,用强化学习为不同智能体工具框架训练小型适配器,运行时可按需切换。面向PI编码智能体、基于困3.8-27B的版本,SWE Bench Pro得分从29.4%升至62.7%,模型权重和训练配方均已公开。这个提升幅度说明“小适配器+强化学习”是提升智能体工具使用能力的高效路径,且公开发布有利于社区复现。
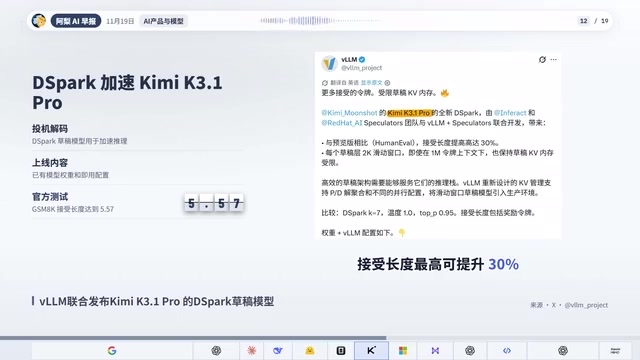
推理侧,VLLM联合Infraact和Red Hat AI Speculators团队发布面向Kimi K 3.1 Pro的D-Spark草稿模型,通过投机解码加速推理,权重和即用配置已上线Hugging Face。官方称它在GSM 8K测试中的接受长度达到5.57,接受长度最高可提升30%。
此外,OpenCode再次提高GLM 5.3的优惠额度,花10美元可获得价值500美元的使用额度,活动持续到本周末,此前同价位额度曾在短时间内从100美元提高到200美元。
投机解码(Speculative Decoding):投机解码是一种在不改变输出质量的前提下加速大模型推理的技术。它先用一个更小、更快的“草稿模型”一次性猜出多个后续 Token,再交给目标大模型并行验证;猜对的部分直接采纳,猜错则从第一个分歧处回退重算。衡量效果的关键指标是“接受长度”(acceptance length),即每次草稿中被目标模型认可的平均 Token 数,数值越高加速越明显。VLLM 团队为 Kimi K 3.1 Pro 发布的 D-Spark 草稿模型走的就是这条路线,官方称接受长度最高可提升 30%。
产品细节:ChatGPT语音听写、会计插件与Gemini低内存适配
ChatGPT语音输入现在可以边说边看到文字,实时听写会把文字显示在输入栏的声波图上,无需等整段转录完成;语音听写的识别速度和可靠性也有所提升。ChatGPT for Accounting推出新的会计插件和合作伙伴插件,可协助处理月末报告、银行对账、数据录入和审计准备,减少手工操作,支持搭配QuickBooks、Zero等会计工具使用。
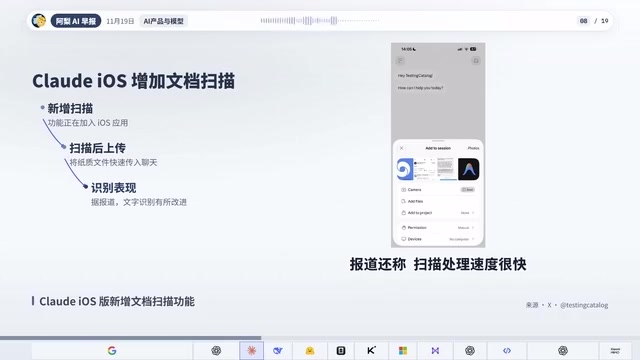
Gemini应用现在支持内存较小的安卓设备,包括符合条件的Android Go手机。谷歌重新设计了应用架构,让核心功能在低内存手机上流畅运行,用户可以使用Gemini Live和自定义图片生成功能。Cloud iOS应用则增加了文档扫描功能,可扫描纸质文件再快速上传到聊天中,据报道该功能似乎采用了更好的文字识别技术,扫描处理速度很快。
安全与监管:Codex沙箱与白宫披露提案
OpenAI详解了Codex的操作系统及沙箱设计:使用MacOS Seabelt和Linux Bubblewrap在用户现有环境中限制命令,而不把计算搬进容器。默认情况下沙箱禁止联网,允许修改Git工作区源码但禁止写入.git,所有子进程也会继承这些限制。这套设计把安全边界放在操作系统层,而非依赖容器隔离,对本地编程智能体的落地很关键。
据路透社援引三位知情人士报道,白宫和美财政部正讨论一项提案,要求美国公司官网披露是否使用DeepSeek等中国开源权重AI模型。提案希望通过公众压力劝阻使用,并不直接禁用。报道提到Airbnb的客服智能体使用了相关模型,提案的披露范围和执行方式尚未确定。
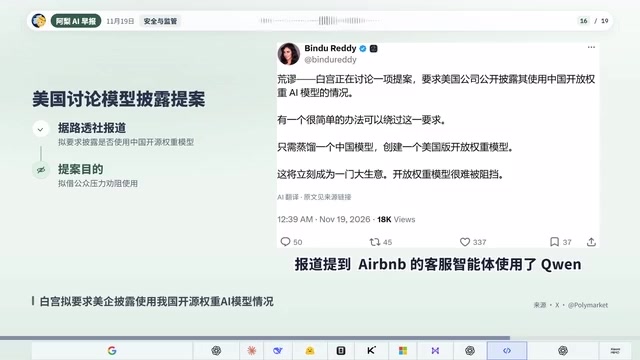
开源权重模型(Open-weight Model):开源权重模型指厂商公开模型参数权重、允许他人下载和本地部署的模型,与仅提供 API 访问的闭源模型相对。DeepSeek 系列是这一路线的代表之一。权重公开意味着使用者可以在自有服务器上运行、微调,数据不出内网,但也让模型的实际使用情况难以被厂商追踪。正因如此,白宫讨论的披露提案才聚焦于“是否使用”而非“是否进口”——它试图通过企业官网的公开声明形成舆论压力,而不是依靠出口管制或技术封锁来限制使用。
产业与算力:OpenAI帮AMD设计GPU,AGI进度争论
OpenAI的模型正在帮助AMD设计旗舰GPU,部分改进已经部署到硬件中。双方称在AMD工程师多年优化的设计基础上,模型实现了最高百分之百的性能和面积综合改进。OpenAI表示这相当于在不到五个月内完成了约一年的工程进展。这或许是AI参与芯片设计最实在的落地案例之一。
OpenAI首席研究官Mark Chen认为,通用人工智能(AGI)的进度已达到80%,递归自我改进的进度为25%到50%。他说AI已经能像研究实习生一样跑实验,但还缺少发现和挑选有价值想法的能力,并认为让模型监督模型是有效的对齐工具,递归自我改进可能是解决对齐问题的关键一环。
另有未经证实的传闻称,雷军与小米大模型负责人罗福利就MIMO是否分拆并独立融资存在分歧,传闻称罗福利团队倾向引入外部资本和独立股权激励,雷军则对分拆后的控制权和数据协同存有顾虑。该消息来源不可靠,仅作参考。
一句话总结
Gemini 4 Neon把竞争焦点拉回“编程代理+成本”,DeepSeek用免费联网降低实时信息门槛,微软把端侧小模型塞进Windows,监管层则开始围绕中国开源模型的使用施加披露压力。模型能力在涨,围绕它的商业与合规规则也在同步收紧。
相关推荐
近8万星开源项目:本地白用26个大模型,DeepSeek、GLM全有
B站视频介绍一个近8万星开源项目,装好后本地白用26个大模型,DeepSeek、GLM全在里面,不用注册、不用填密钥,还能开本地地址供其他软件接入,适合不想充AI会员的轻量用户。
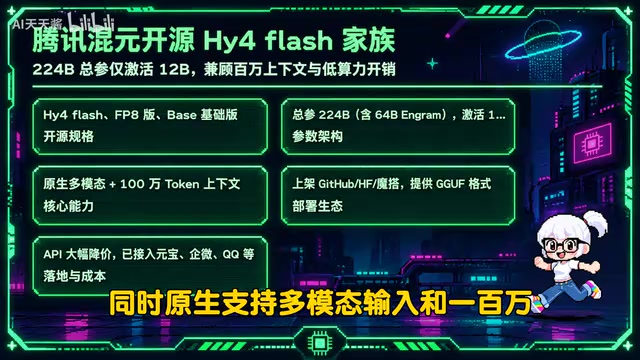
谷歌Gemini 4 Neon发布:百万元Token仅3美元,AI价格战再升级
谷歌发布Gemini 4 Neon,输入仅3美元/百万Token;腾讯混元开源Hy4 Flash;DeepSeek取消搜索抓取接口费;微软推出图像与语音新模型;英伟达停止向中国发运H200;花旗银行明确AI理财盗刷不兜底。一文速览当日AI硬核动态。
DeepSeek额度墙预埋代码曝光:开源搬家工具与对话限制的48小时
DeepSeek前端代码提前两天预埋额度限制逻辑,11月15日老对话72小时不活跃即失效,同期却开源接口与客户端。本文分析额度消耗过快背后的显存压力与三股资源争夺,以及“不是不愿付费是找不到付费”的用户困境。