谷歌Gemini 4 Neon发布:百万元Token仅3美元,AI价格战再升级
谷歌、腾讯、DeepSeek、微软同日发力,AI竞争转向降本与开源。
本期AI日报聚焦“降本”与“开源”两大主线。谷歌DeepMind开放Gemini 4 Neon,智能指数全球第三,输入3美元、输出15美元每百万Token并支持100万上下文;腾讯混元开源Hy4 Flash家族,2240亿总参数、每Token仅激活120亿,原生多模态与百万上下文;DeepSeek取消联网搜索与网页抓取的接口费,仅按Token计费。微软Ignite大会推出Maya Image 2.7图像编辑模型与Mafia Realtime 1语音模型,价格显著低于竞品,并将Copilot升级为Office主入口。此外,OpenAI披露Codex沙盒策略,Hugging Face展示MoE流式加载方案,英伟达推出桌面AI主机并确认停止向中国发运H200,花旗等银行则明确第三方AI理财智能体盗刷损失由用户自担。
前沿大模型的性价比门槛正在被进一步拉低。谷歌DeepMind正式推出Gemini 4 Neon,腾讯混元开源Hy4 Flash家族,DeepSeek取消搜索抓取收费,微软和英伟达也带来一波重磅更新。这一天的AI新闻,几乎都围绕“降本”和“开源”展开。
谷歌Gemini 4 Neon:性能与价格的双重冲击
谷歌DeepMind正式开放Gemini 4 Neon,主打复杂软件工程、办公分析和科研任务的快速稳定执行。在Artificial Analysis智能指数上,最高思考模式拿下61分,位列全球第三,仅落后于更大更慢的旗舰模型。在Wales指数上以70.9%排名第二,并在法律研究、税务智能体和自动化流程测试中拿下第一。
更实用的是,在真实智能体评测中可控性排名第二,中途偏离指令的情况更少,内部测试还创下谷歌最低的“胡说八道”比例。价格方面,输入3美元/百万Token,输出15美元/百万Token,缓存输入低至0.15美元,并提供100万上下文。目前该模型已同步开放给Gemini API企业版以及AI Pro和Ultra订阅用户。对于重度写代码和做文档分析的开发者,这一定价极具吸引力。
同一天,DeepMind还对实验项目Project Genie进行了大更新,首次向符合条件的AI Ultra订阅用户开放世界模型Genie 4。用户可在浏览器中生成可交互的数字世界,并通过打字实时修改环境,例如唤来天气或添加角色,系统还会自动匹配自适应原声音效。同时上线的还有通过聊天搭建场景的专属智能体,以及支持一键二创的社区画廊。老版本Genie 3也获得更长绘画时长、前景锚定和连续场景串联升级。
Artificial Analysis智能指数是第三方评测机构Artificial Analysis维护的大模型综合能力排行榜,通过聚合推理、编程、数学、知识问答等多类基准测试的标准化得分,形成单一可比分数,常用于横向对比不同厂商模型的综合实力。该指数将模型按规模和推理成本分层排名,因此“全球第三”需要结合模型体量理解——排名靠前的往往是参数更大、单次推理成本更高的旗舰模型。文中提到的Wales指数则是另一套侧重特定能力维度的评测,二者互为补充,不宜直接换算。
缓存输入(Cached Input)计费是指当请求中重复出现相同的前缀内容(如长系统提示词、文档上下文)时,服务商将这部分Token缓存在显存中,后续调用按大幅折扣价计费。Gemini 4 Neon的缓存输入价为0.15美元/百万Token,仅为常规输入价的二十分之一,这对需要反复携带同一份长文档或代码库的智能体场景意义重大,实际成本可能远低于标称单价。
腾讯混元开源Hy4 Flash:稀疏激活架构的性价比之选
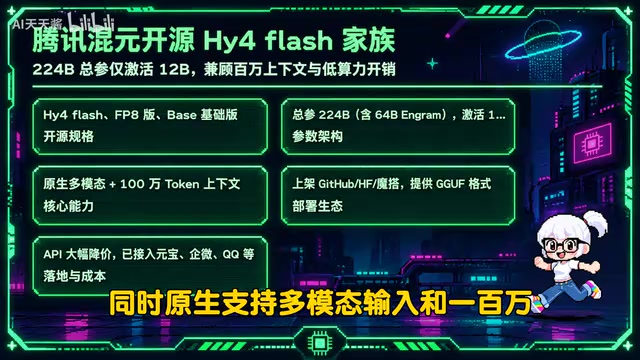
国产开源社区迎来硬货。腾讯混元正式开源Hy4 Flash家族,一次性放出标准版、FP8量化版和基础版三个规格,全部上架GitHub、Hugging Face、摩搭和Gitcode,并配齐社区常用的GDF格式和协议说明。
架构上采用稀疏激活,总参数224亿的10倍即2240亿,其中包含640亿的Ingram参数,但每生成一个Token实际只激活120亿参数。原生支持多模态输入和100万Token超长上下文,配套接口价格比之前的混元4号大幅下调,并已在腾讯元宝、企业微信、QQ和腾讯云等自家产品全面上线。对于寻找低成本长文本开源底座的团队,这波可以直接拉取权重实测。
稀疏激活(Sparse Activation)与MoE(混合专家)架构是理解Hy4 Flash性价比的关键。传统稠密模型每生成一个Token都要激活全部参数,而MoE模型将前馈层拆分为多个“专家”子网络,由路由机制为每个Token只选取少数专家参与计算。因此“总参数2240亿、每Token仅激活120亿”意味着模型的存储占用按总参数计,但推理算力和显存带宽开销按激活参数计,这正是其能以较低成本支持长上下文的原因。代价是显存容量需求仍按总参数计,部署时对显存总量要求并不低。
文中提到的FP8量化版是指将模型权重从16位浮点压缩至8位浮点格式,可将显存占用近乎减半、提升推理吞吐,同时尽量保持精度损失可控,是开源模型面向消费级或中端推理卡部署的常见做法。
DeepSeek取消搜索抓取收费:联网智能体门槛抹平
DeepSeek广告给做联网智能体的开发者发了个红包。根据官网公告,开发者通过DeepSeek API调用模型时,只要触发服务端搜索或网页抓取,不再单独收取接口费,只按正常的模型Token用量计费。覆盖范围包括自家联网工具以及兼容Anthropic接口和Responses接口的网页搜索工具。
此前这套自研搜索和抓取接口上线时定价为每千次成功请求5元,现在相当于把联网检索的门槛直接抹平。价格战已经从纯推理卷到了工具链层,正在做检索增强和联网智能体的开发者可以放心打开搜索开关,但需注意控制抓取回来的网页正文,避免输入Token暴涨。
微软Ignite大会:图像、语音与办公入口全面革新
微软在Ignite大会一口气甩出多张自研王牌。图像方面,正式推出新一代生图与修图模型Maya Image 2.7和更轻快的Flash版本,配套交互式画布Canvas。最大卖点是“指哪改哪”的精准局部修改,改物体颜色、材质或挪位置时,画面其余部分保持高度一致,且两款模型均原生支持透明背景输出,做电商商品图、图标和标志能省掉一大半抠图功夫。
评测数据也很硬:Maya Image 2.7在Artificial Analysis图像编辑榜拿到1215分登顶第一,比GPT Image 2.6高出4分,但每千张图只要35美元,成本大约只有对手的五分之一;Flash版更是低到每千张10美元。目前已在Microsoft Foundry开启公测。
语音赛道,微软推出首款自研语音对语音模型Mafia Realtime 1,专门针对真实企业通话场景打磨,支持随时被打断、等对方说完、在嘈杂环境甚至多人抢话时准确听懂需求,遇到复杂任务还能临时调用更强的推理引擎去连接企业系统办理预定和工单。
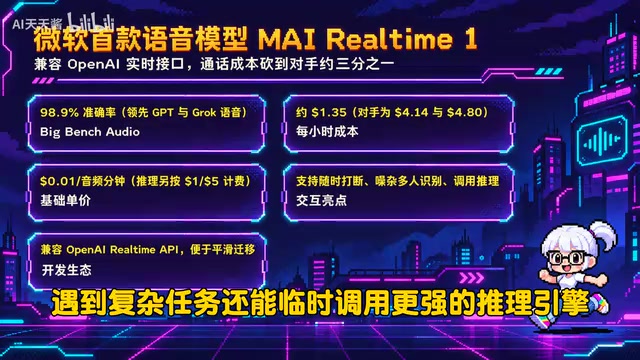
价格方面,基础语音交互每分钟仅0.01美元,在BigBench Audio基准里拿到98.9%的准确率,算下来每小时输入音频成本约1.35美元,而同测试下的GPP实时语音模型和Groker语音都要4美元出头,便宜了三分之二。更贴心的是直接兼容OpenAI Realtime接口,迁移几乎零阻力。
除了底层模型,微软还把Office彻底倒了个个:以前Copilot作为侧边栏小助手嵌在软件里,现在以新版Copilot应用当主入口,反过来把完整的Word、Excel和PowerPoint协作编辑塞进Copilot里。在聊天窗口说一句话,文档、表格或演示稿就能直接生成并在旁边打开,用户可以自己手改,也可以继续指挥AI改。所有文件默认存进OneDrive并受企业合规管控。同步亮相的还有面向销售的Copilot前沿公开版,能直接接通HubSpot、Notion和电子签等业务工具,以及帮普通职场人自动汇总邮件、日历和会议的今日概览私密预览。
OpenAI披露Codex沙盒策略:安全边界与风险并存
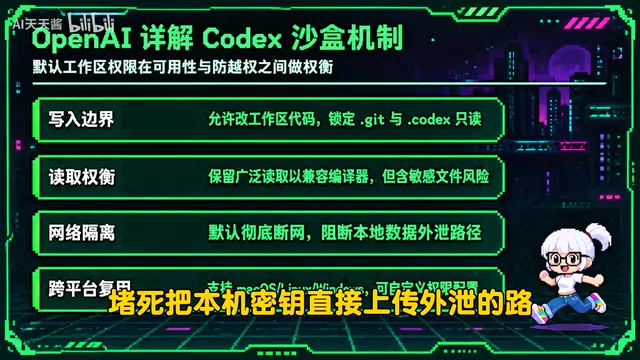
办公和写代码越来越交给智能体,如何防止它在电脑上乱敲命令成为头等大事。OpenAI发布深度技术文章,拆解了编程工具Codex的沙盒边界。在默认工作区全线配置下,Codex可以在代码目录里直接改文件,每步都会弹窗询问,但Git目录和自身配置目录被锁成只读,防止智能体偷偷改写提交钩子或篡改自身规则。
为了不把本地编译器和依赖库弄崩,Codex保留了较宽的系统文件读取权限,但作为对冲,默认彻底断网,堵死把本机密钥直接上传外泄的路。这套策略覆盖macOS、Linux和Windows,并支持按任务自定义配置,甚至可复用进自家工具。
不过官方也坦白,沙盒不是银弹,恶意代码仍可能写进本地文件。日常跑Codex时别轻易给它开全网加全盘写权限,安全底线得自己守住。
**智能体沙盒(Agent Sandbox)**是一种在操作系统层面限制进程权限的隔离机制,常见手段包括文件系统读写白名单、网络命名空间隔离、系统调用过滤(如macOS的sandbox-exec、Linux的seccomp/landlock、Windows的AppContainer)。对编程智能体而言,沙盒要解决的核心矛盾是“能力与安全的权衡”:权限过窄则无法编译、安装依赖,权限过宽则可能被提示注入攻击利用,执行恶意命令或外泄密钥。文中“默认断网”正是切断数据外传通道的关键一环,因为多数密钥外泄依赖网络回传;而“Git目录只读”则防止智能体篡改提交钩子,从而在后续合法提交中植入后门。
本地大模型突破:MoE流式加载与英伟达桌面AI主机
Hugging Face官方博客晒出一套极限压榨方案:用32GB统一内存的笔记本或消费级显卡,直接从固态硬盘流式加载专家混合模型权重,把高达1800亿参数级别的MoE大模型跑了起来。核心思路是利用MoE每次推理只用到一小撮专家的特性,将热点专家留在显存,冷门专家放内存甚至硬盘,按需流式读取。经过针对性优化后,Transformers引擎的生成速度已追到专用引擎Stratta的6%以内,解决了传统卸载方式容易在硬盘和内存间反复颠簸卡顿的问题。作者也实话实说,十几token每秒的速度跑高频代码智能体仍偏慢,但对想在轻薄本上折腾超大参数开源模型的玩家,这套流式方案值得去仓库抄作业。
英伟达则直接把现成的桌面级本地AI方案端了上来。搭载RTX Spark平台的紧凑型桌面主机由华硕、戴尔和微星率先开售,技嘉、惠普以及微软Surface开发盒也会跟进。这台小盒子塞进了20核Grace处理器、6144颗核心的Blackwell RTX显卡,配上最高128GB统一内存和万兆网口,能提供最高1000万次每秒的AI算力。官方主打用法是全天候本地跑个人AI智能体、做模型微调、直接带动1200亿参数的大语言模型,还能顺手渲染超大三维场景,把云端按量付费的账单和代码外传的顾虑一并省掉。
**MoE流式加载(Streaming MoE Loading)**的核心前提是“专家稀疏性带来的访问局部性”:不同Token激活的专家集合差异很大,但在特定任务分布下,少数专家会被高频命中。流式方案因此建立分层缓存策略——热点专家常驻显存(GPU/统一内存),温专家留在系统内存,冷专家留在固态硬盘,按需预取。难点在于预取时机与带宽瓶颈:若预测不准,就会出现“颠簸”(thrashing),即频繁在硬盘与内存间来回搬运权重,反而拖慢速度。文中提到的“统一内存”指CPU与GPU共享同一地址空间的架构(如苹果M系列、部分APU),它免去了显式拷贝开销,是笔记本跑大模型流式加载的前提条件之一。
英伟达停止向中国发运H200:算力供应链生变
据The Verge报道,英伟达临时首席执行官科莱特·克雷斯在财报电话会上正式确认,公司最新业绩指引里不再包含任何货批的Hopper架构数据中心产品,并且已经停止向中国发运H200这类AI芯片。报道提到,前首席执行官黄仁勋已于上周辞职,此前他曾力争拿到美国出口许可。而就在本月初,外媒还披露有约60万颗H200滞留在香港等待进口审批。如今公司高管直接摊牌停运,也没有说明未来是否会继续推进中国区相关业务。
对国内大模型厂商和算力租赁市场来说,这意味着短期内别再指望海外特供卡补货,国产算力和开源模型的推理适配速度得继续拉满。
花旗等银行明确:AI理财智能体盗刷不兜底
据TechCrunch报道,美国第三大商业银行花旗银行本周更新了线上用户协议,紧接着第八大银行PNC以及Citizens也跟进发出通知,明确告诉客户:只要把银行账号密码或访问权限交给第三方AI理财智能体,不管是AI自己手滑转错了钱,还是第三方工具被黑客攻破导致账号被盗刷,银行一律不兜底,所有损失全部由用户自己承担。此前摩根大通和美国银行已经出台类似政策,唯独使用银行自家提供的AI工具才不算额外担责。这也解释了为什么Anthropic月初推个人理财工具时特意强调自己只是指导、绝不碰你的钱。体验各种号称能自动管钱、自动付账单的AI智能体时,千万别图省事直接把网银账号和交易权限交出去,真出事没人替你买单。
相关推荐
Gemini 4 Neon发布:编程登顶,Gemini 4世界模型开放
谷歌发布Gemini 4 Neon,编程代理指数登顶、支持百万Token上下文;Gemini 4世界模型开放Project Genie;DeepSeek联网搜索免费;微软公开Windows端侧小模型;白宫讨论要求美企披露是否使用中国开源模型。
近8万星开源项目:本地白用26个大模型,DeepSeek、GLM全有
B站视频介绍一个近8万星开源项目,装好后本地白用26个大模型,DeepSeek、GLM全在里面,不用注册、不用填密钥,还能开本地地址供其他软件接入,适合不想充AI会员的轻量用户。
DeepSeek额度墙预埋代码曝光:开源搬家工具与对话限制的48小时
DeepSeek前端代码提前两天预埋额度限制逻辑,11月15日老对话72小时不活跃即失效,同期却开源接口与客户端。本文分析额度消耗过快背后的显存压力与三股资源争夺,以及“不是不愿付费是找不到付费”的用户困境。