Gemini 4 Neon评测:比Opus/Sol更快更省,但韩语拉胯
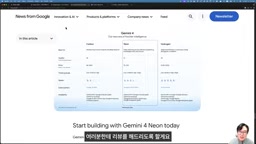
Gemini 4 Neon速度与成本领先,但韩语退步,谷歌定位趋于中间化。
韩国科技 YouTuber 实测谷歌新模型 Gemini 4 Neon 后认为,这款定价输入 3 美元、输出 15 美元每百万 token 的中端模型恰好卡在 Opus 和 Sol 之间,基准测试几乎全面领先,提示注入防御尤其突出。四类实测任务中,Neon 耗时约为 Sol 的一半,token 消耗低一个数量级,动效和网站设计完成度接近,但游戏角色细节与渲染精修略逊。韩语能力出现明显退步,创意写作中出现重复和语义混乱,博主建议韩语用户改用 Hydrogen 或 GPT。他判断谷歌在生态中正变得“中间化”,建议将 Neon 作为多模型编排中的 worker 模型,而非替代旗舰。
谷歌新模型Gemini 4 Neon的发布在AI社区引发了讨论。一位韩国科技YouTuber在实测后给出了自己的判断:这款定位中端的模型在速度和成本上大幅领先竞品,甚至在某些任务上比肩顶级模型,但韩语能力出现明显退步,且谷歌的整体定位正变得有些「中间化」。
价格与定位:卡在Opus和Sol之间
根据谷歌官方发布信息,Gemini 4 Neon的定价为输入每百万token 3美元、输出15美元。对比来看,Opus的定价为4美元/20美元,Sol为2美元/10美元。Neon恰好落在两者中间,但该博主认为「这个价差在实际体验中几乎可以忽略,可以视为同一水平线的模型」。
从谷歌公布的基准测试来看,Neon几乎在所有维度上都优于Opus和Sol,仅有三项指标例外。博主特别指出,谷歌敢于在基准测试中直接对标昨天刚发布的Sol 6.2,本身就说明「谷歌对自己的模型有充分信心,认为可以轻松碾压Sol」。
在安全测试方面,Neon的表现尤为突出。在衡量提示注入攻击抵抗能力的Grayson IPL基准上,Gemini系列模型全部排在左侧(表现最好的一端),远超Claude和GPT。博主强调,提示注入防御对API服务至关重要——如果模型容易被外部指令劫持,许多企业级服务将无法使用。
提示注入(Prompt Injection) 是一种针对大语言模型应用的攻击方式:攻击者将恶意指令伪装成正常输入(如用户提问、网页内容或文档文本),诱导模型忽略原有系统指令、泄露敏感信息或执行非预期操作。对通过 API 提供服务的模型而言,这项防御能力直接决定企业能否安全上线——一旦模型容易被外部内容劫持,客服、代码生成、数据查询等场景都会面临数据泄露与越权风险。Grayson IPL 这类基准通过构造多种攻击载荷来评估模型的抵抗力,排名越靠左代表模型越能识别并拒绝恶意指令。谷歌 Gemini 系列在此项上的优势,说明其在系统提示与内容隔离机制上做了较多工程投入。
产品线梳理:Carbon、Neon、Hydrogen各司其职
Neon的发布让Gemini产品线终于清晰起来。Carbon是旗舰级模型,性能最强但速度最慢,对标的是Anthropic的Astra和Fable级别;Neon定位中端,直接与Opus和Sol竞争;Hydrogen则承接了过去Gemini Fast的角色,主打低价和快速响应。
博主指出,Sol所在的系列(包括Terra、Astra)长期占据「短回合、低价、够用」的生态位,这个定位「大概率不会改变」。而Gemini的覆盖范围从低到高拉得很开,Neon尤其如此,可以适配不同任务对效率的需求。
有意思的是,基准测试显示Carbon优于Neon,但博主提醒这存在「后发优势」偏差——越晚发布的模型在基准上越占便宜,「不能简单说Carbon比Neon更好」。
基准测试中的“后发优势”偏差指的是:新模型往往在发布时间上晚于对比对象,因而能针对已有基准进行优化,甚至间接“见过”测试题分布。这会导致基准分数不能完全反映真实能力差距。此外,不同厂商的评测环境、提示词模板、采样参数并不统一,跨模型对比时需谨慎。博主提醒 Carbon 虽在基准上优于 Neon,但 Carbon 发布更早,Neon 可能受益于更新的训练数据和针对性调优,因此不能仅凭分数断言 Carbon 更强。理解这一点,有助于读者理性看待厂商公布的跑分表,而不是把基准排名直接等同于实际体验。
实测:动效、游戏、网站,速度碾压但细节有取舍
博主用四类任务对比了Neon和Sol 6.2的实际表现。
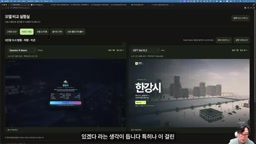
动效制作:同样的prompt下,两者产出的X光扫描动画「几乎一模一样」,在完成度和创意性上难分伯仲。但Neon只用了22分32秒、38.8万token,Sol则耗时44分42秒、消耗1600万token。博主感叹:「Gemini传统上就是token用得少、结束得早,以前是快但质量差,现在居然又快又好了。」
游戏开发:Neon生成的Roblox风格探险游戏在角色细节上略逊于Sol,但一个细节让博主印象深刻——角色奔跑时会根据速度前倾,「这个动态细节抓得很好」。Neon耗时18分19秒、31.3万token,Sol则用了49分41秒、700万token。博主认为,如果先用Tripo等工具做好3D建模,再用Neon填充逻辑,可以在保持渲染质量的同时大幅压缩成本。
网站设计:Neon的粒子动画和滚动效果流畅,整体完成度不错。但博主发现一个槽点:韩语界面把「暗色/亮色模式」翻译成了「먹색/미색」(字面意思是「墨色/米色」),「这种词我第一次见,感觉韩语表达能力反而不如以前了」。他推测这可能与谷歌近期为检测AI生成内容而引入的词汇随机化机制有关——英语单词抽象化后尚可接受,韩语则显得别扭。Sol的产出在比例上略有瑕疵,整体水平接近。
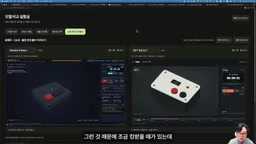
PCB电路板:两者生成的布局高度相似,Neon耗时29分4秒、46.8万token,Sol耗时56分32秒、1700万token。
四组测试下来,Neon在时间上全面领先,token消耗更是低一个数量级。博主使用Ultra套餐完成全部测试,仅消耗周用量1.9%、5小时用量11%。
韩语能力退步,创意写作不如旧版
在创意写作测试中,Neon的韩语表现让博主失望。一段描写首尔乙支路街景的文字出现了「낮아진 해를 낮아진 해를」这样的重复,以及「키 2 회색 철거 가림망」这类语义混乱的表达。博主直言:「原来的Gemini韩语还不错,但Neon明显不行,建议用Hydrogen或直接转GPT。」他同时提到Sonnet 5.5的韩语表现值得一试。
多语言能力退化是当前大模型迭代中的常见现象。模型在英语数据上投入的算力与语料占比最高,当厂商为提升推理、代码或安全对齐而调整训练配比时,低资源语言的生成质量可能被牺牲。韩语属于黏着语,依赖助词和语尾表达语法关系,词汇抽象化或随机化后更容易产生语义断裂。博主推测的“词汇随机化机制”若属实,说明谷歌为检测 AI 生成内容而在输出层引入扰动,但这种扰动对非英语语言的副作用更大。对开发者而言,这意味着不能假设同一模型在不同语言上表现一致,上线前需按目标语言单独做质量回归测试。
生态位判断:谷歌成了「中间选手」
博主对当前AI编程工具生态给出了自己的判断:Codex回合快、需要频繁介入,适合对话式开发和元提示词场景,社区对它的评价偏低「主要是因为懒人用户太多」;Claude系列在「一句话丢过去就能干完」的场景下依然最强;Gemini则卡在正中间——速度适中、质量适中、token消耗也适中。
对于「该订阅哪个」这个问题,博主的建议很直接:如果还不确定自己需要什么,选Claude,「它会自己搞定一切」;如果想要第二个订阅,稳妥选择是Codex,「毕竟它一直很稳,而Gemini是最近才刚变好的」;如果已经绑定了Gemini年费,那就把Neon当作编排中的worker模型来用——速度快、用量给得足,比用Carbon更划算。
至于是否该年付订阅,他的态度很明确:「不要年付,这个行业变化太快了。」
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。