Gemini 4 Neon深度实测:性能超旗舰却更便宜?
Gemini 4 Neon中间档定位却评分略超旗舰,长上下文与创意任务亮眼,但思考耗时拖累全程效率。
Gemini 4 Neon是Google Gemini 4家族第四款模型,支持100万Token多模态上下文,质量评分61分略高于旗舰Carbon的60分。实测中它在SVG动画、表格像素画和Three.js物理模拟等创意任务上表现扎实,GraphWalks长上下文测试以95.2%大幅领先Opus的66.8%,编程智能体指数排名第一。按任务成本比Carbon低32%,但输出Token多15%,便宜主要来自单价。速度呈现两面性:每秒输出约为Carbon两倍,但思考Token多、首字延迟高,全程耗时未必优于Opus和Soul。Google短期连发四款模型定位重叠,Neon实际取代Argon,用户需按场景权衡。
Google在短时间内接连发布多款Gemini 4系列模型,最新登场的Gemini 4 Neon定位中间档,却在多项测试中展现出超越自家旗舰的实力。它主打快速与低成本,但实际体验是否如宣传般美好?本文基于B站UP主的深度实测,结合多方数据,为你拆解Neon的真实表现。
模型定位与基本能力
Gemini 4 Neon是Gemini 4家族的第四个成员,从Carbon模型衍生而来。它支持100万Token上下文,可处理文字、图片、音频和视频,知识截止到今年3月。思考档位提供低、中、高和Extra High四档,默认开启高档。普通用户需订阅Google AI Pro或Ultra,在Gemini App的模型菜单中选择“Deeper Analysis”即可使用;开发者可通过AI Studio调用API,付费Pro和Ultra用户还能在Anti-Gravity中使用。
有意思的是,Google官方对比图显示,Neon在质量评分上得到61分,而旗舰Carbon为60分,中间档分数反而略高于旗舰。这一定位多少有些出人意料。
Token与上下文窗口:Token是模型处理文本的基本单位,可粗略理解为字词片段。100万Token的上下文窗口意味着模型在一次对话中能“记住”约70万至80万英文单词或相当规模的多模态内容,足以容纳整本书、长视频或大型代码库。上下文越长,模型越能在材料内部进行跨段落推理,但也会显著增加计算与内存开销,因此长上下文能力常与推理成本、信息保持精度一起被评测。
实测案例:创意与执行力的展现
UP主通过多个任务检验了Neon的实际能力。第一个任务是生成一个火烈鸟骑独轮车的SVG动画,要求轮子转动、脚踩踏板、背景移动且火烈鸟保持平衡。Neon耗时9分钟一次完成,画面精致,边角圆润,完全看不出是纯SVG绘制。增加海风干扰后,火烈鸟摆动更剧烈,甚至会扇动翅膀保持平衡,对物理规律的理解相当到位。
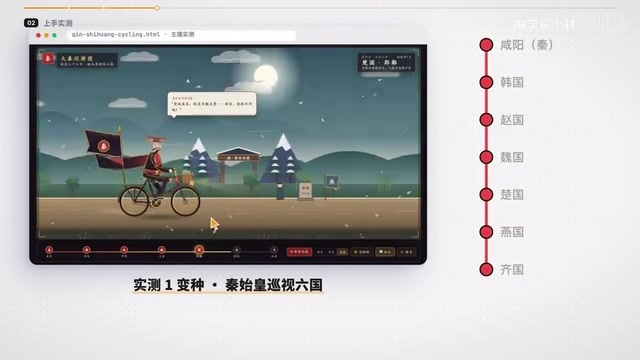
第二个变种任务要求制作秦始皇骑单车巡视六国的SVG动画。Neon用时10分钟,依次呈现咸阳、韩赵魏楚燕齐的场景,龙袍和旗帜随风摆动,车框里装着竹简和传国玉玺。细节处理用心:到达燕国时天色变暗,车头灯自动亮起;脚踏链条和车轮配合顺畅;背景用视差长卷无缝串联各国地标。
第三个任务是在Google Sheets中用单元格像素复刻Gemini 4 Neon的发布图,禁止插入图片,只能用公式和单元格填充颜色。Neon耗时约10分钟,仅要求安装一个插件并授权,之后全自动完成。主表240列99行共23760个单元格,每格填一个颜色,拼出的图像与原图基本一致。它还主动多做了三张表:一张用公式实时计算亮度、Gamma等参数;一张归纳出16种颜色的色板分析;一张存放亮度数据。全程未插入图片或使用App Script,严格遵守了要求。
第四个任务是3D加物理模拟:用Three.js制作几百个气球吊着小木屋漂浮在草原山谷的场景,按空格键剪断气球,观察房子是否下沉或倾斜。任务分三阶段完成,总计十几分钟。画面整体美观,交互正常,剪断气球后房子明显下沉并摆动,剪得越多下沉越多,补上气球后重新漂浮,360度旋转无错位。只有两处小瑕疵:白云形状和比例不太像;补充气球时房子先浮起来,物理逻辑应是气球先上升再带动房子。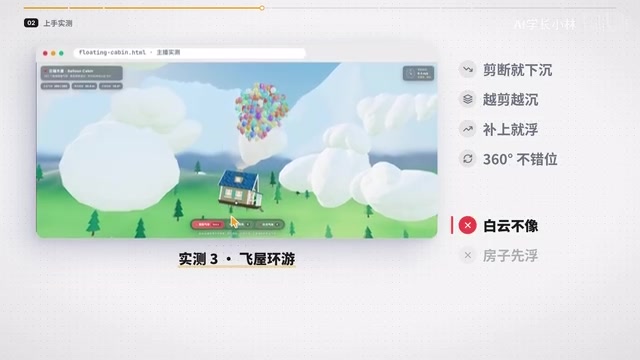
跑分与基准测试:优势与隐忧并存
在独立评测机构Artificial Analysis的智能指数上,Neon最高档获得61分,总榜第三,仅次于OpenAI的GPT 6.2 Astra和Anthropic的Claude Fable 5.2。在编程智能体指数上,Neon排名第一。
Google自家的对比表将Neon与Claude Opus 5.5、GPT 6.2 Sol比较,19项测试中Neon赢了16项。但注意,这里未包含最新的Astra和Fable 5.2。输掉的三项分别是终端任务Terminal Bench、代码任务Frontier Code(均输给Opus)以及专业图表阅读(输给Sol),差距都在两个百分点以内。
长上下文测试GraphWalks中,Neon在25万到100万Token的材料里逐层查找关系网答案,得分95.2%,而Opus仅66.8%,显示Neon在长材料中信息保持能力突出。代码测试SWE Sweep中,Neon得分39%,Opus为10.1%,表面差距近4倍;但若统一使用通用工具测试,Neon得分12.8%,与Sol的11.6%接近。这说明39%的成绩得益于Google自家Anti-Gravity工具的优势,并非纯模型能力差距。
在基于4200多次真实使用评分的Arena智能体排行榜上,Neon以1336分位列第二,仅次于Fable 5.2的1453分,领先Opus 5.5仅1分。但Neon每完成任务的中位成本为2.82美元,比Opus便宜一半以上。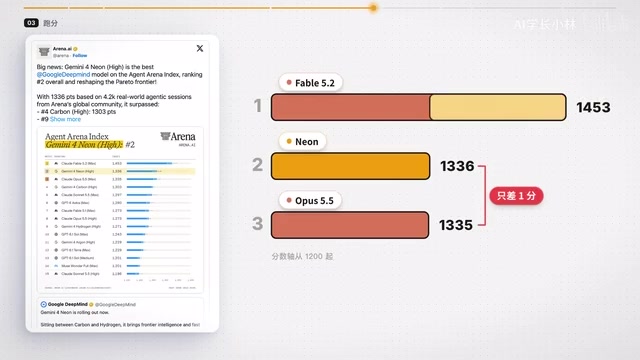
SWE-bench与智能体指数:SWE-bench类基准让模型在真实代码仓库中定位并修复问题,考察的是“读代码—改代码—跑测试”的闭环能力,而非单轮问答。智能体指数(Agentic Index)则把模型置于多步工具调用环境中,衡量其规划、执行与纠错水平。两者都强调模型与外部工具(终端、编辑器、浏览器)的协同,因此同一模型在不同工具链下的得分可能差异很大——这正是文中Neon在自家Anti-Gravity工具下得分远高于通用工具的原因。
成本与速度:宣传与现实的落差
价格方面,Neon输入每百万Token 3美元,输出15美元。Google强调按任务计算,默认高档模式完成同一任务的成本比Carbon低32%。Artificial Analysis的数据类似:最高档每任务6.44美元,Carbon为7.76美元,便宜约17%。但该机构同时发现,Neon每任务输出的Token比Carbon多15%,因此便宜主要源于单价低,而非更省Token。
速度表现则呈现两面性。与Carbon相比,Neon每秒输出约110个Token,Carbon仅57个,快近一倍;平均任务耗时21分钟,Carbon为36分钟。但与其他模型对比时优势不再。开发者Elliot用同一道CUDA调试题测试8个主流模型,Neon思考消耗的Token是Opus、Fable和Astra的3到20倍,导致同一道题Astra和Opus约20秒完成,Neon需76秒。UP主自己的测试中,题目难度不高,但平均耗时都在10分钟左右,且开头长时间不输出,一直在思考。Artificial Analysis页面显示,最高档模式下提问后56.51秒才出现第一个字,性能排名在95个模型中仅第73。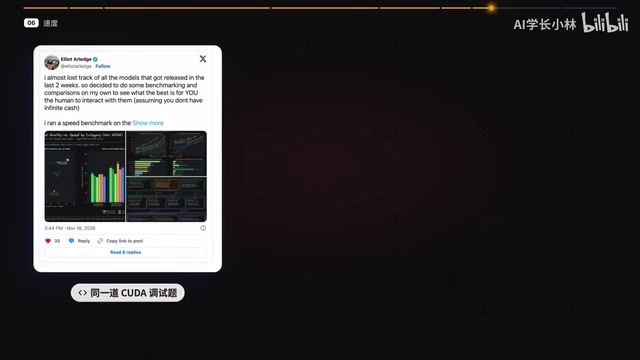
X用户对比Neon和GPT 6.2 Soul最高档,同一提示词下Neon用时20分钟花费约1.6美元,Soul用时9分钟花费0.53美元,产出质量相当。可见“快”有两种算法:每秒输出字数Neon确实快,但从提问到完成任务的全程耗时,Neon因思考更多未必领先。与Carbon比两项均优,但与Opus、Soul比则无优势。
首Token延迟与思考Token:首Token延迟(TTFT)指从发出请求到模型输出第一个字的时间,是交互体验的关键指标;思考Token则是模型在给出最终答案前内部生成的推理步骤,通常不计入用户可见输出,却计入成本与耗时。推理型模型往往用更多思考Token换取更高准确率,导致TTFT和总耗时上升。因此“每秒输出Token数”只反映生成阶段的速度,不能代表用户感知的端到端效率,评估时需同时看首字延迟、总耗时和任务成本。
发布节奏与选购建议
Google近期的发布节奏被一位DeepMind员工总结为:想要更聪明发了Argon,再聪明一点4周后发Carbon,要快两天后发Hydrogen,又要聪明又要快6天后发Neon。四款模型定位重叠,用户难以选择。Neon实际上取代了Argon的位置——更聪明,价格仅为Argon原价的四分之三。
对于已订阅Google AI Pro的用户,在菜单选择“深度分析”即可使用Neon,无需额外付费,适合查资料、读文件、写东西时尝试。开发者若正在用Carbon,优惠期仍在,不必急于更换;12月后Neon会更便宜,成绩也不差,可用自己的任务分别跑一遍对比。特别在意速度的话,别只看每秒生成字数,最好实际计时完成同一件事的总耗时。
综合来看,Gemini 4 Neon在智能和成本上确有亮点,长上下文和创意任务表现突出,但思考时间长导致全程效率未必占优。模型迭代过快也带来选择困惑,用户需根据自身场景权衡。
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
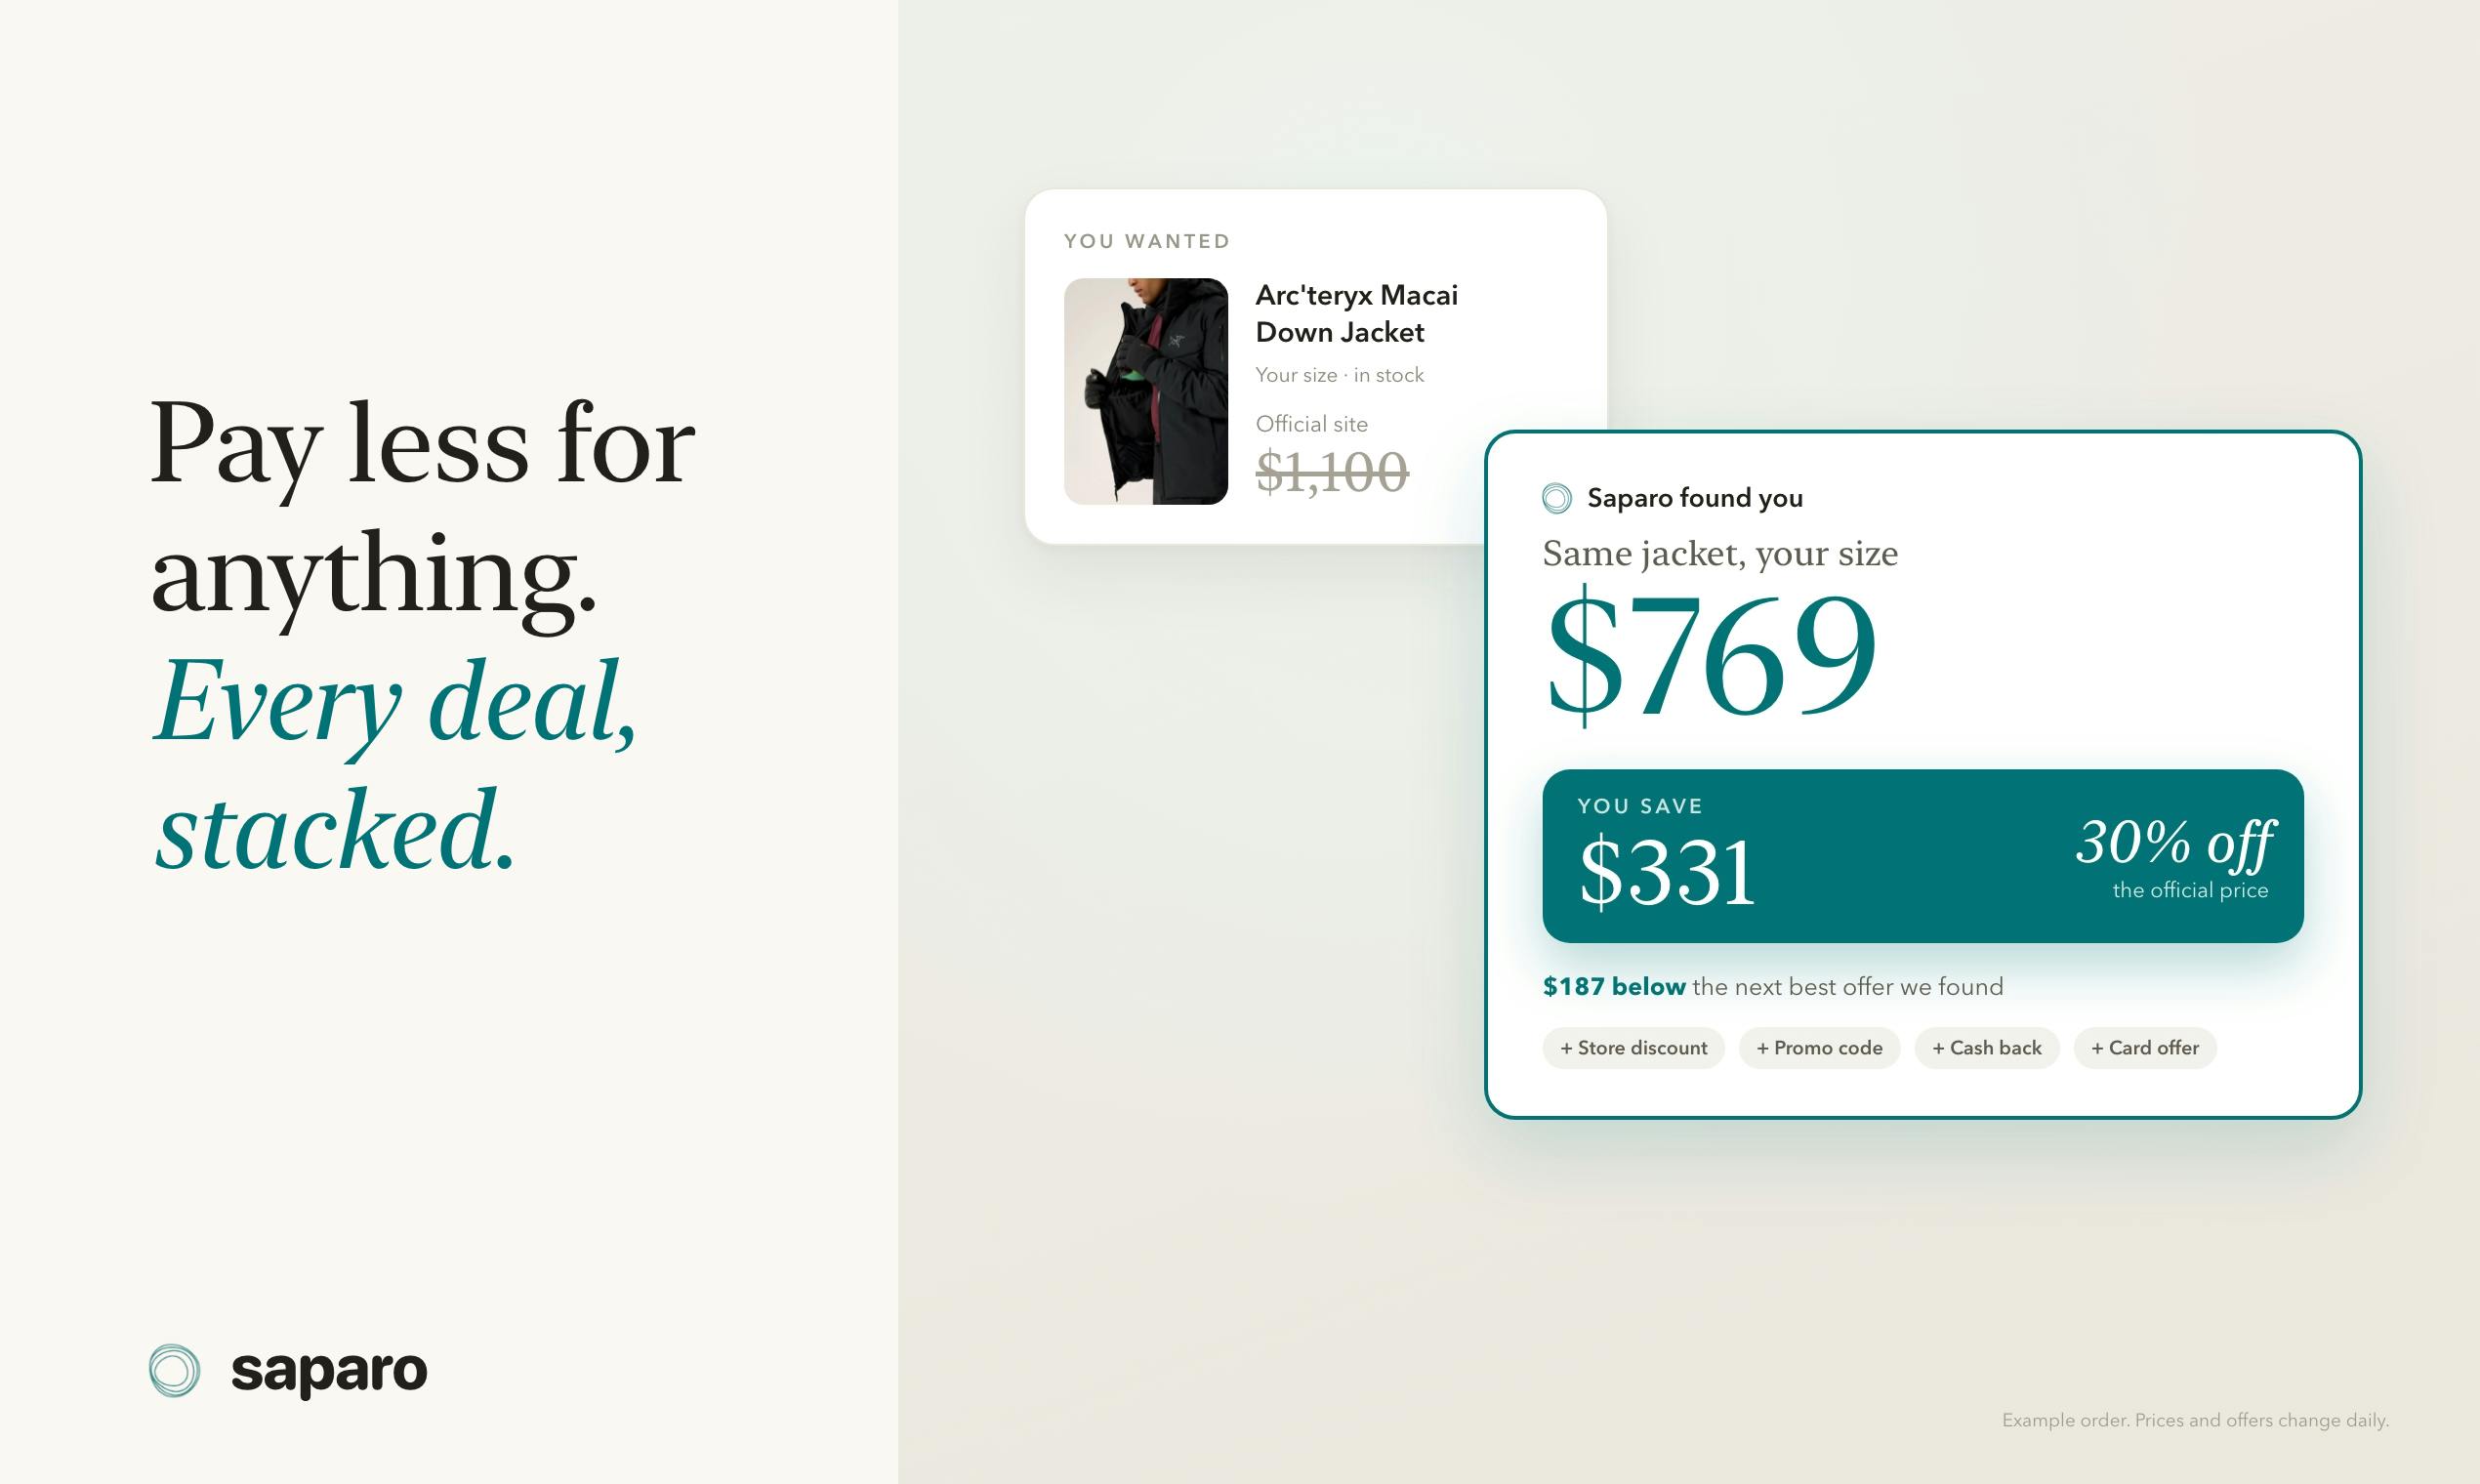
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
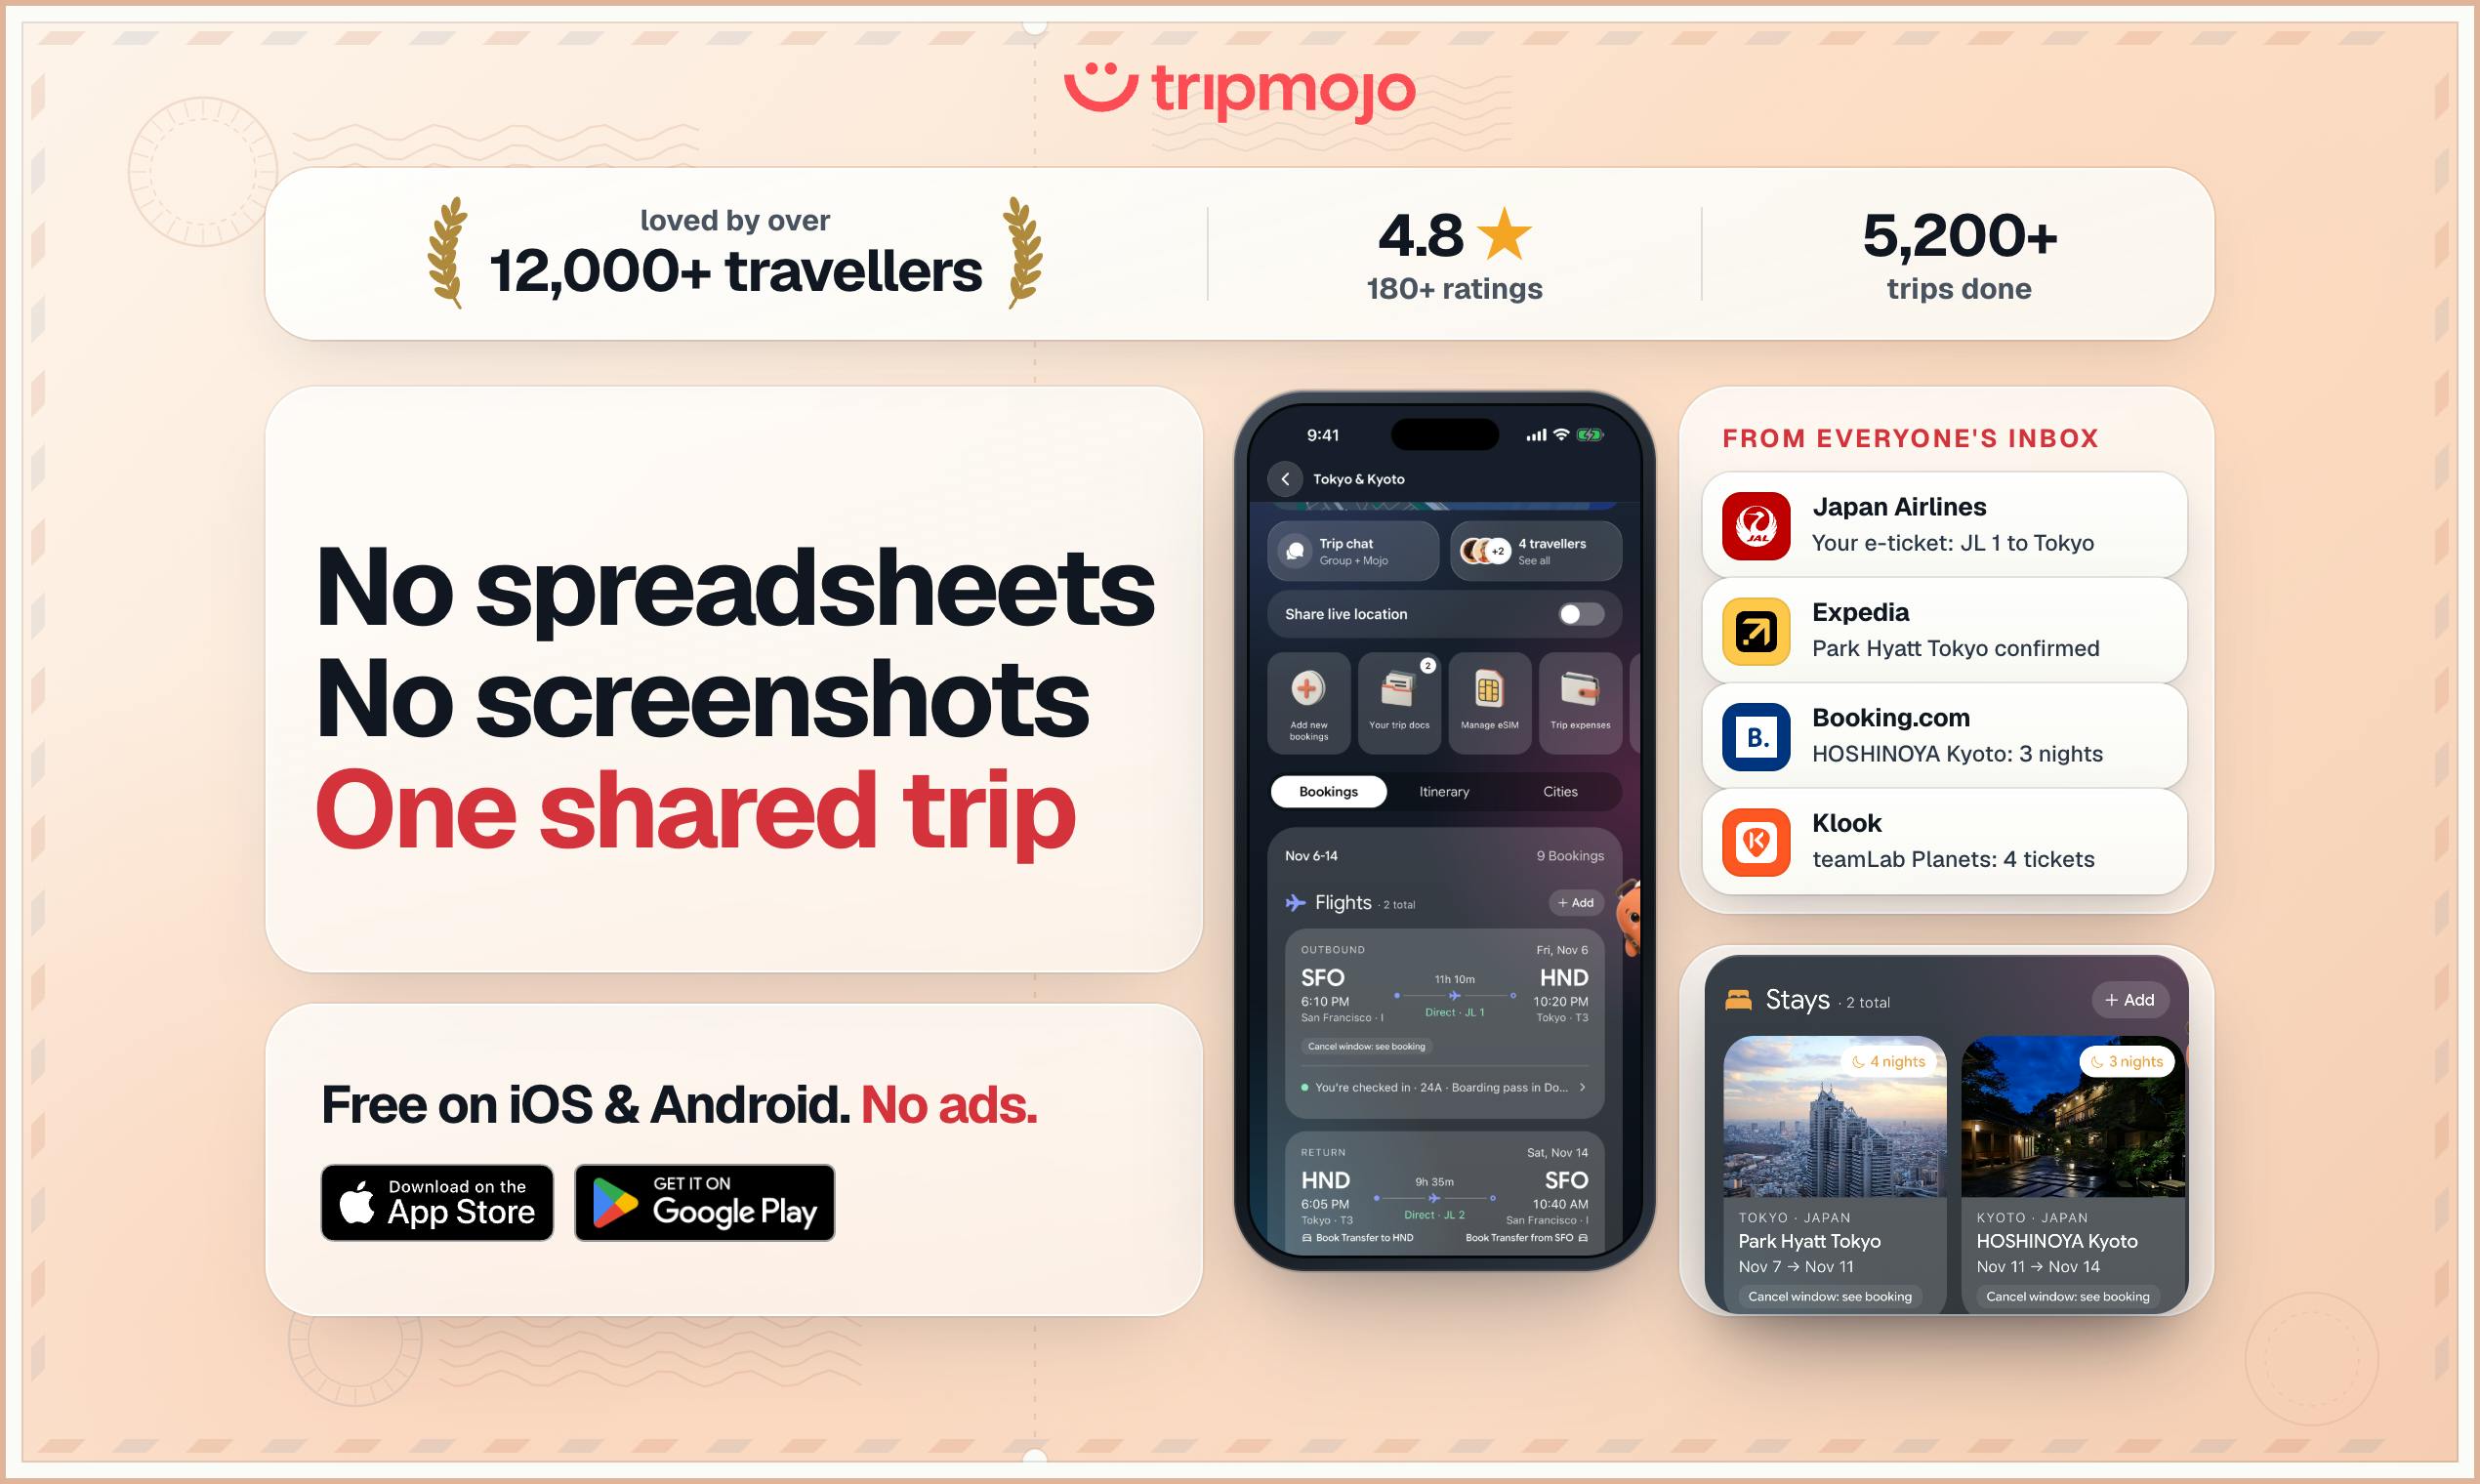
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。