#长上下文
共 28 篇相关文章

长上下文LLM计费新框架:缓存降本两个数量级,但折扣有边界
长上下文LLM服务如何为重复上下文计费?研究提出内容相关性、可观测代理与位置权重三层框架,实测缓存命中使重复前缀成本降两个数量级以上,校准模拟将99分位账单降低31-42%,但中位账单上升。

长上下文MoE训练内存峰值优化解析
解析长上下文混合专家模型训练中的内存峰值问题,探讨动态重计算、异构内存调度等削峰技术路径及其对训练扩展性的影响。

Maxwell-V1-Flash:35B总参3B激活的MoE长上下文模型
Maxwell-V1-Flash 是 Maxwell Team 发布的开源 MoE 语言模型,35B 总参数、3B 激活参数,支持 256K 上下文。核心亮点是块稀疏注意力 MBSA 在 256K 下比稠密 GQA 快 6.7 倍,配合细粒度 MoE 与多分支 RL 后训练。
线性注意力图解指南:从Delta Rule到Gated DeltaNet与Kimi Linear
Reddit 作者发布四部分线性注意力图解指南,梳理从早期 Linear Attention 到 Delta Rule、Gate Rule、Gated DeltaNet 与 Kimi Linear 的演进脉络,用插图解释算法直觉,适合想系统入门长上下文高效注意力的读者。

阿里Qwen4-Max发布:2.4T MoE架构、百万上下文
阿里发布Qwen4-Max旗舰模型:2.4T MoE架构、71B激活参数、原生视觉与100万token上下文,输入定价每百万token 1.5美元,Work360基准单任务成本降低62%。本文解析其架构取舍、成本逻辑与闭源旗舰策略。
加权状态汤:突破SSM长上下文检索瓶颈
NeurIPS 2026 PALM Workshop论文提出加权状态汤方法,通过为独立编码的SSM状态块分配查询相关权重,缓解长上下文拥挤导致的性能退化,实现高效检索。

无需训练:LongCapHarness 如何激发大模型长上下文推理潜能
LongCapHarness 提出一种无需数据合成和模型后训练的长上下文推理增强框架,通过递归自我改进驾驭模型潜在能力,在 HELMET 和 RULER 基准上显著优于数据合成基线,开发成本不到 NExtLong 和 PolicyLong 的一半。
RidgeFill:免训练后层缓存填充,预填充提速最高1.6倍
RidgeFill提出免训练的后层缓存填充方案:用闭式岭回归拟合层间映射,跳过模型后段大部分层的预填充计算,在长上下文场景实现最高1.6倍首token加速,同时如实呈现RULER和LongBench的精度代价。

递归稀疏注意力RecSA:百万级上下文外推,对数级成本
RecSA递归稀疏注意力通过树结构KV缓存实现O(log L)选择成本,从32K训练长度外推到2M,1M长度RULER得分60.5远超基线,单张H200上预填充加速3.2倍。

长上下文失效真相:干扰竞争比长度更致命
新研究发现长上下文检索失败主因是干扰项竞争而非长度。中性填充下准确率保持0.97以上,同格式竞争陈述可致损失扩大百倍,注意力质量解释58%方差。

Zyphra推出ZHA:让冻结LLM实现亚二次注意力的新路径
Zyphra AI 提出 Zyphra Hierarchical Attention(ZHA),一种树索引稀疏注意力方法,通过 4B tokens 蒸馏改造冻结 LLM,在推理和 256K 检索基准上匹配稠密注意力,探索亚二次注意力的实用路径。

ZHA:树状索引器如何实现亚二次注意力
Zyphra 提出 ZHA 层级树状索引器,让稀疏注意力的路由与计算总成本随序列长度亚线性增长,实现亚二次缩放;仅需短 KL 蒸馏即可迁移到现有预训练模型,并在长上下文检索与推理任务上保持性能。
RAG已死?长上下文模型真正改变了什么
长上下文模型是否让RAG过时?本文从容量约束、信噪比、成本延迟三个角度分析长上下文真正改变了什么,并给出检索与长上下文混合架构的选型判断框架。

低比特量化新突破:GGA+PW让线性注意力长文本生成更准更短
低比特GDN循环状态量化新方法:GGA按梯度敏感度分配头比特宽度,PW用FP8滑动窗口维护近期写入。在Qwen3.5-4B/9B七项评测中,GGA+PW-S8较STEPQuant@4提升38.39/41.21个百分点,同时显著缩短平均生成长度。
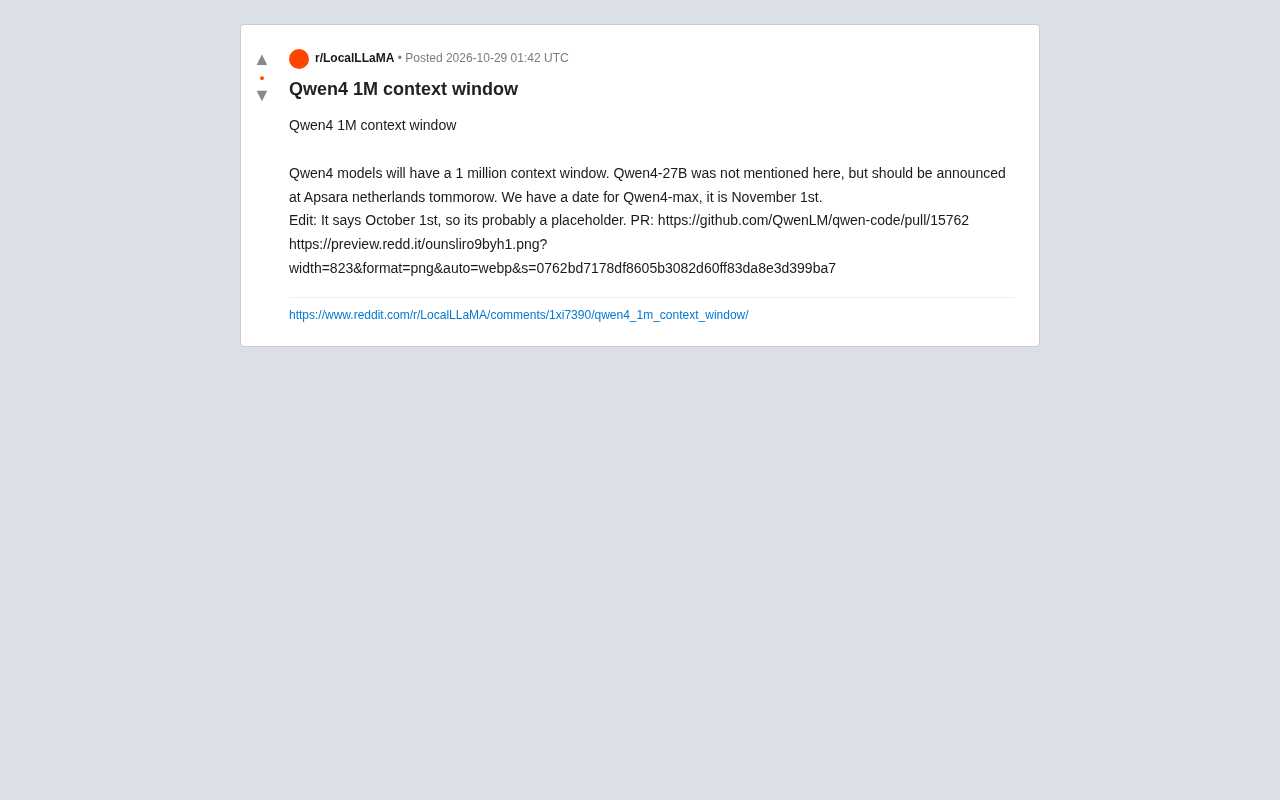
Qwen4 百万上下文窗口曝光:27B与Max版本即将登场
Reddit 爆料称 Qwen4 全系将支持 1M 上下文窗口,Qwen4-27B 或在荷兰 Apsara 大会公布,Qwen4-max 日期疑为占位符。本文梳理爆料细节并分析百万上下文对开发者的实际影响。

MERLIN:用二阶路由提升线性注意力长上下文能力
MERLIN提出一种面向多状态线性注意力的二阶矩路由方法,通过追踪键的均值和方差实现更内容感知的聚合,在Gated DeltaNet和Mamba-2上显著提升长上下文任务表现。
Mirendil发布Fern 0.1:首个模型剑指千万级上下文
Mirendil发布首个从零预训练的模型Fern 0.1,上下文窗口达10M token,RULER单针检索10M长度下满分,但智能体编程能力落后前沿模型。本文解读其定位、性能与行业意义。

TokenGate:斯坦福伯克利新注意力机制让长上下文预填充提速11.3倍
斯坦福与UC Berkeley提出TokenGate,通过令牌门控注意力机制加速长上下文预填充,声称最高提速11.3倍。本文解析其核心思路、潜在应用与待验证问题。

斯坦福伯克利TokenGate:长上下文预填充提速11.3倍
斯坦福与UC伯克利发布TokenGate,一种学习式token剪枝模块,让LLM长上下文预填充时间到首token加速1.4至11.3倍,峰值内存降低1.5至3.4倍且不损失精度,本文解析其机制与落地价值。

DeepSeek V4.1 Flash 1017对比MiniMax M3.1 Flash实测:正式版交付仍难言全面超越
基于B站UP主实测,DeepSeek V4.1 Flash 1017与MiniMax M3.1 Flash正式版在10万Token长档案、代码与调度任务上的交付对比:核心交付DeepSeek占优,但三者复杂决策稿与严格交付集体未达标,正式版未能全面超越Preview。