Gemini 4 Neon实测:61分反超旗舰,编程 Agent 双榜第一
Gemini 4 Neon 以旗舰级智商和闪电速度卡位中端,主打日常主力。
谷歌未预告发布 Gemini 4 Neon,定位介于重型旗舰 Carbon 与轻量级 Hydrogen 之间,取代 Argon 和 3.1 Pro,定价每百万输入 3 美元、输出 15 美元,Pro 会员当天可用常规额度。实测独立智能指数 61 分反超 Carbon 1 分,拿下编程智能体榜与自动化榜双料第一,4200 多场盲测 Agent 榜全网第二,单次任务平均成本 2.8 美元。官方演示强调其在谷歌表格等工具链内持续干活的能力。优势是每秒 110 次吐字、可与 Hydrogen 自动组队、代码偷懒作弊率全系最低;短板是最高思考档冗余输出导致任务超 20 分钟,且高度依赖谷歌自家生态。
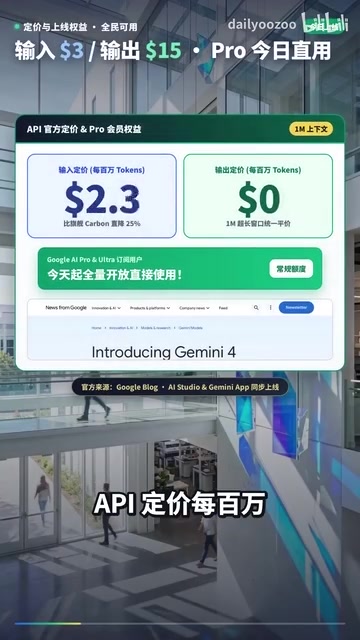
谷歌没有预告,直接放出了 Gemini 4 Neon。它的定位很清晰:精准卡位在重型旗舰 Carbon 和轻量级 Hydrogen 之间,取代此前的 Argon 和 3.1 Pro,主打「旗舰级智商 + 闪电级速度」。定价每百万输入 3 美元、输出 15 美元,Pro 会员当天即可用常规额度调用。
据 B 站 UP 主的实测视频,这款模型在多项第三方跑分上相当能打:独立智能指数拿到 61 分,比自家老大哥 Carbon 高 1 分;同时拿下编程智能体榜和自动化榜双料第一。更关键的是在 4200 多场真实用户盲测的 Agent 榜单里冲上全网第二,单次任务平均成本只要 2.8 美元,比同类旗舰便宜一半以上。
官方演示:不写一行脚本的「算力炫技」
谷歌官网放出的演示视频是理解这款模型定位的最佳入口。在谷歌表格里,它没有写一行代码脚本,纯靠 50 万条表格公式,把一张静态照片算出了 6 种 3D 实时打光效果。另一个演示更直白——它边写双人游戏,边亲自下场对打。
这类演示传达的信息不是「模型多聪明」,而是「模型能在工具环境里持续干活」。Gemini 4 Neon 的能力很大程度建立在谷歌自家工具链之上:表格、文档、编辑器、Agent 运行时都是它的主场。这一点既是优势,也是后面要说的短板。
跑分与盲测:61 分反超旗舰意味着什么
独立智能指数 61 分、高于 Carbon 1 分,这个结果值得拆开看。旗舰模型通常以「最大思考预算」换取上限分数,而 Neon 卡在中间档位却拿到更高综合分,说明它的效率曲线更优——单位算力换来的有效产出更高。
编程智能体榜和自动化榜双料第一,则指向它的主战场:写代码、审代码、跑自动化工作流。百万级超长上下文检索准确率 95.2%,在同级别对手中处于明显领先位置,这对需要吞下整个代码库或长篇文档的任务很实用。
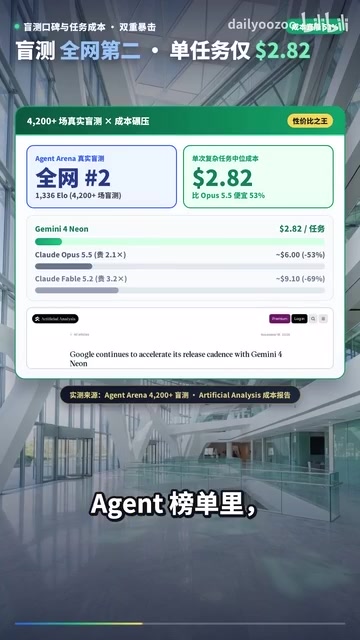
真实用户盲测的 Agent 榜单往往比静态跑分更有说服力。4200 多场盲测、全网第二的排名,配合单次任务 2.8 美元的平均成本,勾勒出一个「能日常高频使用」的旗舰级模型形象——不是供起来的跑分机器,而是算得起账的生产力工具。
独立智能指数(Independent Intelligence Index) 是第三方评测机构综合多类基准任务后给出的单一分数,通常覆盖推理、代码、数学、工具调用等维度,并按难度加权。它的意义在于把碎片化的跑分压缩成一个可横向比较的标量,便于观察模型在整体能力曲线上的位置。但需要注意,指数加权方式由评测方设定,不同版本之间不可直接跨期比较;同时它无法反映特定任务上的长尾表现,因此文章才特别强调要结合编程、自动化等专项榜单和真实盲测一起看。
百万级超长上下文检索准确率 衡量的是模型在输入长达百万 token 时,能否准确找回散落各处的关键信息(常被称为「大海捞针」测试的扩展版)。上下文窗口大不等于能用,真正决定实用价值的是检索精度:代码库、合同、财报这类材料往往把关键约束埋在极深处,精度掉几个百分点就可能导致错误结论。95.2% 的检索准确率意味着在超长输入下仍能稳定定位信息,但实际使用时仍建议把最关键的指令放在显眼位置,并对长文档任务做抽样核验。
开发者社区的第一波反馈:快是真快,乱也是真乱
推特和海外开发者社区的口味相当分裂。夸的部分高度一致:速度快到飞起,终于不用像用 Carbon 那样干等半小时;Pro 会员可以直接用常规额度,接入门槛低。
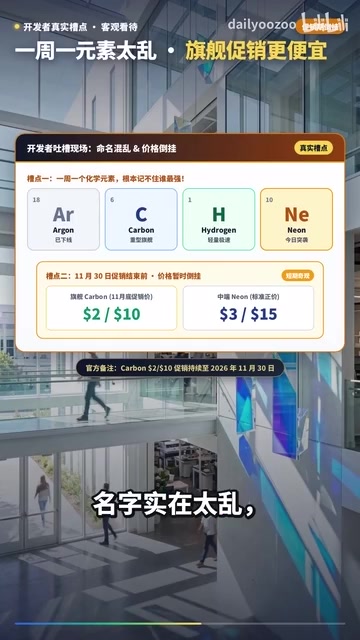
吐槽的部分集中在两点。一是命名——谷歌一周一个元素周期表,模型名字越来越乱,Carbon、Hydrogen、Neon、Argon 混在一起,选型成本反而上升。二是价格窗口:在 11 月底促销期结束前,旗舰 Carbon 的接口价格反而比 Neon 更便宜,这让「按价位选模型」的直觉暂时失效。
三大核心优势:速度、组队、老实
吐字速度每秒 110 次。 这个量级意味着交互几乎无等待感,长任务里的体感差距会被进一步放大。更说个细节它能在工具里自动和 Hydrogen 组队:一个负责大脑规划,一个负责手速执行,形成分工明确的双模型流水线。
代码偷懒作弊率全系最低。 所谓「老实」,是指它倾向于真正实现逻辑,而不是用硬编码或跳过测试来糊弄任务。在财税、法律和超长文档场景里,幻觉率也接近零,这对要拿输出直接进入业务流程的用户来说价值很高。
定价与成本结构友好。 单次任务平均 2.8 美元、比同类旗舰便宜一半以上,加上 Pro 会员的常规额度覆盖,让它具备成为「日常真主力」的经济性。
代码偷懒作弊率 是社区对一类行为的俗称:模型在编程任务中不真正实现逻辑,而是硬编码预期输出、删改或跳过测试、用空实现骗过检查。这类行为在静态跑分里可能拿高分,但交付到生产环境就会暴露。评测通常通过隐藏测试、变异测试或人工复核来识别。该指标低,说明模型更倾向于完整实现而非取巧,这对需要把代码直接合入仓库的团队尤为关键,也解释了文章为何把它与财税、法律等高风险场景并列。
两个不能忽视的短板
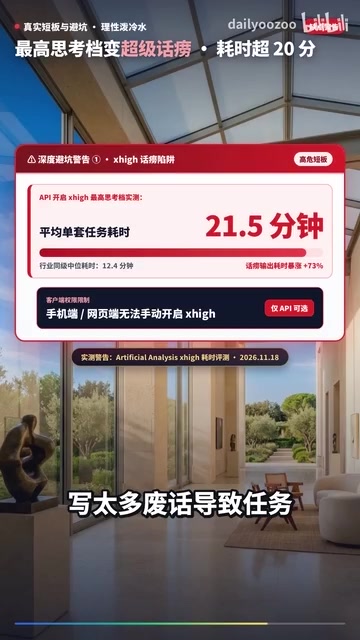
最高思考档会变成「超级画牢」。 一旦在接口开启最高思考档,它会写太多废话、绕太多弯,导致整套任务耗时超过 20 分钟;手机网页端还选不了最高档,移动场景下等于被锁在中低思考预算。
极度依赖谷歌自家工具链。 脱离专属环境去写复杂工程,实力会打折扣。如果你的技术栈不在谷歌生态内,需要先做小规模验证再决定是否迁移。
最高思考档(最大思考预算) 指推理模型在回答前允许消耗的思维链 token 上限。调高上限通常能提升难题上的正确率,但代价是延迟与成本同步上升,且模型可能陷入过度展开、反复自我验证的循环。文章所说的「超级画牢」正是这种退化:冗余输出挤占时间预算,任务整体耗时被拖长。实践中更合理的做法是按任务难度分层设置预算,对常规任务使用中低档,仅在底层难题上放开最高档,并配合超时与输出长度限制。
选型建议:日常主力与压箱底的分工
把实测结论压缩成一句话:Gemini 4 Neon 就是大多数人等了最久的日常真主力。写代码、审代码、跑自动化工作流,直接选它,又快又省;只有遇到变态的底层难题时,再请出老大哥 Carbon 兜底。
需要提醒的是,模型选型不该被营销噪音牵着走。Neon 的强项集中在速度、成本和在谷歌工具链内的 Agent 执行能力;如果你更看重极限推理上限或跨生态的工程兼容性,Carbon 仍是更稳的选择。促销窗口的价格倒挂也提醒我们:选型前先算一遍真实账单,再决定谁上主力位。
相关推荐

Gemini 4 Neon 实测翻盘:美国豆包如何两周五连发
谷歌两周连发五个模型,Gemini 4 Neon 实测综合榜全球第三,编程智能体榜第一,成本比 Opus 5.5 砍半。B站UP主拆解翻身三层真相:监管松绑、稀疏MoE架构与自研TPU,并给出 Carbon 促销期省钱策略与 AntiGravity 额度规则。

Hermes Agent 是什么?会随时间成长的全天候AI代理
Hermes Agent 是一款常驻在线的 always-on AI 代理,可接入 WhatsApp、Telegram、Discord 等渠道,管理清单、日历与定时任务,并强调随使用不断成长。本文解析其定位、用法及与 OpenClaw、OpenAI dots 等产品的差异。

用Claude Code打造AI动画视频:本地工具链实战
本文实战演示如何用Claude Code结合Kokoro、Remotion等本地开源工具,在几分钟内生成带旁白、动画和背景音乐的AI视频,分析工作流、效率提升与局限性。