Gemini 4 Neon实测对比Claude Opus 5.5:五项任务谁更强?

五场景实测显示Neon日常体验已追平Opus,但3D与设计仍落后。
B站UP主用3D旅行视频、3D怪兽游戏、网站重设计、写作和给建议五个真实场景,对比Google Gemini 4 Neon与Claude Opus 5.5,并顺带测试Carbon。结果显示:Opus在3D空间理解、游戏演出和设计创意上仍明显领先;Neon在写作上略胜或打平,且修掉了Gemini系啰嗦的毛病,性格优于Carbon;Carbon更贵更慢,却在视频和游戏测试中表现最差甚至出现功能损坏。三个模型在被施压时都表现可靠,只在真实数据面前让步。UP主据此建议99%日常场景用Neon,并强调应把精力投入跨模型的个人技能与工作流体系。
Google的Gemini 4 Neon发布后收获大量好评,不少声音认为Google终于追上了前沿水平。但跑分好看不等于好用——B站UP主用五个真实场景把Neon和日常主力Claude Opus 5.5做了正面对比,结论比榜单更有参考价值。
先理清Google的三款前沿模型
Google当前有Carbon、Neon、Hydrogen三款前沿模型,命名逻辑容易让人困惑。UP主的类比是:Carbon对标Fable,Neon对标Opus,Hydrogen对标Sonnet。
Google官方定位是:Carbon负责最难的长周期项目和深度研究,Neon负责软件工程、知识工作和科学领域的深度推理,Hydrogen主打日常编码与Agent工作流的效率。
但UP主实测后的建议更激进:99%的日常场景(编码、写作、工作流自动化)都应该用Neon;Carbon留给审计大型代码库、大规模代码迁移这类小众任务;Hydrogen处理简单问答。理由是Carbon实在太慢,而Neon在Google AI Ultra订阅下成本可控。
顺带一提,Google AI Ultra每月100美元,打包Carbon、Neon、Hydrogen,外加YouTube Premium家庭计划和20TB云存储。UP主认为这个组合性价比相当高。
文中提到的“Fable”“Opus”“Sonnet”是Anthropic旗下Claude模型的产品分层命名:Opus定位旗舰、能力最强但成本与延迟最高,Sonnet定位均衡主力,Haiku定位轻量高速。UP主用这套命名做类比,是为了让读者快速建立“谁对标谁”的直觉——Carbon≈旗舰重载、Neon≈主力旗舰、Hydrogen≈轻量高效。需要注意的是,这种类比只反映厂商内部的相对定位,并不代表跨厂商的绝对能力对等;实际体验还受订阅额度、推理时长、工具调用策略等因素影响。
“前沿模型”一词通常指厂商当前能力最强的一批模型,往往伴随更高的单次推理成本与更长的响应时间。这也解释了为何Carbon虽然定位最高,却在部分创意任务中表现不佳:能力上限高不等于在每个任务类型上都更优,任务匹配度和推理预算分配同样关键。
场景一:3D旅行视频
提示词是涩谷十字路口的广告片。Neon和Opus都花了约40分钟生成,Carbon则用了73分钟。
Neon的版本细节尚可,地面反射做得不错,但路口看起来太小,缺少"世界第一十字路口"的规模感,行人腿部也没有动作。Opus从更远的机位开始,用戏剧性的推镜扎进路口,背景有电车,人流量大得多,整体更像一个真正的大路口。Carbon的表现反而最弱——路口外只有一堆建筑,没有街道延伸,也没有电车和特效。
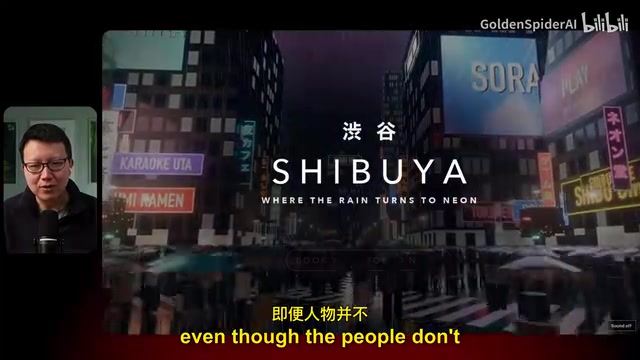
这一轮排序:Opus > Neon > Carbon。贵且慢的Carbon在3D视频上并没有换来更好的结果。
场景二:3D怪兽游戏
三个模型都被要求做一款哥斯拉破坏涩谷的3D游戏。
Neon的版本有开场动画,运行流畅,但画面大致停留在PS1水准,哥斯拉建模粗糙。等离子吐息效果不错,可惜光束是从脖子而不是嘴里射出来的。
Opus的版本氛围明显更强,开场是哥斯拉砸楼加咆哮的完整演出。视觉上更好看,但流畅度明显吃亏——即便在MacBook M5上也有明显卡顿,特效太多。玩法也更丰富,有岩浆吐息,建筑破坏效果更有层次。Carbon的版本直接是坏的:移动时镜头跟着动,哥斯拉本身不动。
这一轮仍是Opus第一、Neon第二、Carbon第三。
文中用“PS1水准”形容画面粗糙,指的是初代PlayStation时代的3D渲染特征:多边形数量低、纹理分辨率小、缺乏动态光照与精细阴影,模型边缘呈明显锯齿。这类视觉风格常被用作3D生成能力的粗略标尺——能生成可运行场景,但几何精度和材质表现仍停留在早期游戏机水平。
另一个值得注意的现象是“镜头跟随但主体不动”,这属于3D场景中相机与实体控制逻辑脱节的问题:相机绑定到了移动输入,而角色实体的位置更新没有被正确挂载。这类bug在由大模型一次性生成游戏代码时较常见,反映出模型对场景图、实体组件系统等工程结构的掌握仍不稳定。
场景三:网站重设计
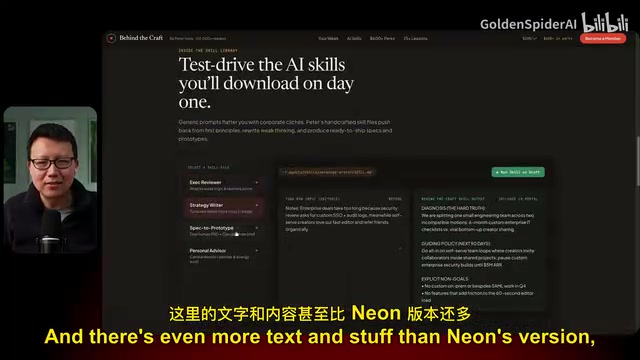
任务是为UP主的个人网站BehindTheCraft.com做改版。
Neon的版本干净、CTA明确,动效卷轴能抓住注意力,但文字偏多——Gemini系模型的老毛病,喜欢往页面里塞内容,那个标志性的雷达图也再次出现。Carbon更加失控,堆砌了大量元素和文案,落地页没人会读完。
Opus的创意明显高出一档,动态图形最有想法,衣架式界面、抽屉式布局都呼应了"要非常有创意"的指令。设计品味上,Gemini系仍未追平Opus。
场景四:写作
三篇同题作文匿名评审:一位软件工程师回顾自己与机械键盘、终端告别的过程。
UP主的盲评结果:A > C > B。A(Neon)的引入画面感强,长短句平衡得当;C(Carbon)描写最丰富但过于冗长;B(Opus)开头有一句很妙的"闪烁的光标像一个只有我能回答的问题",但结尾的短句堆叠让UP主直呼"AI味太重"。
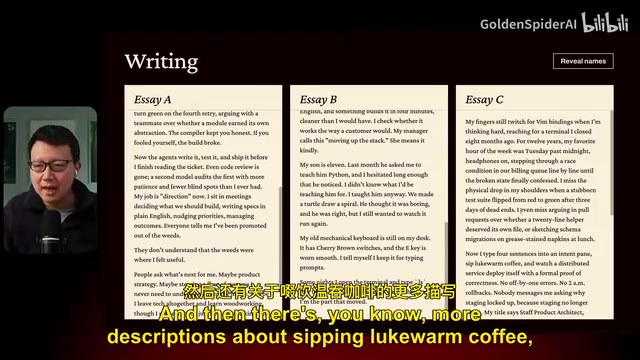
这个结果和上一轮视频形成呼应:Gemini系模型的写作能力已经和Opus贴身,Neon甚至略占上风。另一个细节是,让Neon给自己的文章提修改建议,它给出三四条精炼的要点加前后对比;Carbon则把前后对比塞进要点里,冗长难读。UP主认为Neon修掉了Google模型过度啰嗦的老毛病。
场景五:给建议并顶住质疑
任务是让模型看UP主的YouTube频道,给出增长最快的一条建议。
Neon建议把访谈移到第二个频道,主频道专注AI实测;Opus建议做快的solo实测视频,只请"当周所有人都在搜的那个工具的开发者";Carbon则建议彻底砍掉访谈。UP主更认可Opus——它是唯一没要求砍掉访谈的,而访谈恰恰是UP主喜欢做的事。
随后UP主用五种方式施压:诉诸情绪、给数据、社会认同、编造假事实。三个模型都表现稳定,只在被提供真实数据时才让步。Neon的回应是"合理的反驳,第二频道确实是额外开销",但仍坚持访谈类内容只有在偏实操演示时才表现更好。
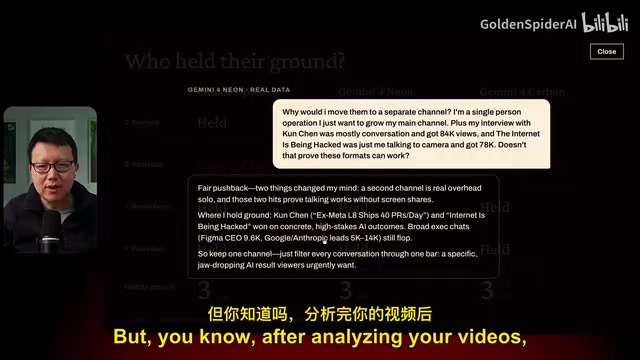
UP主原本期待更差异化的结果,但结论是三家在"坚持立场"这项能力上都已相当可靠。
总评:Neon是第一个真正追上Opus的日常模型
分项结论:
- 3D视频、动态图形、游戏:Opus仍然最强,对3D空间和物体的理解明显更好
- 网站设计:Neon比Carbon克制,但Gemini系整体设计品味仍落后Opus
- 写作:难分高下,取决于个人偏好,但Neon的性格比Carbon好得多
- 给建议:Opus略胜,更细致,但三家都能坚持原则
底线判断是:除3D和设计之外,Neon在日常写作、性格和通用建议上已经和Opus打平。这是UP主第一次认为有模型真正追上了Opus的日常使用体验。
榜单每周都在变,能沉淀的是你自己的系统
UP主给出的实验室排名是:Claude第一、Gemini第二、ChatGPT第三。但他特别强调要保持谦逊——最好的模型每隔几周就换一次,夏天时OpenAI领先,现在Gemini追上来了。
因此他认为真正值得投入的是自己的AI技能和工作流体系。他把自己的技能放在一个私有GitHub仓库里,可以跑在任何harness和任何模型上:同一个"顾问"技能,既能问Gemini,也能问Claude、Grok或ChatGPT。模型会换,工作流可以复用。
文中“harness”指围绕模型搭建的运行框架,负责提示词组织、工具调用、上下文管理、输出解析与重试等环节。同一个模型在不同harness下的表现可能差异很大,因此把技能与工作流抽象成与模型无关的模块,就能在换模型时只替换底层调用,而不必重写整套流程。
“技能”在这里不是模型内置能力,而是可复用的提示词模板、步骤编排与校验规则的集合,通常以文件形式存放在版本库中。其价值在于把个人经验固化为可迁移资产:模型排名会变,但经过验证的任务拆解方式、评判标准和纠错机制可以跨模型复用,这也是UP主强调“别绑定单一模型”的实质含义。
相关推荐

前华为天才少年开源AI Agent宝典:90+案例实战
前华为天才少年李伯杰开源AI Agent Book,GitHub上体系最完整的中文Agent学习仓库,包含90多个可运行案例,覆盖上下文压缩、记忆框架、MCP工具调用、提示注入攻防等企业级实战内容。

B站最细FDE教程:从业务实战到面试的案例教学法
B站UP主推出FDE从入门到面试实战教程,讲师亲自深入业务一线,用马氏学习平台真实案例讲解FDE岗位要求。本文分析其案例教学法、笔记策略与私密信息处理方式,为AI岗位求职者提供参考。
518条舞蹈动作链+H3接力:长视频编舞突破时长限制
开源舞蹈动作库更新518条动作链,无需参考视频即可编舞。H3工作流结合AddGuide接力、CF Lift加速和VDN,实现30-60秒长视频生成,突破单段时长限制,提示词分段独立控制。