Gemini 4 Neon实测:能否挑战Opus 5.5?
Gemini 4 Neon与Opus 5.5在真实任务中打平且成本减半,前沿模型比拼已转向审美与意图理解。
文章围绕谷歌49天内连发四个Gemini 4模型(Argon、Carbon、Hydrogen、Neon)展开,指出Neon本质是Carbon的省钱提速版,与Opus 5.5同属一个模型家族分支。在第三方编程Agent指数和作者自建的旗舰评测题中,Neon与Opus 5.5基本打平,但单任务成本约为后者一半。作者进一步发现常规评测题已难以区分前沿模型,于是改用真实视频制作任务进行对比,结果显示Neon与Opus 5.5成片质量不相上下,而其他模型差距明显。由此得出结论:前沿模型的竞争焦点正从写代码能力转向审美决策质量与对人意图的理解把握。订阅方面,Gemini Pro套餐可用Neon且门槛低于Claude Pro,优惠期间按月付费可行,包年需谨慎。
谷歌的模型闪电战
最近谷歌发模型的速度让人目不暇接:9月30号Argon,10月底Carbon,11月12号的Hydrogen,然后11月18号又来了一个Neon——前后49天就陆续发了4个Gemini 4的模型。尤其是上周发布的Neon,在社区的讨论特别多,不止一个帖子说这个模型的使用体验超过了Opus 5.5,要从其他的套餐转到Gemini的订阅。
上次Gemini能有这种热度还是一年前Gemini 3发布的时候,当时大家都以为Google在AI上终于站起来了,以后一直都会很强,但没想到中间这一年沉浸了那么久。说实话,刚看到这些推荐Neon的帖子我还是比较怀疑的——天下苦Opus 5.5久矣,但是自从这个模型发布,虽然之后也有榜单分数更高的模型推出,但作为主力模型使用体验能超过它的至今还没出现。
所以这一期我们主要搞清楚两件事:一是Neon到底能不能干掉Opus 5.5,以及它值不值得你新开一个Gemini的订阅。
Neon的家族传承:Carbon的省钱提速版
根据谷歌的模型卡,Carbon是基于Argon的,Hydrogen和Neon又都是从Carbon适配过来的,所以这四个模型其实是一家人。我把四个模型用之前测旗舰的题目跑了一遍,发现它们的输出风格一样,甚至出错的方式都高度一致——比如说做超级马力的时候,都存在一个最高速度参数不会实际生效的bug,这验证了它们确实同属一个分支。
官方给它们的分工是:Carbon做最难的长任务,Hydrogen主打快,Neon在推理深度和效率之间取一个平衡。不精确对标的话,Carbon对应Ultra和Fiber,Neon对应Opus和Sol。第三方的数据也差不多是这个意思:Artificial Analysis的综合指数里,Neon比Carbon只高了一分,但每个任务花的钱更少,速度也快不少。
所以一开始我对Neon的理解是,它不是一个全新的东西,更像是Carbon的一个省钱提速版。
模型卡(Model Card) 是模型发布方随模型一同公开的技术说明文档,通常包含模型的训练数据来源、能力边界、已知局限、适用场景以及安全评估结果。对于同一家族中基于同一基座微调或适配而来的多个模型,模型卡会明确标注各自的派生关系与定位差异。读者借助模型卡可以判断一个模型是全新架构还是已有模型的变体,这正是文中确认 Neon、Hydrogen、Carbon、Argon 属于同一分支的依据。
Artificial Analysis 综合指数 是第三方模型评测机构 Artificial Analysis 维护的排行榜指标,它把多个标准化基准的得分汇总为一个可比分数,并同时统计每个任务的推理成本与输出速度(tokens/s)。因此该指数不仅反映能力高低,也反映性价比。文中“Neon 比 Carbon 只高一分但更便宜更快”的判断,正是来自该指数中能力、成本、速度三个维度的并列对比。
榜单和常规评测:与Opus 5.5打平
那这样一个省钱提速版,凭什么能让这么多人觉得比Opus 5.5还好用呢?
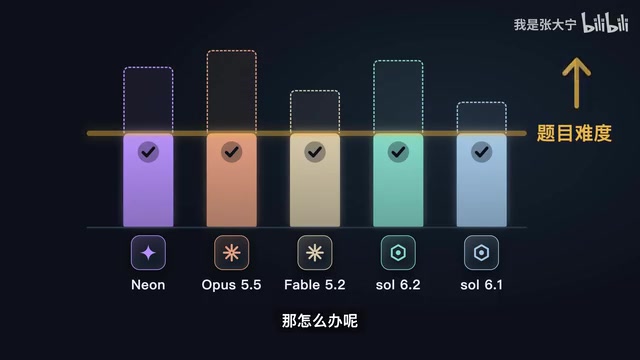
从第三方的Benchmark上来看,在编程Agent的指数当中,Neon在反重逆离跑出的分数和Cloud Code里的Opus 5.5、Fiber 5.2基本在同一档,但每个任务的成本差不多只有Opus的一半。再用我们自己之前测旗舰的题目跑一跑,无论是网页视觉题还是Agent的编码题,Opus 5.5能做对的它也都能做对;Shuback的Agent题Neon三次也都是满分。也就是说,不管是看榜单还是看我们的题,Neon的表现跟Opus 5.5都是打平的。
但这里有一个问题:大家都能做对,除了说明大家一样强,还有一种可能就是题目不够难。
常规评测已经失效了
这其实是我最近一直在思考的一个问题。大概一个月前我就发现,用常规的评测题去测这些前沿模型已经很难看出差别了,即使是一些专业的三方评测机构现在也面临这个问题——测试题更新了一版又一版,然后很快就被刷爆了。你如果不深入测试细节的话,很难说清楚在分数上的那一分两分的差别究竟代表什么。
我尝试去搜集甚至改写更难的编程题增加难度,目标就是让模型拿不到满分,但是结果很不理想。像Opus 5.5这个档次的模型似乎可以做到只要有标准答案就很难出错的程度。到这我感觉这个测试几乎已经穷途末路了。
基准污染与刷榜(benchmark contamination / saturation) 是当前模型评测面临的核心困境。一方面,公开基准的题目可能已进入模型的训练数据,模型相当于“见过答案”;另一方面,厂商会针对热门榜单做定向优化,使分数虚高。结果是榜单分数不断逼近满分,区分度迅速下降。业界常见的应对方式包括:使用私有保留集、定期更换题目、采用人类盲评或竞技场式对比(如 LMSYS Chatbot Arena 的 Elo 排名),以及像文中这样改用无法预先准备标准答案的真实生产任务来评测。
用真实视频制作任务来测
后来我忽然想到,我为什么之前一直觉得Opus 5.5不可替代?要知道针对不同任务我同时在用好几个模型,除了Opus还有Source还有DeepThink,因为单单在做视频这件事上,我试过的其他模型都达不到Opus 5.5的效果——要么是画面太丑问题太多,要么就是各种各样的其他的小毛病。
那既然其他的题目测不出差别,为什么这次不直接用我自己的场景来测呢?
说干就干,我从之前讲蒸馏的那期视频里挑了一段当时用Opus 5.5做的比较满意的片段,大概一分钟,把这段的录音文稿、素材还有工具都放进一个全新的项目,让模型从设计画面一直到做出成片,跟我已经发布的原片放在一起比。结果有点出乎我的意料:Nia和Opus 5.5在同样条件下做出来的东西基本在同一个水平,不相上下。我还让Opus 5.5分别在Cursor和Cloud Code里各做了一遍,结果也差不多,所以跟用什么框架关系不大。
在同样的素材环境和任务要求下,Source 6.1和6.2做出来的东西就差了一截,画面整体很平也比较粗糙,原片还是最好的。不过我回去翻了记录,这一段我当时提过修改意见,前半段是重做过的那换成修改之前的第一版,其实跟今天做出来的成果也差不多。
Agent 式编码工具(文中提到的 Cursor、Claude Code 等)与普通聊天界面不同,它们能读写项目文件、执行命令、运行构建与预览,并在多轮迭代中自行修正错误。因此同一个底层模型在不同工具中的表现可能存在差异,原因往往在于工具提供的上下文管理、工具调用能力和迭代轮数不同。文中让 Opus 5.5 分别在 Cursor 和 Claude Code 中各做一遍并得到接近结果,说明在该任务上框架差异不是决定因素,模型的审美与意图理解才是主要变量。
差距不在写代码,而在审美和意图理解
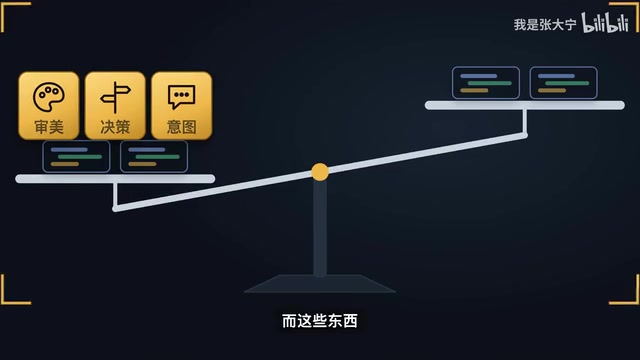
做完这一轮我有一个感觉:现在这些前沿模型的差距其实已经不体现在写代码的能力上,更多的是在审美决策的质量,还有对人的意图的理解和把握上,而这些东西在类似做视频这种真实任务里能看得更清楚。
订阅建议:按月可以,包年谨慎
最后再说说订阅。如果你是在Gemini官方APP或者是反中立理用Pro套餐就能用到Neon,目前的用量尚可,虽然跟Cloud Pro套餐里面Opus 5.5的用量还有差距,但是可用门槛要低得多。
最近Gemini正好在优惠活动中,老用户26号前提前享受黑五优惠,最低半价;27号会开启新用户优惠,但是具体优惠条件不明,大家可以先关注一下。总体来说,我个人的建议是按月付费没有问题,但是包年需要谨慎。
一个开放的问题
这次用自己的真实任务来测,我觉得比刷题有意思得多,也更能看出差别。但是大家日常工作里的任务千差万别,很多专业场景我并不了解,所以如果你工作里有什么任务觉得现在的模型还做不好,或者不同模型用起来差别很明显,请在评论区告诉我,最好说一下你觉得怎样才算做得好,让我们将来的测试可以更加有指导性。
相关推荐
前罪犯揭秘监狱心理变态比例:每880人约200个
前罪犯Larry Lawton在Lex Fridman播客中分享监狱观察:880名终身监禁犯中约200人是心理变态,比例高达23%。他探讨了善恶界限、监狱中的社交与情感,以及黑暗经历带来的智慧。

本地AI入门:Inkling、Qwen与Unsloth实战指南
面向初学者的本地AI实践指南,解析Inkling、Qwen与Unsloth在本地大模型部署与微调中的角色,涵盖模型选型、量化推理、轻量微调流程,以及本地与云端方案的取舍建议。

开放社交网络联盟成立:去中心化社交的新起点
Open Social Web Alliance 开放社交网络联盟亮相,引发 Hacker News 热议。本文梳理联盟的定位、社区讨论中的核心分歧,以及开放社交网络在互操作、内容治理和身份迁移上面临的现实挑战。