Gemini 4 Neon实测:中端模型如何反超旗舰
谷歌中端模型Gemini 4 Neon多项基准反超旗舰,智能体能力强且成本低,但3D生成与文风存短板。
谷歌发布定位中端的Gemini 4 Neon,实测在GraphWox、LiveBench、VendingBench等多项基准上排名第一,部分指标超越Claude Opus和GPT 6.2旗舰,而Pro订阅即可使用且成本显著更低。智能体实测中,双浏览器钢琴同步演奏、视频转场逆向工程、Blender建筑重建表现突出,后者仅用21分钟远快于前沿模型的一小时以上;但3D游戏角色从零生成是明显短板,四轮修订后仅得4.5/10。聊天界面找青蛙失败,深度研究缺引用且行文冗长。Gemini 4全系幻觉率最低,但事实准确率略低。整体以中端价位提供了接近旗舰的智能体体验。
谷歌在模型发布上明显提速。上周刚推出Carbon和Hydrogen两款模型,本周又发布了定位中端的Gemini 4 Neon。据YouTube评测频道的实测,这款"中间档"模型在多项基准上反超了Claude Opus和GPT 6.2系列旗舰,同时保持了更低的成本和更高的效率。
一、定位与规格:中端之名,旗舰之实
Gemini 4 Neon在谷歌的产品线中夹在Carbon和Hydrogen之间,并非谷歌的Frontier(前沿)模型。但据该频道的测试,它在智能体编程、知识工作和科学任务上甚至击败了最好的Opus和GPT 6.2。
使用门槛也相对友好:Neon面向Pro和Ultra订阅用户开放,也就是说最便宜的Pro计划即可使用;而Carbon需要Ultra订阅(月费超过百美元)。此外,Neon也可通过API和Google AI Studio(付费计划)调用。
在评测者的Ultra计划下,完成视频中全部测试仅消耗了约11%的周用量额度,效率相当可观。
二、智能体实测:从双钢琴到细胞动画
评测者主要通过谷歌自家的智能体框架anti-gravity进行测试,理由是前沿模型在需要操作多文件、多文件夹的复杂任务时,配合智能体框架效果最佳。
计算机操作:双浏览器钢琴对决
第一个任务是让Neon打开两个独立浏览器、各载入一个在线钢琴,创作一段约一分钟的肖邦风格快速钢琴二重奏,并实时同步演奏。Neon在"思考"约10分钟后完成了任务,评测者称结果"难以置信",明显优于GPT 6.2 Astra的表现。
视频逆向工程
上传一段包含快速缩放、抖动、拍立得转场、色差故障、交叉缩放等效果的视频,要求Neon逆向分析并复现这些转场。17分钟后,Neon基本完美复现了所有效果,唯一的小瑕疵是结尾转场用了径向缩放模糊,与原版略有差异。
教育动画生成
要求不使用外部动画工具,从零生成一段飞越动物细胞、逐个讲解细胞器的沉浸式教育动画。Neon工作24分钟(明显快于Opus和GPT 6.2),初版偏基础,追加细节要求后有所改善。不过评测者指出,部分形状仍显得像基础几何体,边缘存在重叠,整体与GPT 6.2 Astra持平。
音乐创作与DAW操作
Neon被要求创作一首约三分钟的 upbeat 未来感歌曲,歌词为英文女声、主题是加速迈向奇点,人声在ACE Studio中生成,伴奏在DAW中制作,并使用VST插件和额外采样,要求专业混音母带。15分钟产出初版,按反馈调整人声与伴奏的契合度、加大副歌音量后又工作数分钟。最终成品包含主唱、和声、多种合成器、Rhodes钢琴、打击乐、人声切片等,评测者认为人声偏响、音调偏高,但整体优于GPT 6.2 Astra。
3D游戏开发:最难的一关
这是评测中最难的任务:在Unreal Engine中从零构建3D游戏,角色模型、绑定、动画全部自制,女主角需逼真还原参考图(含头发和衣物动态),对手是忍者,双方能跑跳闪避挥剑,场景为古代中国宫殿内部,Blender生成、Unreal渲染,并接入评分循环——低于8.5分则最多修订四轮。
Neon工作了约40分钟,四轮后评分代理只给了4.5分(满分10)。角色关节错位、握剑姿势错误,动画和绑定都存在明显问题,运行游戏还报了错。评测者承认这个提示词难度极高,但认为GPT 6.2 Astra在这一项上做得更好。
Blender建筑重建:意外之喜
给定一组Airbnb房源照片,要求推断空间布局并用Blender重建整栋建筑与室内,并编程相机路径实现虚拟导览。Neon仅用21分钟完成,而GPT和Opus等前沿模型同类任务耗时超过一小时。初版偏基础,追加细节要求后,沙发、枕头、餐桌、卧室、天花板灯具等细节均还原良好,空间布局(含室外)正确。评测者评价:"对于一个中端模型来说相当不错。"
anti-gravity 是谷歌推出的智能体(agent)框架,其核心设计是让大模型在受控的沙盒环境中自主调用工具、操作文件系统与应用程序,从而完成需要多步骤规划与执行的任务。与普通聊天界面不同,智能体框架允许模型分解目标、循环执行「观察—行动—反馈」流程,并在遇到错误时自我修正。评测者选择 anti-gravity 而非通用聊天界面来测试 Neon,正是因为这类框架能更充分地释放前沿模型在多文件、多文件夹复杂任务上的潜力,也更贴近开发者实际构建自动化工作流的场景。
三、聊天界面的短板与亮点
在普通聊天界面中,Neon的表现有喜有忧。
找青蛙测试:上传一张藏有青蛙的图片,不提示有动物,只问"图中是否有动物,如有请识别并圈出"。Neon未能找到青蛙。评测者还抱怨聊天界面看不到思考日志。
脑肿瘤识别:上传六张含早期脑肿瘤的脑部扫描图,要求识别各图肿瘤类型。Neon答对1.5/6(其中一题算半分),而GPT 6.2 Astra全错,最强模型Fable 5.2也只答对两个。
深度研究:要求描述某类白血病的分子驱动因素、靶向治疗演变,并比较耐药机制与生存结局。Neon给出了详细的药物对比表格和流程图,但未附引用来源,且行文冗长——评测者明确表示不喜欢Gemini模型的写作风格,认为"太啰嗦、不够直击要点"。
创意构思:要求提出三个可规模化、成本可竞争、能处理混合污染塑料废弃物的新方案。Neon给出三个方案(反应性玻璃化、超临界水精炼、串联生物漏斗级联),并附流程图,但术语堆砌严重,评测者直言"完全不知道这是什么意思"。
四、基准数据:多项第一,成本感人
评测引用的基准结果颇具说服力:
- GraphWox长上下文基准:Neon得分约95.2%,Opus为67,GPT 6.2为80,差距显著。
- Artificial Analysis指数:Neon超过Gemini 4 Carbon(尽管Carbon是更大的模型),也超过最好的Opus和GPT 6.2 Sol。
- VendingBench(虚拟自动售货机经营模拟):Neon排名第一,优于Carbon及其他模型。
- Val's Index(金融、编程、法律等知识工作):Neon第二,与Fable 5.2差距极小,几乎并列第一,且成本远低于对手。
- KernelBench(GPU底层代码):Neon第二。
- LiveBench(Abacus AI):Neon第一,且领先幅度很大。
- MazeBench(迷宫导航):Neon第五,超过Carbon,但落后于Claude Fable和GPT 6.2。
速度方面,Neon单任务耗时不如GPT 6.2 Astra快,但快于Opus和Claude Fable;评测者的主观体验是它与GPT 6.2相当。成本上,Neon比Claude系列便宜得多,但Extra High版本比GPT 6.2 Astra更贵——评测者认为GPT 6.2的定位本就是极致性价比而非最高智能。
一个值得注意的差异点是幻觉率:Neon的事实准确率(omniscience accuracy)略低于最好的Claude和GPT模型,但Gemini 4全系的三款模型幻觉率最低——即不知道答案时更倾向如实说不知道,而非编造。Claude和GPT模型在这方面明显更爱"编"。
文中多次出现的「幻觉率」(hallucination rate)与「事实准确率」(omniscience accuracy)是两个相关但不同的指标。幻觉率衡量模型在不知道正确答案时编造信息的倾向,数值越低说明模型越倾向于承认不确定;事实准确率则衡量模型在已知答案的问题上答对的比例。一个模型可以幻觉率很低(不乱编),但事实准确率一般(知道得不够多);反之也可能知识渊博却爱在不确定时硬编。Gemini 4 全系在幻觉率上表现最好,意味着其「知之为知之,不知为不知」的校准更可靠,但在纯粹的知识覆盖上仍略逊于最强的 Claude 和 GPT 模型。
GraphWox 长上下文基准专门测试模型在超长输入(数十万乃至上百万 token)中定位、整合与推理信息的能力,例如从长篇文档或多轮对话里找出分散的关键事实并做跨段落推理。长上下文能力对智能体任务尤为关键,因为智能体在执行多步骤任务时需要持续保留历史操作、文件内容与反馈信息。Neon 在该基准上以约 95.2% 大幅领先 Opus 的 67 和 GPT 6.2 的 80,说明其在长程任务中「记得住、找得到」的优势,这也解释了它在多步骤智能体实测中的稳定表现。
五、结论:又快又省的全能选手
综合来看,Gemini 4 Neon以中端定位交出了接近甚至部分超越旗舰的成绩单。它在智能体编程、浏览器操作、建筑重建等任务上表现出色,基准测试多项领先,成本却显著低于Claude阵营;短板集中在3D角色生成、深度研究的引用规范,以及过于冗长的输出风格。
对开发者而言,最实际的信号是:用最便宜的Pro订阅就能调用这款模型,而它的智能体能力足以支撑相当复杂的多步骤任务。谷歌这一轮的发布节奏,正在把"旗舰级体验"快速下放到中端价位。
相关推荐
Jingle Jam 2026 报名开启:Lewis 用旧素材喊你组队募捐
Jingle Jam 2026 募捐报名已开放。Lewis 用旧素材剪辑成新视频,号召观众在 jingle jam.tiltify.com 建立募捐页面,支持八家慈善机构,活动于 12 月前两周举行。
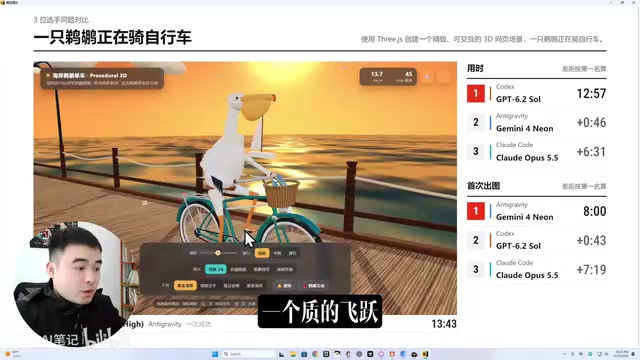
Gemini 4 Neon实测:能否平替Claude Opus 5.5?
B站UP主用三款AI Agent工具同题实测Gemini 4 Neon、Claude Opus 5.5和GPT 6.2,从鹈鹕动画、3D赛车到代码生成视频,看Gemini 4 Neon能否平替Opus 5.5。
FBI警告的Artex:无自研模型的AI攻击框架如何撬开企业大门
FBI警告的开源AI攻击框架Artex没有自研模型,靠接入Claude、GPT等外部大模型驱动代理循环,把Nmap等普通工具变成自动化攻击流水线。本文梳理韩国金融业、ConnectWise、Barracuda三起真实案例,解析速度、成本与噪音三重原因,并给出暴露面清点、短时效凭据等防御要点。