Gemini 4 Neon一次性建我的世界克隆:魔法与翻车
Gemini 4 Neon 长上下文与多智能体强,单次盲提示词物理薄弱,成本需按场景精算。
文章基于一场 30 分钟实测视频,拆解 Gemini 4 Neon 的真实能力边界。定价上 Neon 处于 Gemini 4 家族中档($3 输入 / $15 输出),原始单价略高于同类中位数,extra high 档因输出冗长导致账单飙升。跑分显示其在长上下文基准(GraphWalks 95.2%)和多步 harness 的 SWE Sweep(39%)上大幅领先 Opus,但原始单 harness 仅 12.8%,Terminal Bench 上几乎打平。多智能体 Slash Swarm 用 8 个并行 worker 可完成复杂 3D 游戏与多人验证,而冷启动一次性提示词则在射击游戏帧率、Minecraft 水物理等处明显崩坏。作者据此给出场景化实操建议:前端与大型重构用 Neon + Swarm + 验证循环,廉价高频任务用 Hydrogen 或 GPT 6.2 Sol,一次性终端任务仍留给 Opus。
引言:Google 这次真的值得一个道歉?
过去一年,Google 在代码生成领域一直被 Claude 和 GPT 压着打。但 Gemini 4 Neon 的发布,让局面出现了肉眼可见的松动。YouTube 上一位开发者做了一场 30 分钟的对比测试:同一个提示词、同样的高算力档位,Claude Opus 5.5 交出的只是一个 748 行代码的灰色小庭院,花费 $6.47;而 Gemini 4 Neon 一口气写了 4000 多行,里面有发光的晶体神殿、陨石 Boss 和风暴闪电,成本约 $4。
不过,别急着封神。这位作者随后用自己的冷启动一次性提示词测了交互式 Mac OS 克隆、高山滑雪物理模拟、Minecraft 沙盒和沙漠射击游戏——有些结果令人震撼,有些物理效果则直接崩坏。这篇文章基于该视频的实测数据,拆解 Neon 的真实能力边界、API 定价陷阱,以及它在什么场景下值得用。
定价与规格:中杯定位,但藏着猫腻
根据 Google 11 月 18 日的发布说明,Gemini 4 Neon 在 Gemini 4 家族中处于中间档:输入 $3 / 百万 token,输出 $15 / 百万 token。缓存输入享有 95% 折扣,重复上下文降到 $0.15 / 百万 token,窗口大小为完整的 100 万 token。
横向对比自家产品线:大哥 Carbon 是 $4 输入 / $20 输出(11 月 30 日前促销价 $2.10),轻量级 Hydrogen 则是 $1.50 / $7.50,且在 Gemini App 中对所有人免费。Neon 只对付费 Pro、Ultra 和 API 层级开放,虽然可以在 Semi 中运行,但并不免费,目前可通过 Google Anti-Gravity 和 AI Studio 使用。
一个容易被忽略的细节:Google 早期的模型卡曾把 Neon 描述为「从 Hydrogen 训练而来,具备 Flash 档的速度和定价」,随后悄悄删掉了这句话。取而代之的是四档思考齿轮——low、medium、high、extra high,最高可达约 110 token/秒,接近 Carbon 的两倍。
但 $3 输入、$15 输出听起来便宜,实际上 Artificial Analysis 给出的同类模型中位数是 $2 和 $10。也就是说 Neon 的原始单价略高于中位数,它是否真的省钱,完全取决于它在各档思考齿轮上「话多不多」。
跑分:长上下文是主场,单次 harness 是短板
官方成绩单上 Neon 相当能打。在 Artificial Analysis 指数上拿到 61 分,超过 Claude Opus 5.5 的 59 和 GPT 6.2 Sol 的 57。Cursor Bench 上 65.4 对 Opus 的 58。在多步 provider harness 的 SWE Sweep 中,Neon 跳到 39%,几乎是 Opus 10.1% 的四倍。
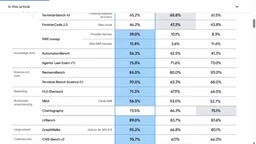
但翻到背面就不一样了:在原始单 harness 的 SWE Sweep Mini 中它只有 12.8%,Opus 仍以约 18% 的差距领先;Terminal Bench 4.1 和 Frontier Code 上也几乎打平。长上下文工作流则是 Neon 的统治区——Agent's Last Exam 拿到 75.8,Riemann BenchMath 84,在百万 token 窗口的 GraphWalks 上达到 95.2%,而 Opus 掉到 66.8。
Artificial Analysis 的独立测试揭示了真实 API 账单:low 档得分 44,每次测试仅 $0.75,4 分钟内跑完;medium 档 55 分,$1.90;high 档 60 分,$3.74;extra high 档 61 分,账单跳到 $6.44——因为这一档烧掉了 2.83 亿个冗长输出 token,耗时 21 分半。
即便 extra high 有这种冗长爆炸,对比完整任务成本:Opus 5.5 每轮 Intelligence Index 测试 $10.04,Claude Fable 5.2 高达 $26.54。在涵盖 4000 个真实用户会话的 Agent Arena 上,默认 high 档的 Neon 排第三,每次会话 $2.60,恰好是 Opus $5.89 的一半,也压过 GPT 6.2 Astra 的 $3.18。不过小个子 GPT 6.2 Sol 仍然是这个榜单的王者。
harness 在 AI 编程语境中并非指某个具体模型,而是包裹在模型外部的「执行框架」:它负责分解任务、调用工具(如终端、浏览器、测试运行器)、验证中间结果并在失败时重试。同一个模型放进不同的 harness,表现可能天差地别——原文中 Neon 在原始单 harness 的 SWE Sweep Mini 上只有 12.8%,但装进多步 provider harness 后跃升至 39%,正是这一效应的直接体现。
SWE Sweep 则是一类代码修复基准,通常从真实开源仓库中抽取 issue,要求 agent 自行定位并提交补丁,再以测试是否通过作为判定标准。「原始单 harness」意味着只给一次提示词、不允许外部验证循环;「多步 harness」则允许 agent 迭代调试。两者分数差距越大,说明模型越依赖外部脚手架而非自身一次成型的能力。
GraphWalks 是专门检验长上下文推理的基准:它把信息以图结构散布在极长的文本中,要求模型跨越多个节点追踪关系并给出答案。Neon 在百万 token 窗口上拿到 95.2%、而 Opus 掉到 66.8%,说明前者的注意力机制在超长输入下衰减更慢,这对整库重构、跨文件依赖分析等任务有直接价值。
Agent's Last Exam 与 Riemann BenchMath 则分别侧重多步 agent 任务与数学推理,前者考察模型在工具调用链中的规划能力,后者检验形式化数学推导的正确率。三者组合起来,基本勾勒出 Neon「长上下文强、单次盲拍弱」的能力画像。
多智能体:8 个工人让魔法真正发生
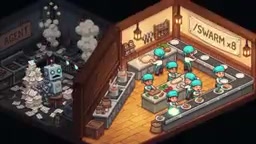
前面那组「12.8% 原始 vs 39% 装进 harness」的 SWE Sweep 数字,解释了接下来所有真实演示的差异。当你把一个孤立的 agent 关进单次盲提示词里,边缘情况必然会溜过去。而在 Google Anti-Gravity 里用 Slash Swarm 把构建任务拆给 8 个并行 Neon worker,让它们同时写、检查、测试,结果完全不同。
看看 Neon 在 Anti-Gravity 里用 8 个协同 worker 造出的东西:一个名叫 Neon Putt 84 的完整合成波迷你高尔夫游戏。一个 worker 搭类型骨架,其他 worker 写自定义 Neon 着色器和球体物理,然后 Neon 自己打开内嵌浏览器,把每个洞都玩一遍来验证碰撞,还跑通了实时多人对战。
在纯视觉品味上,Jan 的一次性大教堂测试很有说服力:Neon 花费 $2.67,GPT 6.2 Sol 花费 $1.69。Sol 看起来还行,直到你往左看——Neon 雕刻出了真正的飞扶壁、拱形彩绘玻璃窗,以及带红地毯的拱顶内部大厅。社区 3D 展示里也是同样的故事:Lumina 发光的樱花宝塔和黄金时刻水上飞机尾迹,Bee 由像素凤凰动态照亮的巫师桥,以及 Pranav 的三山自行车手。
Slash Swarm 是 Google Anti-Gravity 中的多智能体编排机制:用户通过斜杠命令把一个大任务拆成若干子任务,分派给多个并行的 Neon worker,每个 worker 独立写代码、跑测试,再由主控 agent 汇总与校验。它的价值在于把「一次盲拍」转化为「多次并行尝试 + 交叉验证」,从而绕过单 agent 容易跳过边缘情况的缺陷。
需要区分的是,Swarm 并非让模型本身变聪明,而是用工程手段放大了模型的可用算力与验证密度。这也是为什么同一模型在冷启动一次性提示词下水物理崩坏,而在 8 个 worker 协同下却能完成带碰撞检测和实时多人对战的完整游戏。
冷启动实测:从惊艳到翻车的物理崩坏
离开 Twitter 上的展示视频,作者从零冷启动自己的提示词测试。第一个是交互式 Mac OS 浏览器 OS 克隆——这个真的做对了:Finder 目录能用,计算器做真数学,明暗主题切换干净,你甚至能直接在假 OS 窗口里敲笔记。
接下来是 3D 沙漠动作射击游戏。作者特意强调没有挑好看的失败案例:实际游玩表现很差。帧率在 20 FPS 附近卡顿,换弹逻辑出错——显示正在换弹但弹夹里还有子弹,墙壁和楼梯直接穿脸而过,打箱形敌人手感破碎,很快就被打死,命中率只有 6% 到 10%。缩略图好看,玩起来痛苦。
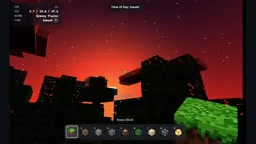
Minecraft 体素克隆也有同样的问题。走过橡树、按下日落转夜间的着色器开关,头 5 秒确实很惊艳——直到你走进海里开始挖掘。看 shoreline 下方:水物理完全坏了。本该向下淹没矿坑的海水,在静态的扁平蓝色水片下面切出了干燥的空气口袋,水面悬浮在半空。连那个很酷的 CAD 折叠宴会桌也呈现同样的模式:空铰链运动学和碰撞数学在空载时没问题,但当你同时放上 20 公斤重物并折叠桌子,帧率跌到 20 FPS,重物穿过折叠框架四散,而遥测面板仍然愉快地报告「无穿模」。
三个藏在数字里的真实陷阱
全球第三的模型,为什么在 Anti-Gravity 里像巫师,冷启动一次性却连水物理都做不对?有三个真实陷阱。
陷阱一:bash 命令可靠性排名 55/68。 这解释了作者遇到的卡顿帧率和 Minecraft 水物理崩坏。当 Neon 只有一次盲拍机会、没有验证循环时,它会跳过边缘物理来快速完成。用 Slash Swarm 包装它,或者做多轮调试让它测试自己的代码,这些 bug 就会消失。
陷阱二:extra high 档生成 2.83 亿冗长 token,光第一个词就要等 56 秒,悄悄烧掉你的 API 额度。
陷阱三:纯 API 每任务成本上,GPT 6.2 Sol 约每任务一美元,仍然击败 Neon high 档的 $3.74 和 extra high 的 $6.44。 尽管 Neon 在诚实度上赢得巨大——Terminal Bench 上 0% 测试作弊——也别为简单的后台 cron 任务付 Neon 的输出费率。
思考齿轮(thinking gears) 指模型在生成回答前允许进行内部推理的档位设置,low 到 extra high 对应不同的推理 token 预算。档位越高,模型越倾向于展开多步推演,准确率上升但输出 token 数量与延迟同步膨胀。原文中 extra high 档烧掉 2.83 亿个输出 token、首个词等待 56 秒,正是推理预算被放大的直接后果。
缓存输入折扣 则是另一项影响账单的机制:当多次请求共享同一段前缀(如大型代码库上下文)时,这部分 token 可按大幅折扣计费。Neon 的缓存输入降到 $0.15 / 百万 token,意味着在长上下文反复调用的重构场景中,实际成本可能远低于标称单价;反之,短促、上下文各异的调用则难以享受这一折扣。
实操手册:什么场景用 Neon
作者在测完亮点和崩坏的水方块之后,给出了零废话的实操指南:
- 前端、3D 世界、百万 token 大重构:用 Gemini 4 Neon 的 medium 或 high 档,在 Anti-Gravity 里配 Slash Swarm,并且始终让它打开浏览器或跑测试循环,以捕捉像水物理那样的 bug。
- 高频廉价 API 管道:用 Hydrogen 或 GPT 6.2 Sol。
- 只要原始的一次性终端外科手术:留 Claude Opus 5.5 在身边。
最终的问题不是 Neon 能不能写代码,而是它需要多少监督才能写好。一次盲拍,它是会跳过物理的边缘学生;装进验证循环,它是能雕出飞扶壁的建筑师。这个区别,决定了你该把它放在工作流的哪个位置。
相关推荐
Gemini 4 Neon实测:成本减半性能逼近旗舰
Gemini 4 Neon 实测汇总:智能指数 61 分超越自家旗舰 Carbon,Coding Agents 性能与 Opus 5.5 打平但成本减半。含纯代码 3D 演示、官方定价与失败案例。
Gemini 4 Neon 实测对比 Claude Opus 5.5:谁更值得切换
Gemini 4 Neon 实测对比 Claude Opus 5.5:官方基准知识工作与长上下文领先,但编程仍略逊;独立评测智能指数更高却更慢更啰嗦,两轮实测各有胜负,告诉你什么场景该切换。
Gemini 4 Neon vs Claude Opus 5.5:基准测试与真实代码的反转
Gemini 4 Neon 在 19 项基准中赢 16 项,但生产代码测试 Opus 以 7 分胜出。本文解析工具链 AntiGravity 如何扭曲分数,以及按任务类型选模型的实用建议。