Gemini 4 Neon 实测对比 Claude Opus 5.5:谁更值得切换
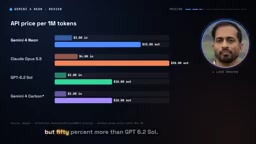
Gemini 4 Neon 官方基准多数领先 Opus 5.5,但实测显示其优势有场景限制。
文章梳理了 Google Gemini 4 Neon 的定位、价格与实测表现。Neon 是家族中杯模型,100 万 token 上下文、四档思考等级,价格比 Opus 5.5 低约 25%。官方基准中它在知识工作、长上下文和科学推理领先,编程类反而略逊。第三方评测给出智能指数 61 分、领先两分,但超高思考档单任务耗时约 21 分钟且输出冗长。X 用户反馈与两轮头对头测试显示 Neon 首轮更干净,Opus 需一次修正。结论是长文档、研究和自动化场景值得切换,终端智能体编程 Opus 仍有微弱优势,Google 已回到前沿牌桌但未全面碾压。
Google 推出 Gemini 4 Neon 后,官方基准表几乎全线压过 Claude Opus 5.5。但基准是一回事,真实体验是另一回事。YouTube 评测者结合 X 上的用户反馈和两轮头对头测试,试图回答一个问题:这次 Google 是不是真的回到了前沿?
Neon 在 Gemini 4 家族中的定位
Gemini 4 Neon 于 11 月 18 日发布,是 Gemini 4 家族的中杯模型。按照 Google 的划分,Hydrogen 主打快和便宜,Carbon 是啃硬骨头的深度思考模型,Neon 则卡在中间——为那些你频繁运行、但又有一定难度的任务而设计。Google 的模型卡写明它从 Carbon 适配而来。
规格上,Neon 提供 100 万 token 上下文窗口、单次响应最多 6.5 万输出 token,以及从低到超高四档思考等级。它已经上线 Gemini API、AI Studio、面向 Pro 和 Ultra 订阅者的 Gemini 应用,以及 Google 的 anti-gravity 编程工具。
价格是这次发布的一个看点:输入每百万 token 3 美元,输出每百万 token 15 美元,比 Opus 5.5 的 4.20 美元便宜约 25%,但比 GPT 6.2 贵出不少。还有个插曲——Carbon 在 11 月 30 日前半价,所以那几天里 Neon 反而是 Gemini 4 家族中最贵的成员。
思考等级(Thinking Levels) 是 Gemini 4 系列引入的推理预算控制机制,允许调用方在低、中、高、超高四档之间切换,模型会在更高档位投入更多内部推理 token 再给出答案。这与 OpenAI 的 reasoning effort 参数思路相近:低档响应快、成本低,适合分类、抽取等轻任务;超高挡适合竞赛数学、复杂代码修复、多步规划。代价是延迟和输出长度显著上升,评测中 Neon 超高挡单任务耗时 21 分钟即为典型表现。实践中常见做法是先用高档跑一遍看质量,再降档验证能否保留大部分得分——文中“高思考档保留约 98% 得分、成本减半”正是这种性价比权衡的直接证据。
官方基准:知识工作和长上下文是主场
先看 Google 自家发布的基准表,需要提醒的是这些数字来自厂商,天然带有选择性。
知识工作类任务上 Neon 领先:VALS 指数 70.9%,略高于 Opus 的 70.1%;自动化基准差距更大,56 对 42。长上下文是拉开差距最明显的地方——在 25.6 万到 100 万 token 的图遍历测试中,Neon 得分 95%,Opus 只有 67%。科学推理方面,Ria Man Bench 拿到 84,HLE Diamond 为 71.3。
编程则没有标题暗示的那么悬殊。在 Terminal Bench 和 Frontier Code 上,Opus 5.5 反而略胜 Neon;而读图表这件事,GPT 6.2 仍然强于两者。
长上下文基准中的“图遍历” 指的是把大量文档组织成节点与边的图结构(例如实体-关系图或多跳问答链),要求模型在数十万 token 的上下文里按路径逐跳检索并整合信息,而非简单地在开头或结尾找一句话。这类任务对位置编码外推、注意力稀疏化和检索精度要求很高,是区分“宣称支持 100 万 token”和“在 100 万 token 上仍然可用”的关键测试。Neon 在该项拿到 95%、Opus 仅 67% 的差距,通常被解读为长上下文训练数据配比与位置插值策略的差异,而非单纯的窗口大小之争。
独立评测:智能指数领先,但代价是慢和啰嗦
第三方机构 Artificial Analysis 把超高思考档的 Neon 放在智能指数 61 分,总分第三,比 Opus 的 59 高两分。在其编程智能体指数上,Neon 得 59,Opus 得 58,而 Neon 每个任务的成本大约只有前者的一半。Valza I 将其排为综合第二,并在金融和法律两个分项指数上列为第一。
代价也很明确。Artificial Analysis 测到超高思考档下每个任务耗时约 21 分钟,输出 token 量是常规水平的多倍。换句话说,它的高分是用时间和冗长换来的。
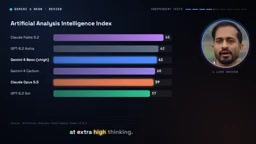
Artificial Analysis 智能指数 是第三方评测机构维护的综合评分,把 MMLU-Pro、GPQA、LiveCodeBench、Math 等多个公开基准的成绩归一化后加权成一个分数,便于跨厂商横向比较。它的局限在于只反映静态题库能力,不衡量延迟、成本、工具调用稳定性或多轮对话表现,因此常被批评“高分低能”。文中同时引用其编程智能体指数(测的是让模型自主编辑仓库、跑测试、修 bug 的端到端成功率)和每任务成本,就是为了补上单一指数看不到的工程可用性维度——这也是为什么 61 比 59 的两分差距必须结合 21 分钟耗时一起读。
X 上的真实反馈
据 X 用户 Pavel Hurin 的测试,在两个真实代码仓库中植入 105 个 bug 后,超高思考档的 Neon 以 63 分领先,略高于 GPT 6.2 Astra。Parallel 表示这是他们测过的网络研究表现最好的模型,且成本比次优者低一个数量级。Valza I 还发现,高思考档能保留约 98% 的得分,而成本只有大约一半——这对日常使用是个实用发现。
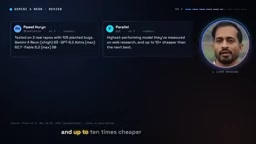
性格方面,Max Weinbach 和 Federico Vaitici 都注意到它极度正面,甚至会夸自己裁剪图片的水平。
两轮头对头测试
第一轮是 Simon Willison 的经典题目:生成一只骑自行车的鹈鹕 SVG。Simon 在发布当天用高思考档运行,得到的是一只比例匀称的鹈鹕,骑在红色自行车上,背景是海边,成本约 15 美分。他的评价是:比 Hydrogen 好,但不如 Carbon。作为对照,Opus 5.5 一次成功,画出了带橙色喉囊、羽翼和脚踩踏板的鹈鹕,骑着一辆辐条清晰的自行车沿海滨道路前行。两边都完成了任务,孰优孰劣可以自行判断。
第二轮来自 Data Camp 的评测:构建一个网页,让计算机自己和自己下完整盘国际象棋,需要自带走法生成器、搜索引擎和标准记谱法。Neon 三次运行全部通过,共 12 局棋全部将死,没有非法走法,每次成本约 1 美元。
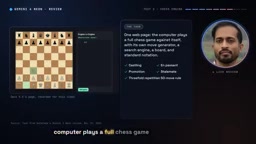
评测者给 Opus 5.5 布置了同样的任务。每一步棋首次尝试即合法,三局全部以将死结束,但存在一个记谱 bug——马的走法被过度指定。修复一次之后,棋局同样全部以将死收尾,记谱与 python-chess 库逐着吻合,并通过了全部标准走法生成测试。结论是 Neon 首轮更干净,Opus 需要一次修正。评测者也提醒,两者配置不同、样本很小,这更像是一次手感测试而非严谨对比。
“骑自行车的鹈鹕 SVG” 是 Simon Willison 在 2024 年提出的非正式测试题,后来演变成社区公认的模型手感基准。它同时考察空间关系理解(鹈鹕要坐在车座上、翅膀握车把、脚踩踏板)、物理合理性(辐条、链条、车架几何)和纯 SVG 代码生成能力(路径闭合、图层顺序、无外部依赖)。由于题目开放、无法靠记忆题库得分,常能暴露模型在组合式生成上的短板。它没有客观评分标准,价值在于快速、低成本地观察一次生成是否“像那么回事”,因此适合作为主观对照而非排名依据。
该不该切换
判断标准其实取决于使用场景。如果你处理超长文档、做深度研究或自动化流程,Neon 是明确选择,而且比 Opus 便宜。如果你长期泡在终端里做智能体编程,Opus 5.5 仍有微弱优势。如果成本是第一优先级,12 月 1 日之后 Neon 会比 Carbon 便宜 25%。
评测者的最终判断是:Gemini 4 Neon 是真材实料,但并非全面碾压——Google 确实回到了前沿竞争的牌桌上。
相关推荐
Qwen 4 Max实测:中国前沿模型挑战Opus 5.5
Qwen 4 Max实测评测:在无辅助工具的裸环境中五小时构建可玩Minecraft风格游戏,多数基准超越Kimi K3,部分项目比肩Opus 5.5。API定价每百万输入token 1.50美元,第三方平台折扣达86%,性价比优势显著。
Gemini 4 Neon实测:半价挑战Opus 5.5,但有个秘密
Gemini 4 Neon实测:智能指数61分超越Opus 5.5,编码任务成本仅一半,速度翻倍。但发布前Google删除架构描述,Opus 5.5在部分测试仍领先。深度分析Neon真实表现与适用场景。
四大AI编程模型实测:同一提示生成动画,谁最忠实?
四款AI编程模型用同一提示词生成20秒纯代码动画,从指令忠实度、代码体积、令牌消耗到成本全面对比,揭晓谁在质量几乎打平时性价比最高。