Gemini 4 Neon真的强过GPT-6.2 Sol?实测数据拆解

谷歌Gemini 4 Neon官方16项第一经独立重测缩水,性能略高但成本速度劣势明显。
文章拆解了谷歌Gemini 4系列发布时Neon拿下19项测试中16项第一的宣传图,指出其对手成绩多为拼凑、且漏掉最强对手Claude Fable。独立机构Valse重排后Neon仅排第二,落后Fable不到半分。查找bug测试中四倍优势源于谷歌定制工具,统一工具后差距缩至约1个百分点。成本散点图显示Neon最高档得分61.4仅比Sol高约4分,单次成本却是六倍、耗时约21分钟。五轮实战中Neon过4关、总花费约1.5美元,但速度与费用常处劣势。结论是订阅用户适合用Neon写复杂代码,API付费用户日常任务优先选更便宜的模型。
官方蓝表下的真实差距
谷歌发布Gemini 4系列时,一张19项测试的对比图让Neon拿下16个第一,科技论坛一夜刷了近800个赞。但仔细看这张表,多数对手成绩并非谷歌亲自跑出,而是从各家厂商和评测网站拼凑;更关键的是,谷歌只放了便宜版的GPT-6.2 Sol和旧版Claude,直接漏掉了最强对手Claude Fable。独立评测机构Valse重排后,Claude Fable以71.31%排第一,Neon以70.87%排第二,差距不到半分。
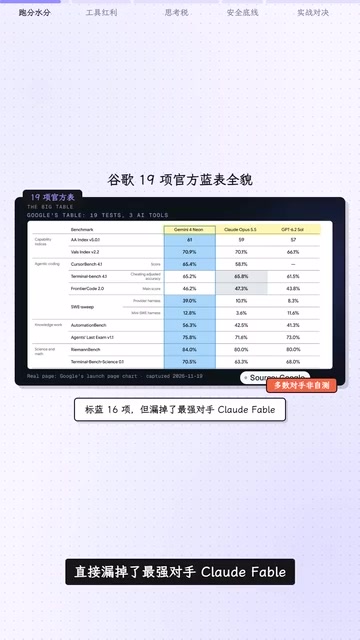
同一张表里,读图测试Chartography一项,Neon只有73.5%,输给了GPT-6.2 Sol的75.1%;两项写代码测试的赢家也变成了Claude。官方图表的光环,在独立数据面前迅速收窄。
四倍优势的真相:工具壳子还是模型能力?
最抓眼球的反转藏在“查找程序错误”测试:谷歌大表上,Neon每100个代码错误能找出39个,GPT-6.2 Sol只能找出8.3个,四倍多的悬殊差距看似碾压。但AI博主Mervin Prezen扒开测试条件后发现,每家模型用的辅助应用根本不同——谷歌给Neon配了自家专为找bug打造的定制工具,相当于拧螺丝时给对手发手动螺丝刀、给自己配电动冲击钻。
放回完全相同的辅助工具Mini SWE里重测,Neon成绩从39%直落到12.8%,GPT-6.2 Sol为11.6%,双方瞬间缩水成只差约一个百分点的贴身肉搏。Mervin的结论很直接:Neon是一个应用程式,不是一个人工智能;表上那种四倍碾压,功劳大半在外面的工具壳子,而不是Neon本身比Sol强出四倍。
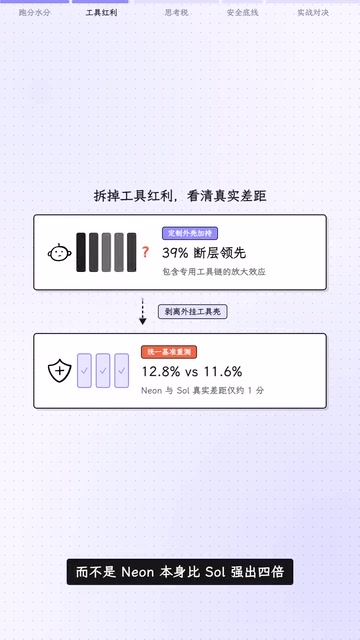
AI代理(Agent)与底层模型的区别:文中反复出现的“应用程式”与“人工智能”之别,指的是AI代理与基础大模型的分层。基础大模型(如GPT-6.2 Sol、Claude Fable)只负责理解与生成;而AI代理是在模型外再套一层工程框架,包含工具调用、多步规划、代码执行沙盒、错误重试等模块。代理在基准测试中的表现,等于“模型能力×框架能力”的乘积,因此同一模型换不同框架,分数可能相差数倍。谷歌为Neon定制的找bug工具,本质上就是一套强化的代理脚手架,这解释了为何统一工具后差距骤缩。
性能与成本的残酷换算
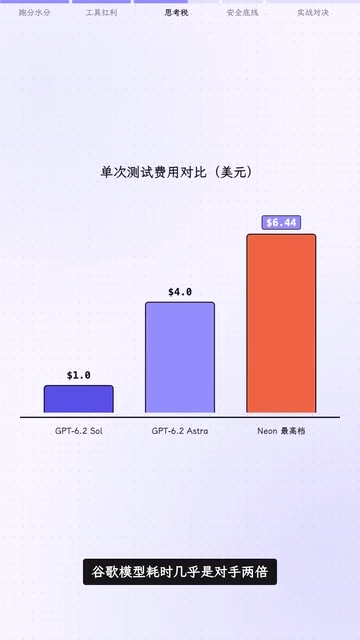
独立机构Artificial Analysis的能力成本散点图给出了更实在的账本。横轴越靠右越贵,纵轴越靠上越强。Neon在图上出现四个点,因为思考时长可调,想得越久分数越高。最左边的灰点代表GPT-6.2 Sol,得分57,每次测试约花1美元;Neon开到最高档思考时得分61.4,比Sol多出约4分,但单次测试成本飙到6.44美元,是Sol的六倍,而且跑完一次测试要干等约21分钟,被标为“很慢”。
这张成本图同样漏掉了排在Neon前面的Claude Fable和GPT-6.2的另一个版本Astra。Astra得分略高于Neon,单次测试只要4美元,比Neon最高档还便宜。另有开发者让两家画同一幅图,谷歌模型耗时几乎是对手两倍,花了4美元,对手只有2.50美元。
谷歌自家价格表旁边还藏着一颗容易让人多花冤枉钱的小星号:到11月30日之前,大号旗舰Carbon的促销单价反而低于中号Neon。下单前不看清星号,很可能花更贵的钱买了中杯。
思考时长(推理预算)与成本-性能权衡:Neon可调“思考时长”,对应的是测试时计算扩展(test-time compute scaling)机制——模型在生成答案前进行更长的内部推理链或多次采样,从而提升复杂任务得分。这类机制通常让准确率随思考时间呈对数增长,即边际收益递减。因此最高档得分61.4相比低档提升有限,成本却成倍上涨。Artificial Analysis的散点图正是把这种权衡可视化:不同档位对应不同坐标点,用户需根据任务价值选择档位,而非默认拉满。
安全测试与实战账单
在五项网络安全测试里,Neon在安全构建上拿到76%,高于Claude Fable的68%;内部找漏洞拿到90%,比Sol高2个百分点;但验证漏洞是否真实时输给了自家大号Carbon,修复漏洞上以71比75输给Claude Fable。这些成绩用的都是关闭安全过滤器的特工版Neon for Cyber,只向获批安全团队开放,普通开发者根本用不到。邮件隐藏指令测试图上,Neon攻击成功率显示0%,Sol约2.4%,但小字注明0%必须配合谷歌额外安全检查层才能实现,不能当成裸模型天生免疫。
Mervin用完全相同的提示词、每个任务只给一次机会做了五轮实测。第一轮做太空小游戏,Neon和Sol都一次跑通,飞船能动、没报错;Sol不到40秒完工,只花5美分,Neon用了102秒、花20美分,耗时2.5倍、费用直接是Sol的4倍。第二轮做动态夜景城市,结果全军覆没:Neon跑满5分钟没完成,白烧70美分;Sol交出来的画面一片漆黑。X社区的复测印证了同一规律:建黑暗教堂,Neon花2.67美元,Sol只花1.69美元;设计电动牙刷,Neon中途停工,Sol完整做完。后三轮对比Fable和旧版Claude,骑自行车模型Neon细节最丰富但耗时2分多钟、最慢,花24美分;写时间表程序41项隐藏测试三家全过,旧版Claude只花9美分,是Neon的三分之一;精确数学题Neon磨了37秒,另外两家只用10秒。
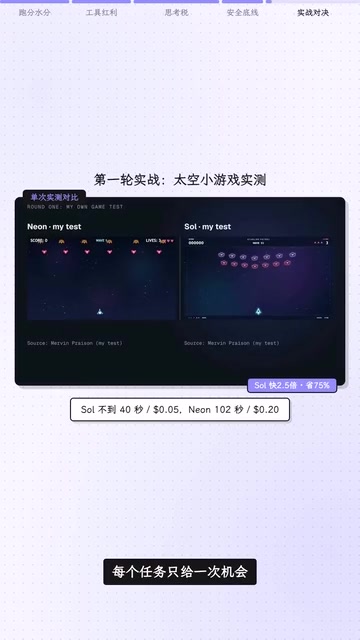
五轮单次实测下来,Neon过4关,总花费约1.5美元——能力确实在线,但从来不是最快,也从来不是最便宜。
安全过滤器与“特工版”模型:文中Neon for Cyber是关闭安全过滤器的特工版,这类版本通常移除或放宽拒绝回答策略(如对漏洞利用、恶意代码的拦截),以服务于渗透测试等合法安全场景,但仅限获批团队。普通开发者使用的标准版带有安全层,遇到敏感请求会拒绝或降级。因此安全测试中的高分不能直接套用到公开API——公开版在攻击性任务上往往被主动限制,这正是“0%攻击成功率需配合额外安全检查层”的含义。
怎么选才不交智商税
回到最初的问题:Gemini 4 Neon真的比GPT-6.2 Sol更强吗?在复杂编程上限和深度思考得分上,Neon确实略高一筹;但只要把速度、费用、单次稳定性和真实工具条件一起放上天平,Sol的性价比和响应速度依然优势明显。
如果你已经订阅Gemini Pro或Ultra套餐,等Neon推送后直接拿来写复杂代码很划算;如果是按API付费,日常小任务和快速原型继续用Sol或更便宜的模型,硬骨头再交给Neon或独立榜第一的Claude Fable,才是真正不交智商税的用法。
基准测试的可复现性与厂商自报数据偏差:评估AI模型时,基准成绩的可比性依赖三个条件:相同提示词、相同工具环境、相同评分脚本。厂商发布会常混用第三方数据、省略最强竞品、或为自家模型配置优势工具,导致榜单失真。独立机构(如Valse、Artificial Analysis)的价值在于统一条件重跑,但即便如此,单次运行方差仍大,需多次采样取均值。文中Mervin的五轮单次实测样本量小,结论应视为方向性参考,而非统计定论。
相关推荐
Gemini 4 Neon 社区实践:9个案例解析场景游戏与3D动效
B站社区整理的Gemini 4 Neon实践合集,通过9个场景生成、游戏原型与3D动效案例,展示模型在实际创作流程中的落地方式与模型PK对比思路。

Gemini 4 Neon对比Carbon实测:性能与费用差多少
谷歌Gemini 4 Neon与Carbon实测对比:Neon默认档59.6分追平旗舰,速度翻倍、原价便宜四分之一,但Carbon在科研计算领先8.5个百分点。11月底前Carbon五折更划算,12月起Neon价格优势生效。

Gemini 4 Neon实测:数据可视化亮眼,但难敌Opus
B站UP主实测Gemini 4 Neon:Agent Arena排名第三,动态数据可视化优于Astra,但3D场景与复杂任务协调能力明显落后Opus和Fable,性价比也面临同门Soul的挤压。