Gemini 4 Neon实测:数据可视化亮眼,但难敌Opus

Neon跑分第三但生成质量不及Opus,动态数据可视化成其差异化强项。
谷歌 Gemini 4 Neon 在 Agent Arena 排名第三,但 UP 主通过 3D 场景与 UI 设计任务横向对比发现,其实际生成质量仅相当于半年前 Opus 的水平。伊斯坦布尔、白宫等场景中,Neon 画面卡通、过饱和,真实感明显落后;拆车赛道、人群模拟等复杂协调任务暴露出物理与细节短板,而同门 Soul 以半价提供更好质量。转折出现在动态数据可视化:Neon 呈现更干净聚焦,优于 Astra 的 UI 堆砌风格,并形成 Gemini 系列的长项。UP 主认为谷歌坚持自研多模型谱系带来多样性,但单模型难全面达到前沿,Neon 属第二梯队、接近前沿。
谷歌近期密集发布模型,Gemini 4 Neon 是其中讨论度较高的一款。B站UP主通过多组3D场景生成与UI设计任务,将它与同门 Astra、Soul、Carbon 以及竞品 Opus、Fable 进行了横向对比。结论颇有代表性:Neon 在动态数据可视化上展现出独特优势,但综合生成质量始终未能触及 Opus 所代表的前沿水准。
跑分靠前,但生成质量差距肉眼可见
在 Agent Arena 榜单上,Neon 排名第三,超过了 Astra 和 Sonic,但仍落后于 Fable 与 Opus。UP主明确指出,外部跑分与主观生成体验之间存在明显偏差——Neon 与 Fable 之间的 Arena 指数差距超过100分,这个排名在他看来是合理的。
第一组对比是伊斯坦布尔场景。Neon 的生成被评价为"有点卡通、太饱和",而 Fable 的水面波光粼粼、颜色克制,显然是精心调校过的结果。切换到白宫提示词后,OPUS 在真实感和整体完成度上深入得多,Neon 的生成则停留在"半年前 Opus 神级模型"的水平。
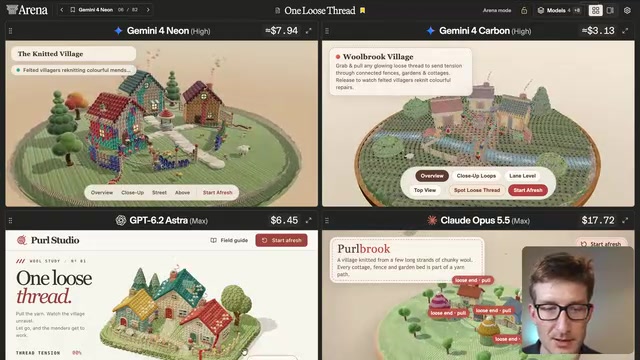
说个细节,同门的 Soul 以接近 Neon 半价的价格,提供了更真实的动作和更丰富的内容。这让 Neon 的性价比显得尴尬:成本偏高,质量却没拉开差距。
Agent Arena 是一个面向 AI Agent 能力的公开评测榜单,通过让不同模型在相同任务上生成结果、再由用户或评审进行成对比较来累计 Elo 式评分,最终形成排名。它的特点是贴近真实使用场景,覆盖 3D 生成、UI 设计、数据可视化等多类任务。但需要留意,Arena 分数反映的是“相对胜率”而非绝对质量:模型只要在大量简单或中等难度任务上稳定胜出,就能积累较高分数,而在少数高难度任务上的明显短板对总分影响有限。这正是文中“跑分与主观体验存在偏差”的结构性原因——排名靠前不等于每一类生成都达到前沿水准。
3D与复杂任务:协调能力仍是短板
UP主设计了一组高协调难度的测试,要求模型在单一生成中整合多个元素。拆车赛道提示词的结果"离谱到家、满地残骸",暴露了 Neon 在处理物理模拟和复杂元素协同时的力不从心。罗马时代伦敦到现代城市的过渡生成"做得还可以",但远谈不上惊艳。
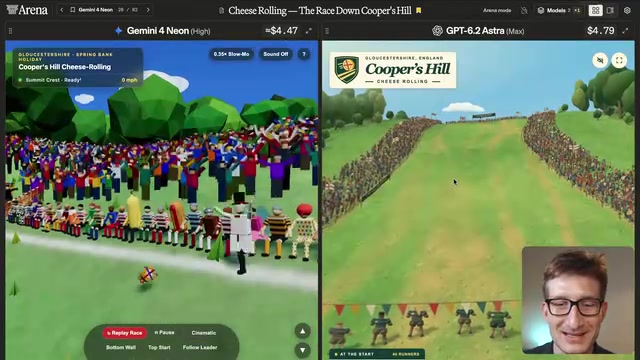
在人群模拟任务中,Astra 生成了大量不同的面孔,而 Neon 的个体"更像是各种不同的几何形状"。UP主对此的分析颇具洞察:这类任务测的并非 3D 本身,而是协调各种元素的难度和在细节上投入的功夫。一旦任务复杂度上升,Neon 的完成度就会明显下滑。
游戏场景生成是另一个观察窗口。Neon 的操作手感"不算差",但画面质量与 Astra 差距明显;Soul 以 Neon 三分之一的价格,提供了更舒服的环境和更顺滑的动效。UP主承认 Neon 在动感表现上有可取之处,但整体质感仍停留在上一梯队。
协调能力(compositional consistency) 指模型在单次生成中同时满足多个相互约束的条件——例如让车辆拆解后的零件符合物理逻辑、让人群中每张面孔既各不相同又与整体风格统一。这类任务之所以难,是因为模型需要在潜在空间中同时维持全局结构与局部细节的一致性,任何一处约束冲突都会表现为画面崩坏或元素同质化。评测中常用“元素多样性”“物理合理性”“细节保真度”三个维度来观察:多样性不足表现为面孔变成几何形状,物理不合理表现为残骸满地,细节不足则表现为复杂度上升后完成度骤降。这解释了为何简单场景看不出差距,而复杂任务会迅速拉开梯队。
动态数据可视化:Neon 的真正强项
转折出现在数据可视化任务中。UP主原本预期 Neon 会延续之前的平庸表现,结果却相反——在数据处理和可视化呈现上,Neon 的表现甚至优于 Astra。原因是 Astra 和 GPT 系列模型倾向于在画面周围堆砌大量 UI 元素,而 Neon 的呈现更干净、更聚焦。
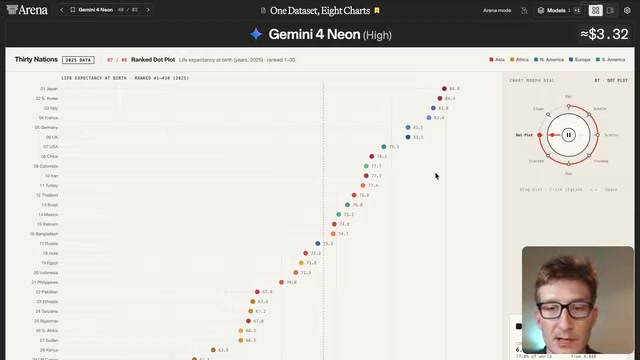
UP主总结出一条规律:Neon 及之后的 Gemini 系列模型在"更动感的数据可视化"上似乎形成了长项。杂志封面、动态图表、白领工作场景的可视化呈现,都是 Neon 相对擅长的领域。这种能力在整个 Gemini 产品线中具有延续性。
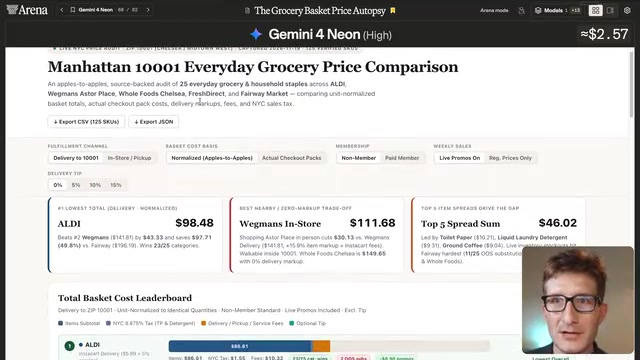
但稳定性问题依然存在。同一个模型在部分 UI 生成任务中表现糟糕——图层混乱、信息层级不清,甚至出现"得划两屏才能看明白"的超市比价网站。UP主判断,这可能与模型过度堆砌元素、token 消耗异常有关。
动态数据可视化在此处指模型不仅生成静态图表,还能产出带有动画过渡、动态图表和场景化信息呈现的画面,例如杂志封面式信息图、白领工作场景中的数据面板。它与普通图像生成的关键差异在于:模型必须理解数据之间的层级与逻辑关系,并克制地只呈现必要元素。Astra 和 GPT 系列倾向于堆砌 UI 装饰元素以显得“丰富”,反而造成信息层级混乱;Neon 的优势则来自更干净的构图与更聚焦的视觉重心。不过这种能力对提示词与 token 预算较敏感,一旦元素过多,模型仍可能陷入图层混乱,说明该强项尚不稳定。
谷歌的模型策略:多样性优先于单点突破
一个容易被忽略的观察是谷歌的模型矩阵策略。UP主指出,谷歌没有直接从 Opus 蒸馏,而是坚持自研,这让它拥有了多个不同谱系的模型——Astra、Soul、Carbon、Neon 各有侧重。这种多样性本身是有价值的,用户可以根据任务类型选择不同模型。
但代价是,单个模型难以在所有维度上达到前沿水平。Neon 在创意动感和文本对话上表现不错(Text Arena 排名靠前),在协调复杂任务时却明显吃力。UP主的最终判断是:Neon 处于第二梯队、非常接近前沿,但"不管我怎么写提示词,都到不了 Opus 的水平"。
对于需要极致生成质量的场景,Opus 的成本高出约10倍(单次约36美元),但 UP主认为这个溢价是合理的。Neon 的价值在于,它用更低的价格覆盖了大部分日常需求,并在数据可视化这个细分场景中提供了差异化优势。真正值得关注的,是后续 Arena 分数能否与这类实际生成体验对上号。
相关推荐
Gemini 4 Neon 社区实践:9个案例解析场景游戏与3D动效
B站社区整理的Gemini 4 Neon实践合集,通过9个场景生成、游戏原型与3D动效案例,展示模型在实际创作流程中的落地方式与模型PK对比思路。

Gemini 4 Neon对比Carbon实测:性能与费用差多少
谷歌Gemini 4 Neon与Carbon实测对比:Neon默认档59.6分追平旗舰,速度翻倍、原价便宜四分之一,但Carbon在科研计算领先8.5个百分点。11月底前Carbon五折更划算,12月起Neon价格优势生效。

实测Gemini 4 Neon:8个场景,真能平替Opus 5.5?
实测Gemini 4 Neon八个真实场景:AEI智慧指数61分排第三,Cursor Bench 4.1达65.4%,定价输入3美元输出15美元。文章转视频九成五可用,但Blender 3D建模翻车。它更像Kimi K3高速版,而非Opus 5.5的平替。