Gemini 4领衔模型升级潮,Agent交付成新战场

模型分工与Agent交付框架、协议、支付能力同步推进,竞争转向任务交付。
本周AI工程领域密集更新:Google推出Genius Carbon与Gemini 4 Hydrogen,明确强推理与日常执行的自动交接分工;Anthropic更新Fable与Misos 5.2,通义千问预告Qwen4-Max。执行层面,Antigravity的Swarm与Dynamic Workflows把多智能体并行工程任务推向可操作阶段,托管与自托管边界逐渐清晰。协议与支付成为最易被低估的进展:POPI 1.0、ARUI 1.0与ChatGPT Wallet让Agent能够操作业务系统、渲染界面并完成交易。安全与评测方面,自动化红队与MKA多步骤任务基准显示行业重心从单轮问答转向交付质量。开源工具覆盖全双工语音、局部语音编辑、浏览器引擎与运行时治理。
Gemini 4领衔模型升级潮,Agent交付成新战场
本周AI工程领域迎来密集更新:Google一次性推出Genius Carbon与Gemini 4 Hydrogen两款模型,Anthropic更新Fable与Misos 5.2,通义千问广告预告Qwen4-Max预览版。当模型能力不再是唯一焦点,如何让Agent真正把任务交付到用户手里,成了新的竞争维度。
模型升级:分工比参数更值得关注
Google这次的动作值得拆开看。Genius Carbon面向付费开发者和企业开放,主打长周期任务、复杂编程和科研推理,Ultra用户陆续收到推送。首发价每百万输入Token 2美元、输出10美元,优惠到11月30日后分别调整为4美元和20美元。
话说回来发布的Gemini 4 Hydrogen定位日常编程和智能体执行,支持100万Token统一上下文,提供四档思考级别,免费用户通过自动选模使用,付费接口每百万输入1.5美元、输出7.5美元。
真正有意思的不是单个模型多强,而是Google明确了两者的分工逻辑:Argon留在常规开发位置,Carbon用在需要反复推理和验证的难题上。在Antigravity中新增的Orchestrator选项里,Carbon先梳理依赖制定计划,Hydrogen接手修改代码和运行测试,遇到阻碍再交回Carbon调整计划。模型在统一任务中自动交接——这才是Agent交付的骨架。
Anthropic同步更新Fable和Misos 5.2,基于同一底层模型,Fable强化网络安全和生物安全防护,Misos需专门申请渠道。官方编程评测中,Fable在超高推理档拿到49.1%,上一代同档为32.4%;另一个高推理档测试中接近Opus最高档成绩,单任务成本约为一半。标准接口每百万输入8美元、输出40美元。
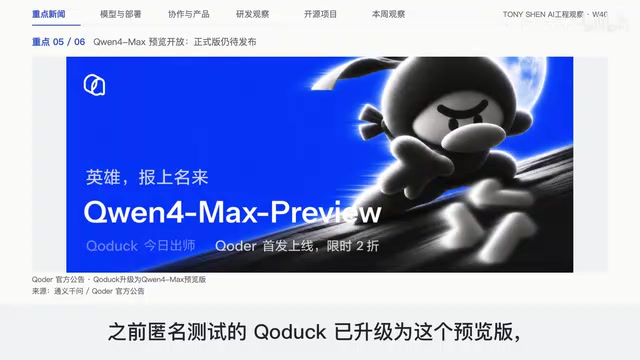
国内方面,通义千问Qwen4-Max预览版已可试用,编程、智能体和专业软件操作被列为重点,个人、团队和企业用户均可选择。
统一上下文(Unified Context) 指的是模型在一次会话或任务中可连续引用的最大 Token 总量,包含用户输入、模型输出、工具调用结果与中间推理。100 万 Token 的统一上下文意味着模型可以在不丢失早期信息的情况下处理大型代码库、长文档或跨多次交互的智能体轨迹。其工程价值在于减少上下文截断与摘要带来的信息损耗,让 Agent 在多步骤任务中保持对全局状态的感知;代价则是显存占用与推理成本随上下文长度上升,因此厂商通常配合缓存、分段注意力等优化手段。
协作与执行:Swarm与工作流并行推进
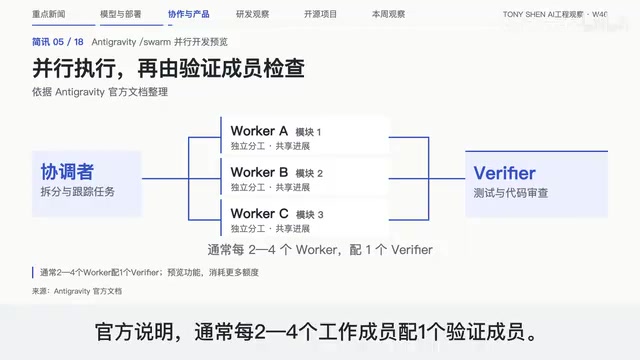
模型之外,执行框架的更新密度更高。Antigravity的Swarm支持多个智能体并行处理工程任务,协调者拆分工作,成员在独立工作副本中推进,验证成员负责测试和审查代码。官方说明通常每2-4个工作成员配一个验证成员。它与Orchestrator的模型交接是两种不同功能:前者是多个成员同时开工,后者是同一任务内的模型接力。
Antigravity还推出Dynamic Workflows,智能体把任务编成Python脚本组织多个成员并行或按阶段执行,脚本先交用户确认,也能保存后重新运行。
QnCode 1.0 Preview把Coder中的执行组织能力融入Python开源内核,提供终端工具和SDK,外部输入、工具结果和反馈都通过事件推进任务。Cloud Code的Projects更新并行协作,协调器能在项目聊天里回答问题并主动汇报各条线程进度,用户可另开支线或从当前线程分叉尝试。
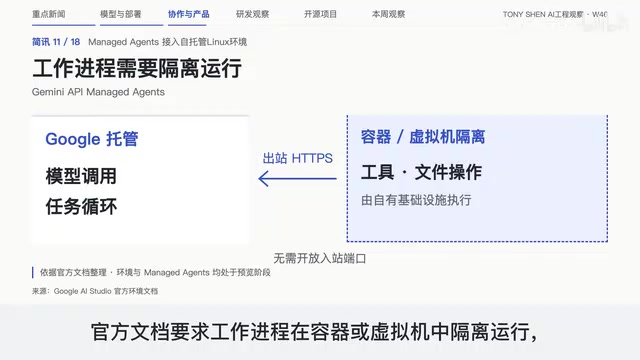
托管与自托管的分界也在变得清晰。Gemini API的Managed Agents能连接自托管Linux环境,模型调用和任务循环由Google管理,工具和文件操作由自己基础设施里的工作进程执行,连接采用出站HTTPS不用开放入站端口,要求工作进程跑在容器或虚拟机中。
Anthropic的自托管Cloud Managed Agents私测版则把运行框架沙箱、凭据和会话历史放进自有云或本地数据中心,模型请求可发往Anthropic、云服务商或企业自己的模型网关。
MCP(Model Context Protocol) 是一套让模型或智能体以标准化方式连接外部工具与数据源的开放协议,可理解为“智能体世界的 USB-C 接口”:服务端暴露工具、资源与提示模板,客户端(宿主应用)负责发现并调用它们。它解决的是此前每家框架各自定义工具 schema、难以复用的碎片化问题。POPI 1.0 等业务协议在 MCP 之上叠加了业务语义与权限控制,使智能体不仅能调用函数,还能按企业规则执行下单、查询等真实操作。理解 MCP 是理解本周协议层进展的前提。
协议与支付:Agent开始插手真实业务
本周最容易被低估的是协议层的进展。Ciru发布个人智能体协议POPI 1.0,规范智能体如何连接企业网站、接口和业务智能体,结合MCP、OpenAPI等已有标准通过OS控制可执行操作,Shopify商家已默认支持,Meta的MUSE也已接入。
Google发布ARUI 1.0生成式界面协议首个稳定版,智能体用JSON描述界面,应用用预先登记的原生组件呈现为表格、表单、图表等,新版支持界面与智能体双向调用函数并写入无障碍要求。
OpenAI推出ChatGPT Wallet,让智能体代为完成付款,每次购买前用户先确认商品与总价,再用人脸或指纹批准,智能体拿到的是支付令牌,目前向美国18岁以上Pro用户逐步开放。
这些动作指向同一个方向:Agent不再只是回答问题,它要能操作业务系统、渲染界面、完成交易。交付的最后一公里正在被协议和支付能力填平。
支付令牌(Payment Token) 是支付网络用一次性或受限凭证替代真实卡号的机制,商户与智能体只能看到令牌而非原始支付信息,从而降低泄露风险。在 Agent 代付场景中,令牌通常还绑定金额上限、有效期与商户范围,并配合用户生物识别确认,形成“用户授权—令牌签发—商户扣款”的链路。它使智能体可以在不持有用户完整支付凭据的前提下完成交易,是 Agent 介入真实商业闭环的关键基础设施。
测试与安全:从人工红队到自动化
OpenAI发布两款Daybreak安全工具:Radar Team用多个智能体协作测试网页应用、验证漏洞和补丁效果;Defense Factory预览版连接GitHub仓库,可单次扫描、定时扫描或监控新提交并提出修复补丁,补丁仍由工程师审核测试。
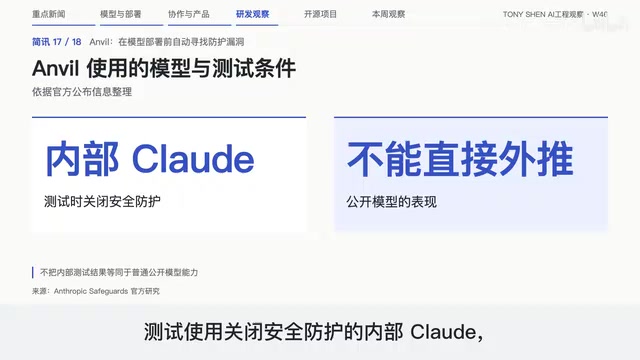
Anthropic的自动化红队系统在模型部署前寻找防护漏洞。官方报告在24组生物安全问题与分类器组合中有23组找到了比人工更严重的越狱方案。需要留意的是,测试使用关闭安全防护的内部Cloud,不能直接等同于公开模型的表现。
Google和Artificial Analysis推出MKA,用200项任务考察智能体读图纸、扫描件等复杂材料再完成表格和演示文稿。首批结果里Fable 5.2和Carbon位居前列,指标是按评分条目加权的完成分数——评测重心正从单轮问答转向多步骤交付。
自动化红队(Automated Red Teaming) 指用模型或智能体系统性地生成对抗性输入,以发现目标模型的安全防护缺口,替代或补充人工渗透测试。其优势在于覆盖率高、可批量重复、能快速迭代攻击策略;局限在于攻击者与防御者同源时可能共享盲区,且测试环境(如关闭防护的内部版本)与公开部署存在差异,结果需谨慎外推。评估红队成效时,应关注攻击成功率、发现的新型越狱类别以及修复闭环速度,而非单一数字。
开源工具:实时语音与运行治理
SoFone Realtime是全双工语音模型,提供3个版本,共用320亿参数的语言部分,采用Apache 2.0许可,关注边听边说、识别语气以及被打断时的语言处理。小红书的Dots TTS Edit 1.1支持用文字描述局部修改已有语音的情绪、语速、停顿和词句,其他部分尽量保持,支持中英文和多说话人编辑。
Cloudflare开源面向智能体的Kitesurf浏览器引擎,采用Apache 2.0许可,在Workers上解析网页、执行脚本和生成截图,兼容Chrome开发者工具协议,可连接Puppeteer,云端部署需要Workers付费计划,仍是实验项目。NVIDIA的OpenShell进入CNCF Sandbox,是面向智能体的开源运行时,在使用工具、调用推理服务和执行任务时落实策略。
本周观察:用同一个任务衡量交付
把本周消息放在一起,可以看到三层分工逐渐成型:强模型处理难题,决策接口选择下一步,执行框架把工具、环境和反馈连起来。Gemini Decisions接口用Decision 1模型处理有限选项里的判断,直接给候选项打分、返回概率和置信度,同一份多模态输入一次最多配1000个问题——这类能力正是中间层的黏合剂。
比较产品时,与其看榜单分数,不如用同一个真实任务记录完成质量、总花费和人工接管次数,再检查权限与执行证据。能写出计划只是起点,能不能把结果交到手里才是分水岭。
相关推荐

手机本地运行无审查AI:LFM3模型实测与指南
介绍如何在iPhone和Android手机上本地运行Liquid AI的LFM3 1.7B无审查模型,无需GPU和网络,包含On Device LLM与Layla应用的操作步骤、实测速度与隐私优势分析。

Claude上线协作表格与白板,Anthropic硬刚微软谷歌
Anthropic向付费用户推送Claude Sheets和Claude Whiteboards测试版,支持一句话生成带公式的表格、将口头计划整理成带时间线的协作白板。文章分析其能力边界、编辑可见设计,以及与微软谷歌的正面竞争。

一句话生成表格?Claude Sheets深度体验与避坑指南
Claude Sheets 测试版上手解析:一句话生成带公式和下拉菜单的协作表格,但 100,000 单元格上限与套餐用量限制可能比你想的更早成为瓶颈。附三个业务场景、合规限制与五步避坑清单。