Gemini 4首日实测:文档最强,写代码先别换

Gemini 4文档分析第一但编程排第四,半价试用至11月底。
Google时隔236天推出Gemini 4,B站UP主将其与GPT-6 Astra、Claude Opus 5.5进行横评。结果显示,Gemini 4在文档分析、读财报类任务中排名第一,幻觉率仅15%远低于Astra的51%,不会的题不编造,适合法务财务场景。但编程能力明显偏弱,在8个模型中仅排第四,代码判断错误过半,简单任务半途停止。价格方面,单价是Opus的一半,但因输出字数多,单题成本达1.99美元,12月1日翻倍后将失去优势。试用期半价持续到11月30日,Pro会员约20美元/月,Ultra 100美元起步。结论是文档岗录用,写代码先不换人,趁半价可做原型演示。
Google上一次发布Pro级旗舰模型,还是今年2月。之后236天,它没再拿出新的旗舰。5月预告的Gemini 3.5 Pro说好6月上线,6月没来,7月、8月也没来。到了9月底,Google干脆宣布3.5 Pro不发了,直接上Gemini 4。9月30号Gemini 4初次露面,但只给一批网络安全机构用;又过了两个星期,10月13号它终于全面开放。
等了这么久,到底行不行?B站UP主把另外两位顶尖选手请来,跟它一起“面试”。这场横评用招聘流程串起三个结论:读文档、做分析,它是现在的第一;写代码,先别换;价格现在半价,12月1号翻倍。
三位“候选人”的自我介绍
三位选手先报家门和期望薪资。GPT-6 Astra来自OpenAI,主打大型工程,薪资是Gemini 4的五倍。Claude Opus 5.5来自Anthropic,综合评分第一,它的自我定位是“我慢,但活细”,薪资是Gemini 4的两倍。
Google这边的试用期半价,半价持续到11月底,12月翻倍。它的简历上还写着19项成绩、13项第一——简历是自己写的,所以UP主决定做个背调。
背调:简历有没有水分
第三步是核对简历。第三方重新测了一遍,大部分分数对得上,对不上的有三处:一处放宽了考试规则,一处没把更强的对手写进去,一处换了套考题。官宣当天彭博社报道,Google内部有人说它刷榜,Google否认了。目前没有证据说简历造假,但它很会“跳考场”。
再看第三方自己测的成绩。替你读财报、看合同、做分析,它第一,比Opus高不到两分。瞎编的比例它15%,Astra 51%。综合智力它和Astra都是53分,Opus 58。可到了工程岗,成绩就掉下来了:在命令行里写代码它排第四,在Claude的两个型号和Astra后面;让它像人一样操作电脑,成功率不到5%,8个模型里倒数第二。一句话,做办公室它是优等生,进机房它还在补课。
什么是“幻觉率”
文中提到的“幻觉率”(Hallucination Rate),指模型在回答中编造看似合理但不真实信息的比例。这是衡量大模型可靠性的核心指标之一:模型生成流畅连贯的文本时,可能把不存在的数据、引文、API 或事实说得煞有介事。评测中通常设置模型“不知道就应承认”的题目,考察它面临不确定问题时的处理方式。
Gemini 4 的 15% 幻觉率意味着它在遇到不会的题时更多选择坦承不知,而非强行编造,这使其在法务、财务等容错率低的场景更有价值;而 Astra 的 51% 则说明它即便不确定也会自信作答,一旦出错后果可能严重。
上线第一天:考官轮流出题
背调做完进入试用期。上线第一天,考官们轮流给它出题。第一位考官让它直接改36年前超级任天堂游戏的底层代码,它做出了一个新关卡。它自己带来的作品更夸张:看一段人扔沙包的视频,教会机器人连中7次——不过这是Google自己的演示。
接下来是同题对比,它又快又便宜。熔岩灯题它不到2分钟、18美分,Opus 9分半、1.27美元。像素城市题同一条题成品差不多,账单1.2美元对8.2美元。长任务题跑到完,它38分钟,Astra 85分钟,Fable 130分钟。
但有两位考官把画面定住了看。瓶中船题它19美分,Opus 12美元,可Opus那只瓶子玻璃有反光、水在动。软糖小熊题,Opus的能捏会回弹,它的是一尊雕像,而且这一次它反而更贵:22美元对7.2美元。便宜不是每次都成立。
“同题对比”与成本核算逻辑
文中反复用同一道题让不同模型作答并对比耗时和花费,这是模型评测中越来越常见的“任务级成本”思路。传统评测只看一次 API 调用的 token 单价,但实际使用中,模型可能输出冗长推理过程、反复自我检查,导致总消耗远超单价预估。因此文中强调“别只看单价,看一件事做完花多少”。
例如熔岩灯题,Gemini 4 用不到 2 分钟、18 美分完成,而 Opus 用时 9 分半、1.27 美元,差距主要来自速度带来的计算量差异;而软糖小熊题它反而更贵,说明不同任务类型下成本优势并不恒定。
三位严格考官:编程仍是短板
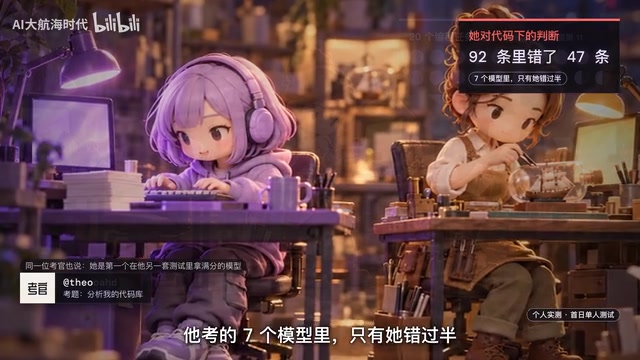
编程博主Theo老师拿自己的代码库考它,它对代码下的判断一半以上是错的,他考的7个模型里只有它错过半。Noah老师派了20个编程任务,三个做的一半人不见了——偏偏是最简单的三个。Glazer老师出了一道集合论难题,它想了十分钟自己停了,换到目标模式的工具里才肯死磕。所以半路停下一部分要怪默认设置。
为什么会这样?加试一场100道题。Astra答对63道、答错19道,“那19道我写的时候可有把握了”。Gemini 4答对50道、只错8道,剩下42道是“不知道”。不会的题它不编——放在法务、财务这种说错一句要赔钱的地方,这是优点;放在要把活干完的地方,就成了做一半走人。其实是一回事。
目标模式与默认模式的区别
文中的“目标模式”指模型在编程工具中被设为追求特定目标(如通过全部测试、完成指定功能)后持续尝试的模式,与默认的“聊几句就停”不同。Gemini 4 在集合论难题上默认停止,但切到目标模式后愿意继续死磕,说明其部分编程短板并非能力不足,而是默认配置过于保守,遇到困难时容易提前收工。
这一现象揭示了一个普遍问题:评测模型时若不区分默认行为与工具强制模式,容易把配置问题误判为能力问题。对开发者而言,在使用时主动设置目标模式或明确要求“做完再停”,可能显著改善任务完成率。
价格:单价便宜,但别只看单价
先说门槛。想聊天得订Google的Pro会员,一个月大约20美元;用Google自家的编程工具写代码,得上Ultra,100美元起步。上线当天被骂得最凶的就是这一点。
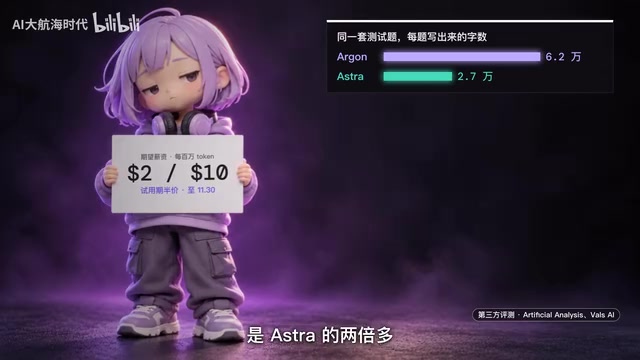
再说单价。现在是Opus的一半、Astra的五分之一。但它话多,同一套测试题它每题写出来的字数是Astra的两倍多。所以一题算下来1.99美元,Astra是3.26美元,2月1号翻倍变成3.98美元后会被反超。
修真实代码更直接:分数比Opus低14分,每个任务花的钱是Opus的两倍多。别看单价,看一件事做完花多少。
最终录用结论
结果出来了。文档岗录用,合同、财报、长报告归它,不知道的地方找人复核。写代码先不换人,Opus、Astra留任。做原型、做演示,趁半价也交给它——试用期到11月30号。
如果你只是聊天、写东西,先别急着为它订会员,它的中文表现目前还没有任何系统评测。这支视频里的数字都来自它上班的第一天,过两周结论可能就变了。
最后说说名字。Google从没解释过为什么叫Argon。Argon中文叫氩,开头那块紫色的灯牌就是它的颜色,氩气通电发的就是这种紫光。1894年化学家给他起名用的是希腊语,意思是“懒”,因为它跟谁都不反应。它上班第一天的表现你们也都看到了,可不反应也有不反应的好处——美国独立宣言的原件就封在氩气里。管文档,它是专业的。
氩气与文档保护的冷知识
文末提到美国独立宣言原件封存在氩气中,这是真实的文物保存技术。氩气(Argon)是一种惰性气体,化学性质极不活泼,几乎不与任何物质反应,因此被用于填充密封容器以隔绝氧气和水分,防止纸张氧化、酸化或霉变。美国国家档案馆的“自由宪章”展柜正是充入氩气,配合恒温恒湿环境来保护独立宣言、宪法和权利法案的原件。
Google 以 Argon(氩)命名模型,既对应其紫色灯牌(氩气放电呈紫光),也暗合“惰性、不反应”的特性——放在文档处理场景中,这种“不乱编、不乱改”的保守反而成为可靠性优势。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。