Gemini Live API 重磅更新:高级推理首次进入原生音频
谷歌为 Gemini Live API 引入高级推理、异步调用与主动式音频,推动语音智能体从被动应答走向实时协作。
谷歌为 Gemini Live API 带来了四项重要更新:主动式音频让智能体只在被点名时才发言,解决了多人场景下的无谓插话问题;上下文注入允许开发者在不打断对话回合的情况下向模型传递背景数据;异步函数调用使耗时工具可在后台运行,对话不被阻塞;最具突破意义的是,前沿级高级推理能力首次进入原生音频体验——复杂推理任务后台执行,前台交互同步保持。谷歌以 SVG 绘图测试直观展示了高推理模型的质量优势。这批功能共同指向同一目标:让语音智能体从被动工具进化为能主动判断、持续响应的实时协作者,为开发者构建更贴近真实场景的语音应用提供了关键基础能力。
谷歌为 Gemini Live API 带来了一批呼声已久的新功能,其中最引人注目的是首次将「前沿级推理」(frontier-level reasoning)引入原生音频交互体验。这次更新覆盖了异步函数调用、主动式音频、上下文注入以及后台推理等多个方向,让语音智能体在保持实时响应的同时,也能处理更复杂的任务。
主动式音频:让智能体只在必要时开口
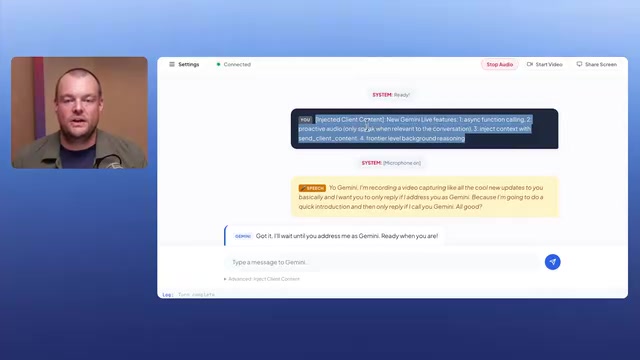
过去的语音助手往往是「一问一答」的机械模式,用户每说一句都会触发回复。新的主动式音频(proactive audio)功能改变了这一点——开发者和用户可以直接提示智能体,只在相关或被点名时才作出回应。
在演示中,主持人一开始就告诉 Gemini:「只有当我叫你 Gemini 的时候才回复」,Gemini 随即安静等待,直到被点名才加入对话。这意味着智能体能够更自然地融入多人对话或长时间的语音场景,而不会因为无谓的插话打断交流节奏。
上下文注入:无需触发回合即可传递信息
另一个实用功能是通过 send client content 向对话中注入客户端内容,而不强制触发一次对话回合(turn)。用官方的话说,这非常适合「back channel(后台传递)一些信息」的场景。
简单来说,开发者可以在不打断当前语音交流的情况下,把额外的上下文或数据悄悄喂给模型,让智能体在后续回答中自然利用这些信息。对于需要动态补充背景数据的应用(如客服、导购、实时数据播报)来说,这大幅提升了交互的灵活性。
异步函数调用:长耗时工具不再阻塞对话
异步函数调用(async function calling)针对的是那些需要较长时间才能返回结果的工具。以往调用外部工具时,对话往往需要「等」结果,而现在这些任务可以在后台运行,智能体则继续与用户交谈。
演示中,主持人请求 Gemini 查询订单号 1234XYZ 的物流状态。Gemini 一边告知「我正在后台查询并实时向你汇报」,一边保持对话流畅,随后返回结果:订单已发货,预计送达。这种「边办事边聊天」的能力,让语音智能体在真实业务流程中更具可用性。
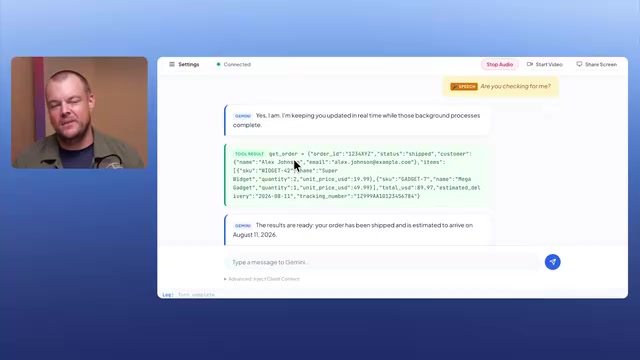
从技术原理上看,传统的同步函数调用采用「请求-等待-响应」的串行模式:模型发出工具调用请求后,整个对话线程会被挂起,直到工具返回结果才能继续。这在调用响应毫秒级的本地函数时几乎无感,但一旦涉及真实网络请求——如物流 API、数据库查询或第三方服务——动辄数秒的等待会让语音交互产生明显的沉默停顿,严重损害用户体验。
异步函数调用通过将工具执行与对话主线程解耦来解决这一问题:工具调用被提交到后台队列独立运行,模型的对话能力持续保持激活状态,能够回应用户的插话、追问或其他请求。当后台任务完成后,结果被异步注入当前上下文,模型再主动向用户汇报。这一机制类似于现代编程语言中的 async/await 或 Promise 模型,只是被移植到了实时语音交互的场景中。
高级推理首次进入原生音频
本次更新最具突破性的部分,是首次在 Gemini Live 中开放高级推理(high reasoning)与后台推理能力,把前沿级的推理水平带到了原生音频体验中。
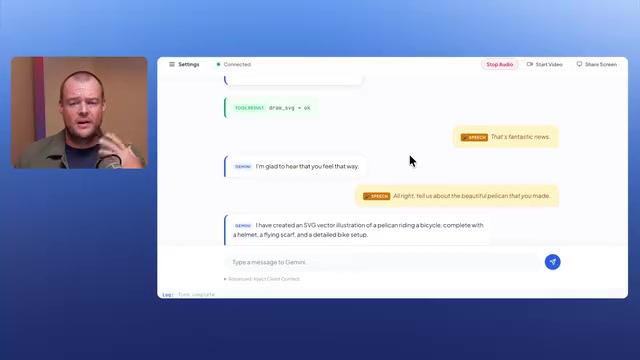
谷歌用一个经典测试来对比效果:让模型画一只「骑自行车的鹈鹕」的 SVG。标准原生音频模型给出的结果并不理想,而切换到 max high reasoning 模型后,Gemini 生成了一只带头盔、飞舞围巾和完整自行车结构的精致鹈鹕图案。
更关键的是任务执行方式:这个较为复杂的绘图任务被放到后台运行,需要一定时间才能完成,但模型在此期间依然保持响应。用户可以继续正常对话(「我们能一边聊天一边等吗?」「当然可以」),等图画好后模型再主动回来汇报。这种把重推理任务后台化、同时保持前台实时交互的机制,正是这次更新的核心价值。
「前沿级推理」(frontier-level reasoning)在此指的是谷歌 Gemini 系列中具备扩展思维链(extended thinking)或深度推理能力的模型版本,其特点是在生成最终回答前,会在内部进行多步骤的中间推断,耗时更长但输出质量显著更高。此前,这类推理能力主要存在于文本或多模态接口中,原生音频(native audio)模式因其对实时低延迟的强依赖,难以承载耗时较长的推理过程。
此次更新引入的「后台推理」机制是关键的工程突破:它将耗时的推理计算从实时音频流中剥离出来,让模型的语音响应层与推理计算层并行运行。用户在模型「思考」期间仍可正常对话,推理完成后结果再被整合输出。SVG 绘图测试直观展示了两种模式的质量差距——这类需要空间推理与结构化输出的任务,正是深度推理模型相较于标准模型优势最为明显的场景。
更新意味着什么
综合来看,这批功能共同指向同一个目标:让语音智能体从「被动应答工具」进化为「能主动判断、能后台处理、能持续响应」的实时协作者。
主动式音频解决了对话时机问题,上下文注入解决了信息传递问题,异步函数调用解决了长任务阻塞问题,而高级推理则直接抬升了模型处理复杂任务的天花板。对开发者而言,这意味着可以在 Gemini Live API 上构建更接近真实交互场景的语音应用——无论是智能客服、语音助手还是多模态创作工具。这些能力现已开放,谷歌也表示期待看到开发者基于此打造的新产品。
相关推荐
Cursor是什么?AI编程工具与传统IDE的核心区别
Cursor是什么?本文详解这款内置AI助手的编程工具,对比它与VS Code等传统IDE在代码补全、生成、重构、错误处理上的核心区别,并分析Cursor集成Claude、DeepSeek等大模型的特性及适用人群。
Coze扣子3.0入门指南:智能体与AI应用全景解析
Coze扣子3.0入门教程:解析字节跳动AI开发平台的智能体、AI应用、工作流与插件体系,涵盖单Agent与多Agent协作,并对比Coze与Dify的差异,帮助零基础用户快速搭建AI智能体。
DeepSeek Harness 环境搭建:Node.js 安装与配置全流程
零基础搭建 DeepSeek Harness 运行环境的完整教程,涵盖 Node.js 安装、Add to PATH 勾选、npm 全局目录与缓存目录迁移,以及系统环境变量配置全流程,附常见踩坑提示。