Gemini Omni视频编辑:对话即剪辑的AI新时代

Gemini Omni通过自然语言对话实现视频编辑,颠覆传统剪辑范式
Google推出的Gemini Omni将视频编辑从专业时间线操作转变为自然语言对话交互。用户只需上传素材并用日常语言描述需求,AI即可自动完成剪辑、调色、混剪等操作,将视频创作门槛降至几乎为零。这标志着多模态大模型在理解与生成闭环上达到实用水平,将对传统剪辑软件在轻量级场景中形成直接竞争。
对话式视频编辑:Gemini Omni开创的新范式
Google最新推出的Gemini Omni在视频创作领域带来了颠覆性的体验。用户只需上传手机相册中的视频素材,通过自然语言对话就能完成视频的创建、混剪和编辑——不需要时间线,不需要学习快捷键,说一句话就能出片。
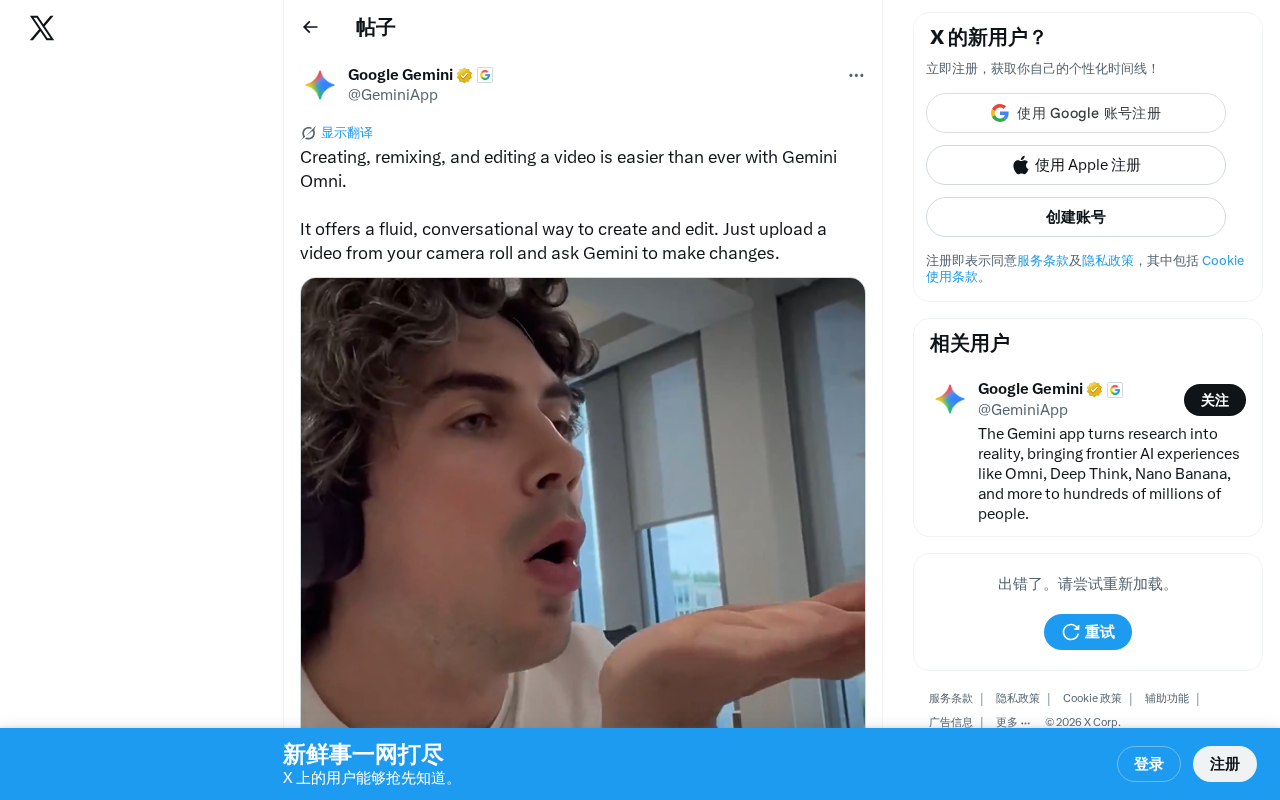
Gemini Omni核心特性:用对话替代复杂操作
Adobe Premiere Pro、Final Cut Pro、DaVinci Resolve等专业视频编辑软件的核心交互范式是"时间线编辑"(Timeline Editing),这一范式自1990年代非线性编辑系统(NLE,Non-Linear Editing)普及以来几乎没有根本性变化。用户需要理解轨道(Track)、剪辑点(Cut Point)、关键帧(Keyframe)、色彩空间(Color Space)等大量专业概念,并熟练掌握数十乃至数百个快捷键。研究显示,一名新手从零开始掌握Premiere Pro的基础操作通常需要数十小时的学习投入。这种高门槛在专业制作领域是合理的精确控制代价,但对于日常短视频创作场景而言,却构成了巨大的使用摩擦。
Gemini Omni彻底换了一种思路——让编辑变成聊天。
你可以像跟朋友说话一样,直接告诉AI你想要什么效果:
- "把这段视频的色调调暖一些"
- "帮我剪掉前5秒的空镜"
- "给最后那个镜头加个慢动作"
- "把这三段素材拼成一个15秒的短视频"
这种交互方式把视频编辑的门槛降到了几乎为零。不懂剪辑的人也能快速产出看起来不错的视频内容。
AI视频编辑工作流程:从上传到成片
三步完成视频剪辑
- 上传素材:从手机相册直接选择一段或多段视频
- 对话描述:用日常语言告诉Gemini你想要的修改效果
- 获取成片:AI理解你的意图后自动完成编辑并输出
整个过程不需要理解视频编码、帧率、码率这些技术概念。Gemini Omni把复杂的底层操作全部封装在模型内部,用户面对的只是一个简洁的对话框。
值得注意的是,这种"封装"背后涉及两个相互独立又必须协同的核心技术问题:自然语言理解(NLU)和视频内容理解(Video Understanding)。前者要求模型准确解析用户指令中的意图、对象和程度(如"调暖一些"中的"一些"是多少?"最后那个镜头"指的是哪一段?);后者则要求模型具备视频时序理解能力,能够识别场景切换、运动状态、画面内容等视觉语义。视频理解在技术上比图像理解复杂得多,因为视频是时间维度上连续的帧序列,模型需要在空间和时间两个维度同时建立语义表征。
视频混剪与创意再编排
除了基础的裁剪和调色,Gemini Omni还支持视频remix(混剪)功能。你可以把多段不同场景的素材丢给它,然后用一句话描述你想要的叙事节奏或风格,AI会自动完成创意性的重新编排。
这里涉及的技术挑战远比表面看起来复杂。在电影剪辑理论中,蒙太奇(Montage)理论揭示了镜头组接顺序对观众情绪和叙事理解的深刻影响。AI要完成有意义的视频混剪,需要理解用户描述的"风格"或"节奏"等抽象概念,并将其映射到具体的剪辑决策——哪段素材放前面、转场时长多少、是否需要音乐节拍对齐等。这要求模型具备一定程度的"创意推理"能力,而不仅仅是执行明确的参数化指令。
这个功能对短视频创作者和社交媒体运营来说尤其实用——批量素材快速出片,效率提升明显。
行业影响:AI视频编辑将改变什么
视频创作门槛大幅降低
Gemini Omni的出现标志着视频编辑正在从"专业技能"变成"人人可用的基础工具"。这条路径我们并不陌生——AI对创作工具的改造通常遵循一条可预测的路径:首先在文本领域突破(以ChatGPT为代表),随后蔓延至图像生成(Midjourney、Stable Diffusion、DALL-E),再向音频和视频延伸。每一次突破都遵循相似的模式——将原本需要专业技能的创作行为转化为自然语言描述,大幅压缩从"想法"到"成品"之间的执行成本。图像生成AI的普及已经深刻影响了设计、插画和广告行业的工作流程;视频AI的成熟将对短视频创作、营销内容生产、个人记录等场景产生类似甚至更大的冲击,因为视频内容在当前互联网流量结构中占据的比重远超图文。
对Premiere Pro和Final Cut Pro的冲击
对于Adobe Premiere Pro、Final Cut Pro这类传统剪辑软件来说,Gemini Omni在日常轻量编辑场景中构成了直接竞争。不过在专业影视后期制作、需要逐帧精细调整的场景中,传统工具的精确控制能力仍然不可替代。
两者更可能形成互补关系:AI处理80%的常规操作,专业工具解决剩下20%的精细需求。
多模态AI能力的成熟信号
从技术角度看,视频编辑对AI模型的要求极高。Gemini系列正是Google在多模态方向的核心布局——多模态大模型(Multimodal Large Language Model)是指能够同时处理文本、图像、音频、视频等多种数据类型的AI系统。与早期只能处理单一模态的模型不同,多模态模型通过统一的神经网络架构将不同类型的信息编码到同一个语义空间中,使模型能够跨模态理解和推理。Gemini的底层架构从设计之初就以原生多模态为目标,而非将独立的视觉模型和语言模型简单拼接。这种架构差异使得Gemini在处理"看视频+理解指令+执行操作"这类跨模态任务时,具备更强的语义一致性。
模型需要同时做到三件事:理解用户的语言指令、理解视频画面内容、在此基础上执行精准的编辑操作。Gemini Omni能做到这一点,说明多模态大模型在"理解+生成"的闭环能力上已经达到了实用水平。
总结
Gemini Omni把视频编辑带入了对话式AI时代。虽然当前展示的功能还偏向基础场景,但"上传素材+自然语言对话"这种交互模式一旦持续迭代,将从根本上改变内容创作的成本结构。对普通用户来说,做出一个像样的短视频,正在变得和发一条朋友圈一样简单。
核心要点
- Gemini Omni支持通过自然语言对话完成视频的创建、混剪和编辑
- 用户只需上传相册视频并用语言描述修改需求,无需专业编辑技能
- 对话式编辑范式大幅降低了视频创作门槛
- 该功能展示了多模态大模型在理解与生成闭环上的成熟度
- 将对传统视频编辑软件在轻量级场景中形成竞争
相关推荐
 科技前沿
In the Weights:查看你在AI领域的影响力权重分数
In the Weights 是一个AI领域个人影响力搜索引擎,通过量化评分衡量你在人工智能世界中的存在感。了解这个工具如何评估AI从业者的多维度影响力,以及它背后关于数字身份的深层思考。
 科技前沿
AI行业罕见平静日:递归自我改进暗流涌动
AI领域迎来罕见的平静一天,多个资讯源集体沉默。但平静背后,递归自我改进(RSI)研究仍在持续推进。解读AI行业发展节奏与从业者应对策略。
 科技前沿
Claude Slack智能体升级:多人协作、主动响应与持久记忆全解析
Anthropic为Claude推出Slack集成重大升级,新增多人协作、主动响应和持久记忆三大核心能力,将AI从被动问答工具转变为真正的团队协作伙伴,重新定义企业级AI智能体应用标准。