#多模态AI
共 30 篇相关文章
 科技前沿
Gemini 3.5 Flash视觉能力超越Pro版,速度快6倍
Roboflow评测显示Google Gemini 3.5 Flash在多项视觉理解任务中超越Gemini 3.1 Pro旗舰模型,推理速度快约6倍。轻量级模型实现性能与速度双赢,为开发者提供高性价比的多模态AI方案。
 科技前沿
Gemini Omni直播演示预告:多模态对话式视频创作详解
Google宣布Gemini Omni实时演示活动,主打多模态输入、真实世界知识和对话式编辑三大核心能力。了解这款AI视频创作工具的功能亮点、观看方式及其对视频生成领域的潜在影响。
 科技前沿
Gemini Omni:理解物理规律的AI视频生成有多强?
深度解析Google Gemini Omni模型的视频物理生成能力,如何从视频输入中理解运动规律并生成无缝衔接的动态画面,涵盖核心技术、应用场景及行业影响。
 科技前沿
Gemini Omni视频编辑功能登陆印度:上传即编辑的AI新体验
Google宣布Gemini Omni视频编辑功能正式向印度用户开放,支持从手机上传视频并通过AI进行智能编辑与风格转换。本文解析该功能详情、印度市场战略意义及多模态AI从理解走向创作的演进趋势。
 科技前沿
Gemini Omni视频风格转换:自然语言一键改变视频视觉风格
深度解析Google Gemini Omni视频风格转换功能,通过自然语言描述即可将视频转化为水彩、赛博朋克、吉卜力等艺术风格。了解其技术原理、操作方式、应用场景及行业竞争格局。
 科技前沿
Gemini Omni视频生成:文本图片视频混合输入一键合成
详解Google Gemini Omni多模态视频生成功能,支持文本、图片、视频混合输入,一键合成10秒连贯视频。了解其技术原理、应用场景及与Sora等竞品的差异化优势。
 科技前沿
Gemini Omni视频编辑:对话即剪辑的AI新时代
Google Gemini Omni支持对话式视频编辑,用户只需上传视频并用自然语言描述需求,即可完成剪辑、混剪和特效添加。本文详解其核心功能、工作流程及对视频创作行业的深远影响。
 科技前沿
Gemini Omni正式发布:一周内社区涌现大量惊艳多模态应用
Google Gemini Omni多模态AI模型正式发布,一周内开发者社区涌现大量创新应用。详解Gemini Omni核心能力升级、社区创作热潮及对AI行业的深远影响。
 行业洞察
Altara Tech用OpenAI模型革新科研工作流:多模态数据处理与透明AI
Altara Tech利用OpenAI大模型为科学家和工程师打造透明、高效的多步骤研发工作流,支持多模态数据处理、推理可追溯,正在改变AI+科研的协作模式。
 产品体验
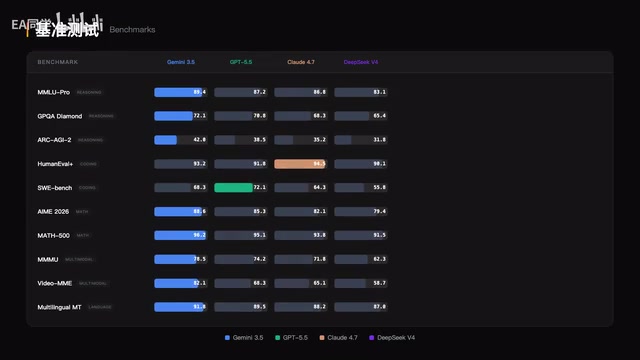
Gemini 3.5 Pro深度评测:多模态断层领先,9.2分旗舰实力全解析
深度评测Google DeepMind旗舰模型Gemini 3.5 Pro,涵盖MMLU Pro 89.4分、Video ModeM 82.1分等基准数据,横向对比GPT 5.5、Claude 4.7,解析DeepThink推理、200万上下文窗口、多模态能力等核心优势与不足。
 深度解读
Qwen3.5深度解析:混合注意力架构实现19倍长上下文加速
深入解析阿里开源Qwen3.5模型的混合注意力架构创新,详解Gated Delta Net如何实现256K上下文19倍加速,多模态视觉反超Gemini 3 Pro和GPT-5.2的评测数据,以及RL后训练策略与实际应用Demo。
 产品体验
Gemini 3 Flash深度评测:编码、多模态、写作全面实测
深度评测Google Gemini 3 Flash在编码、多模态理解、写作翻译等方面的真实表现。涵盖Flash反超Pro的基准跑分解析、搭配Cursor的编程实战、视频音频图像识别全面测试,附实用建议与使用技巧。
 产品体验
三款PDF Agent Skills实测:B站视频笔记与技术手册一键生成
实测Bilibili Render PDF、MiniMax PDF和Any2PDF三款Agent Skills,分别实现B站视频自动生成图文笔记、从零创建专业文档、中英混排品牌级PDF制作,附选择策略与使用建议。
 深度解读
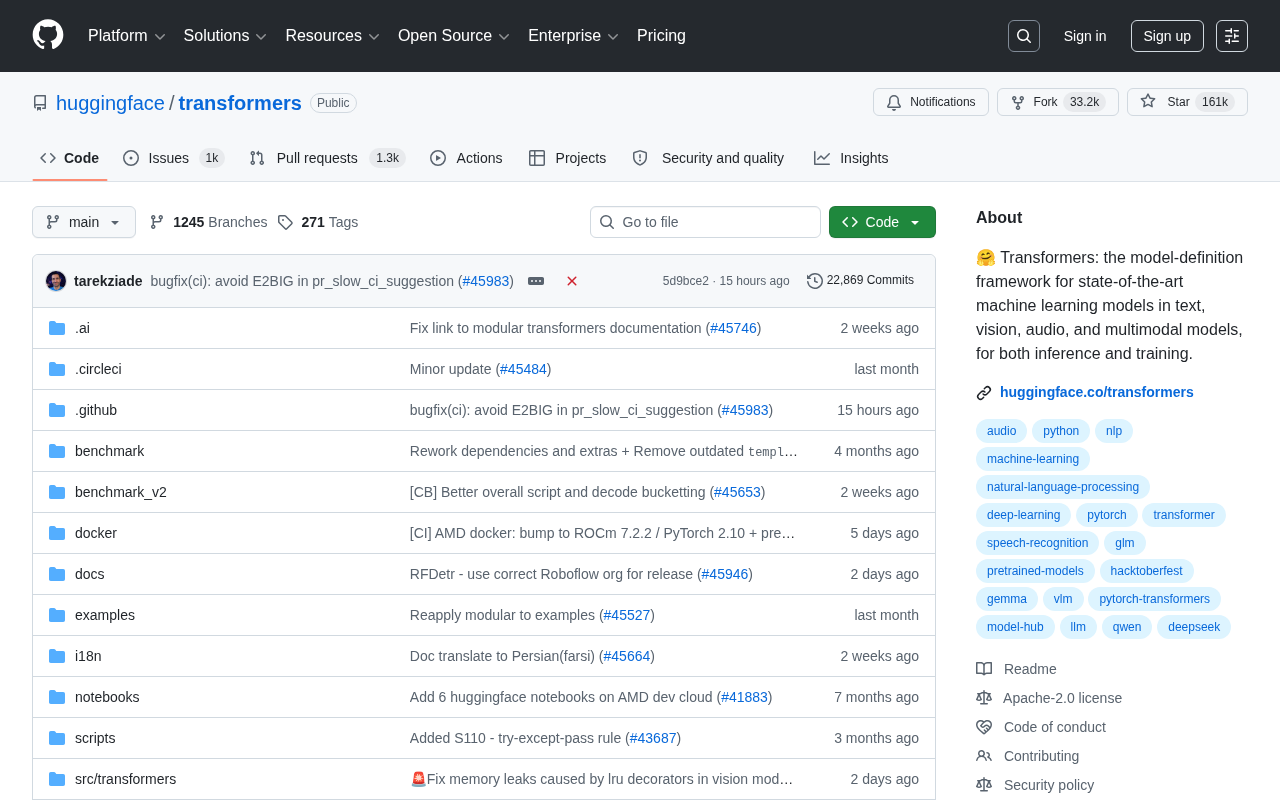
Hugging Face Transformers:16万星开源AI框架全面解析
全面解析GitHub 16万星的Hugging Face Transformers框架,从核心架构、多模态模型支持到大模型量化推理优化,帮助开发者快速掌握预训练模型的加载、微调与高效部署。
 产品体验
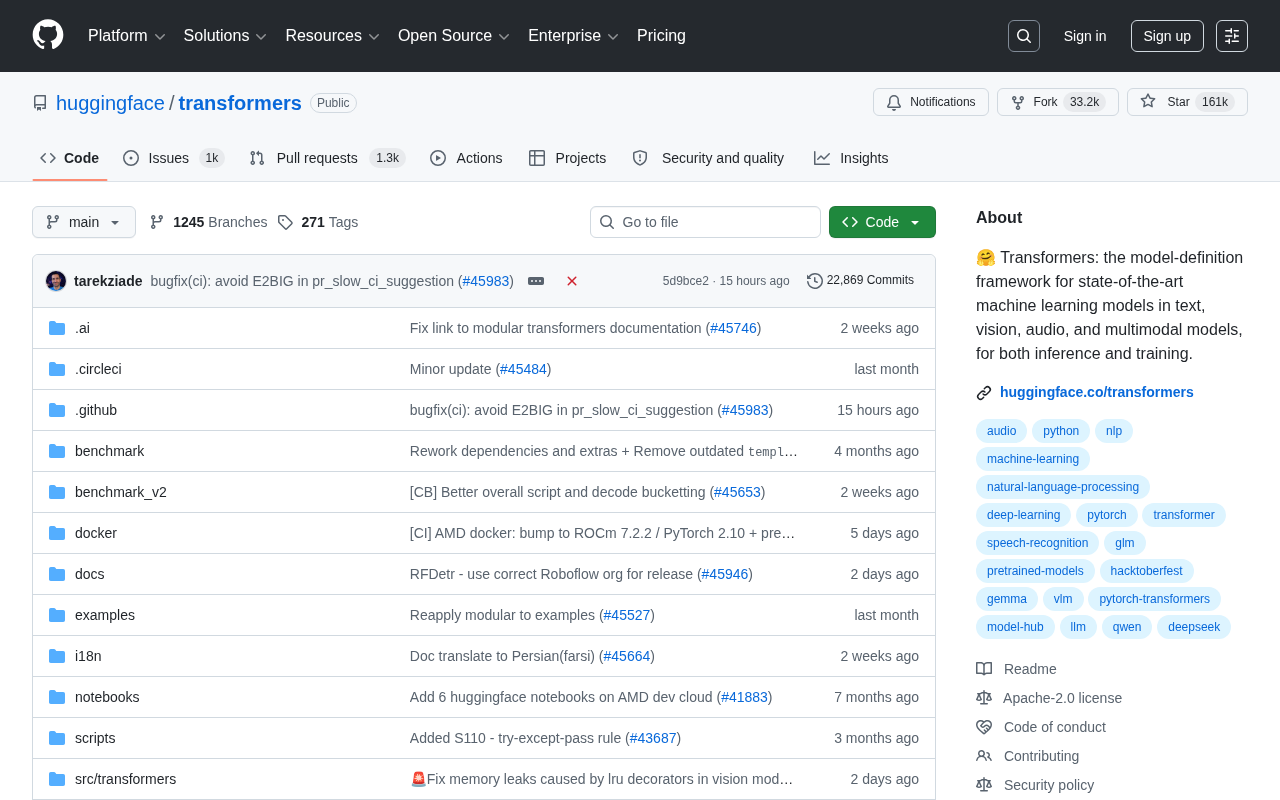
Hugging Face Transformers:16万Star开源AI模型框架深度解析
深度解析Hugging Face Transformers开源框架,涵盖核心架构、多模态模型支持、社区生态及发展趋势。了解这个16万Star项目如何成为AI开发者的必备工具,以及如何快速上手预训练模型的推理与微调。
 教程攻略
Google AI Studio使用教程:Gemini实战指南从入门到精通
详解Google AI Studio与Gemini三种使用方式,涵盖YouTube视频解析、语音生成、Imagen 4文生图、Gemini Live多模态交互及一句话造App等核心功能,助你打造高效AI工作流。
 教程攻略
LangChain多模态实战:用ChatPromptTemplate实现图片识别
详解LangChain框架中ChatPromptTemplate的多模态用法,支持URL、Base64、本地路径三种图片输入方式,附实战代码演示与PySide6桌面应用集成方案,快速上手多模态AI开发。
 科技前沿
Mistral AI首届峰会AI Now Summit:四大议题揭示开源AI企业化路线图
Mistral AI将于5月28日在巴黎举办首届AI Now Summit,聚焦开源AI转型、规模化部署、企业级基础设施及多模态AI四大议题。深度解读这家欧洲AI独角兽的战略布局与行业影响。
 教程攻略
实战测试OpenAI四大新API:GPT-4 Turbo到AI Agent商业化落地
通过AI2Apps平台实战测试OpenAI新发布的GPT-4 Turbo、DALL·E 3、Vision和TTS四大API,验证128K上下文、AI绘图等核心能力,并串联构建小说封面自动生成AI Agent,探索多模态AI商业化路径。
 深度解读
Hugging Face Transformers:16万Star开源AI框架深度解析
深度解析Hugging Face Transformers开源框架,涵盖核心架构、Pipeline API、Auto Classes机制、多模态模型支持及社区生态。了解这个16万Star项目如何成为AI开发事实标准,助你快速上手预训练模型的推理与训练。