Gemini Robotics 2.5发布:机器人灵巧操作再进化
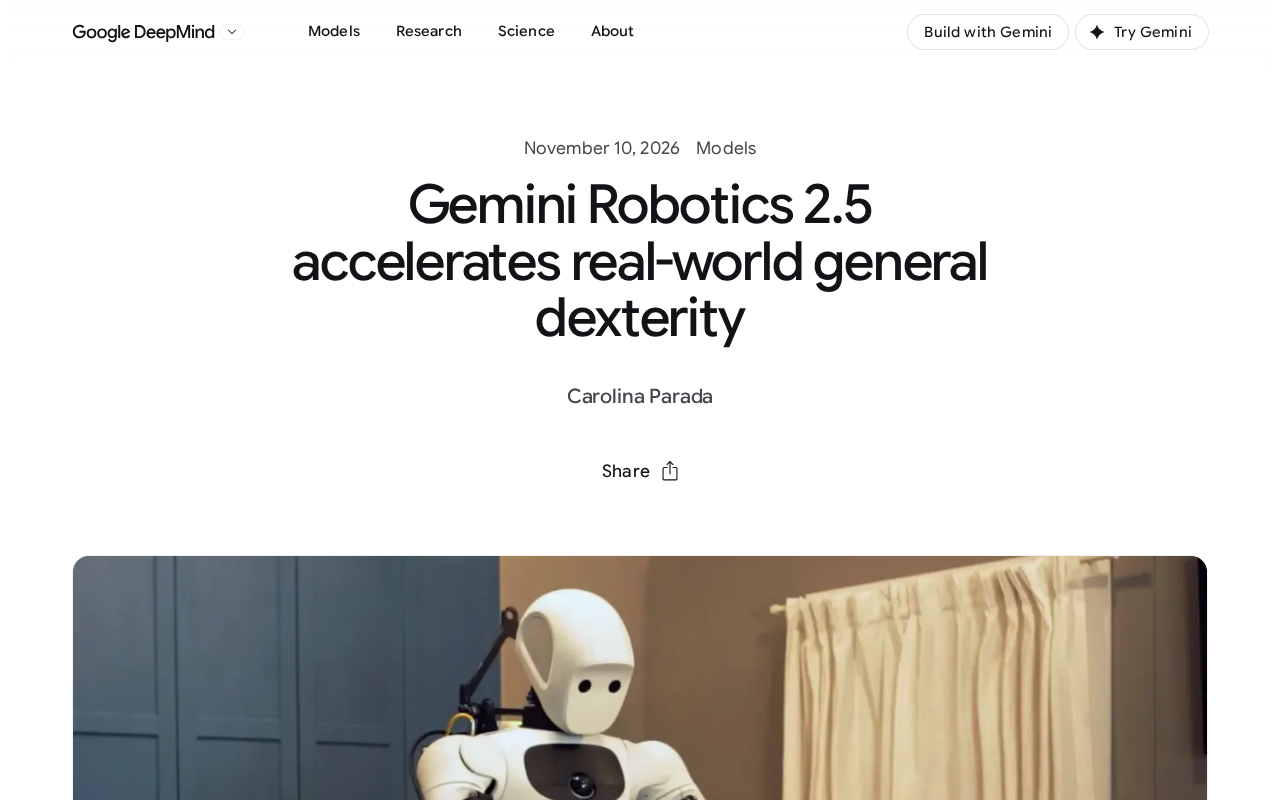
Google DeepMind发布Gemini Robotics 2.5,主打灵巧性、可靠性与安全性。
Google DeepMind 发布 Gemini Robotics 2.5,官方称其为能力最强的视觉-语言-动作(VLA)模型,核心升级集中在灵巧性、可靠性和安全性三个方向。文章指出,VLA 模型将场景理解与动作生成整合进单一模型,减少传统感知、规划、控制多模块流水线的信息损耗。所谓"真实世界通用灵巧",关键在于分布外泛化——在未见过物体与场景上仍能输出合理动作。可靠性与安全性则对应落地部署的两道门槛:稳定重复执行与靠近人体时的约束意识。对开发者而言,更强基座模型降低了应用门槛,但评估标准需从演示效果转向重复成功率、异常恢复与安全边界测试。
Gemini Robotics 2.5发布:机器人灵巧操作再进化
机器人从实验室走向真实世界,卡在手上的往往不是算力,而是"手感"——能不能稳稳抓起形状各异的物体、在杂乱环境里完成精细操作、并且不出安全事故。Google DeepMind 给出的最新答案是 Gemini Robotics 2.5,官方将其定位为"能力最强的视觉-语言-动作模型",核心卖点集中在三个词上:灵巧性、可靠性、安全性。
从"看懂"到"做到":VLA模型的关键一跃
Gemini Robotics 2.5 属于视觉-语言-动作模型(Vision-Language-Action Model,VLA)。与只输出文字的多模态大模型不同,这类模型要同时处理摄像头画面、理解自然语言指令,并直接生成机器人关节的动作序列。换句话说,它把"看懂场景"和"做出动作"压缩进同一个模型里,减少了传统流水线中感知、规划、控制各模块之间的信息损耗。
官方对 2.5 版本的描述是"增强了机器人的灵巧性、可靠性和安全性"。这三个方向恰好对应真实部署中最常见的三类失败:抓取姿态不对、重复执行不稳定、以及人机共处时的安全隐患。把这三项并列作为升级重点,说明这一代模型的目标已从演示视频转向可落地的日常任务。
VLA(Vision-Language-Action)模型是具身智能领域的核心范式之一,其思想可追溯到将大语言模型的推理能力与机器人控制相结合的研究路线。典型架构通常包含视觉编码器(处理摄像头图像)、语言编码器(解析指令)和动作解码器(输出关节角度或末端执行器位姿),三者通过共享的表示空间对齐。与分层式系统不同,VLA 模型端到端地学习"感知→决策→动作"的映射,因此能利用互联网规模的图文数据做预训练,再通过少量机器人示教数据微调。这一范式的代表工作包括 RT-2、OpenVLA 等,Gemini Robotics 系列则是在此基础上引入更强多模态基座的演进版本。
灵巧性:真实世界的通用操作能力
标题中的"real-world general dexterity"值得拆开看。通用(general)意味着不针对单一物体或单一任务做专门训练,而是希望一套模型覆盖多种操作场景;灵巧(dexterity)则指向多指手、精细抓取这类对控制精度要求更高的能力。
这两点叠加,挑战在于分布外泛化:真实环境里的物体形状、材质、摆放方式几乎无穷无尽,模型必须在没见过的组合上仍然给出合理动作。Gemini 系列此前的进展表明,借助大规模多模态预训练,VLA 模型可以迁移部分语义理解能力到动作生成上,2.5 版本则宣称把这种能力进一步推向了"通用灵巧"的水平。
分布外泛化(Out-of-Distribution Generalization)是机器学习中的经典难题,指模型在训练数据未覆盖的输入分布上仍能保持性能。在机器人操作中,这意味着物体形状、材质摩擦系数、光照条件、背景杂乱程度等变量在测试时都可能偏离训练分布。提升泛化的常见手段包括大规模多样化数据采集、域随机化(在仿真中随机扰动纹理与光照)、以及利用预训练语义先验做零样本迁移。对 VLA 模型而言,语言指令提供的语义锚点有助于把"没见过的物体"归入已知类别,从而生成合理动作,但精细抓取的成功率仍高度依赖数据覆盖度。
可靠性与安全性:落地部署的两道门槛
实验室里成功一次和产线上成功一万次,是完全不同的问题。可靠性要求模型在面对光照变化、物体位置偏移、传感器噪声时保持稳定输出;安全性则要求模型在接近人体、易碎物品或高速运动时具备约束意识。
官方把可靠性和安全性列为 2.5 版本的核心提升项,反映出一个行业共识:机器人能力的瓶颈正从"能不能做"转向"能不能一直做对、做安全"。对于计划在仓储、制造或服务场景部署机器人的团队,后者的权重往往更高。
人机共处场景的安全约束在机器人学中通常通过多层机制实现:硬件层的力/力矩限制与急停装置、控制层的速度与工作空间限制、以及学习层的安全策略约束。对于端到端 VLA 模型,由于动作由神经网络直接生成,其行为难以用传统规则完全约束,因此研究者常引入安全过滤器(在动作输出前做碰撞与力限检查)、约束优化或安全强化学习来兜底。此外,重复成功率(多次执行同一任务的成功比例)和异常恢复能力(被抓物体滑落后的重试)是衡量可靠性的常用工程指标,远比单次演示更具参考价值。
对开发者和行业意味着什么
VLA 模型的迭代节奏正在加快,这带来两个直接影响。一是机器人应用的门槛下降——开发者不必从零训练动作策略,可以基于更强的基座模型做场景微调;二是评估标准需要升级,单纯看演示视频已不足以判断可用性,重复成功率、异常恢复能力、安全边界测试会成为更关键的指标。
Gemini Robotics 2.5 目前释放的信息集中在能力定位层面,具体的性能数据和可用范围还有待官方后续披露。对于关注具身智能的团队,这一版本值得持续跟踪,尤其是它在真实环境中的泛化表现与安全机制设计。
相关推荐
Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。
AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。