Gemini音频分类实战:实时情感与主题识别
Gemini 原生音频能力可通过轻量 Streamlit 应用实现实时多维音频判断,但准确率仍有限。
文章介绍了 Gemini 决策模型的原生音频模态能力,并通过一个 Streamlit Demo 展示其实际效果。该应用以 uv 管理环境、Streamlit 构建界面,将浏览器录制的音频流实时送入 Gemini,并行输出情绪、情感倾向、是否低语和话题四类判断。模型既能依据语调等副语言特征识别悲伤与惊讶,也能基于语义内容判断话题,但演示也暴露了明显局限:低语检测会被「whispering」一词的语义线索干扰,话题分类在上下文不足时出现漂移。作者据此指出,该方案当前更适合作为初筛工具,为实时交互、内容粗筛和多维打标等场景提供低成本工程路径,而非高准确率的裁决系统。
当大模型学会「听」:Gemini 的音频原生能力
大多数人对 Gemini 的印象停留在文本对话和图像理解上,但它的决策模型原生支持音频模态。这意味着模型可以直接接收声音信号并输出结构化判断,而不需要先经过语音转文字再处理。视频演示者用一句话点明了这件事的价值:可以「基于语音输入进行实时分类或决策」。
这个能力打开的场景很具体——客服质检、直播内容审核、无障碍交互、情绪感知型应用,都属于「边听边判断」的需求。传统方案往往要把 ASR(语音识别)和下游分类模型拼接起来,链路长、延迟高,而原生音频输入让判断可以和说话同步发生。
音频原生模态(Native Audio Modality) 指的是模型在预训练阶段就将音频信号作为与文本、图像并列的输入形式,而非通过外挂的语音识别模块间接处理声音。原生音频模型通常基于声谱图(spectrogram)或原始波形进行编码,能够保留语调、语速、停顿、音色等副语言信息——这些特征在 ASR 转写为文本后会大量丢失。这也是为什么 Gemini 能仅凭一声叹息判断悲伤,而「ASR + 文本分类」的级联方案几乎无法做到。原生音频输入的另一优势是延迟更低:省去转写环节后,声音到判断的链路更短,更接近实时交互的要求。不过,原生音频模型的训练数据规模和标注难度都高于纯文本,其在嘈杂环境、口音多样性和情绪混合场景下的鲁棒性仍是活跃的研究方向。
一个 Streamlit 应用把能力跑起来
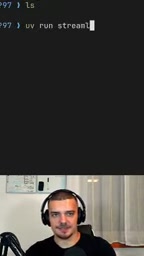
演示者没有停在概念层面,而是直接运行了一个 Web 应用:uv run streamlit run app.py。启动后,用户在浏览器里说话,应用把音频流送入 Gemini 决策模型,实时给出多维度的判断结果。
这个技术栈的选择很轻——uv 负责环境与依赖管理,Streamlit 负责交互界面,Gemini 负责推理。三者的组合让一个实时音频 Demo 的开发成本压到了很低,适合快速验证想法。对想复现的开发者来说,这几乎是最短的路径。
你可能没注意到,这类 Demo 的门槛低不代表能力弱。实时音频流处理通常涉及分块、缓冲、并发请求等问题,而演示中应用对说话内容的响应是连续且即时的,说明整条链路已经跑通。
uv 是由 Astral 团队(Ruff 的开发者)推出的 Python 包与环境管理工具,用 Rust 编写,主打极快的依赖解析和安装速度。它整合了 pip、virtualenv、pip-tools 等工具的功能,支持通过 pyproject.toml 或内联脚本元数据声明依赖,并能自动创建隔离环境。uv run 命令会在执行脚本前确保依赖就绪,省去手动激活虚拟环境的步骤。Streamlit 则是一个面向数据与 AI 应用的 Python 框架,开发者用普通脚本即可构建交互式 Web 界面,无需前端代码;它内置了对音频录制、文件上传等组件的支持,并通过会话状态管理实现准实时刷新。两者结合 Gemini API,使得一个实时音频 Demo 的代码量可以控制在数十行以内,非常适合快速原型验证。
模型在实时判断什么
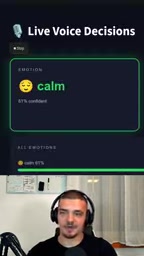
演示中最有意思的部分,是模型并行输出的四类信号:情绪(emotion)、情感倾向(sentiment)、是否在低语(whispering)、以及话题(topic)。这四者其实覆盖了音频理解的两个层面——副语言特征和语义内容。
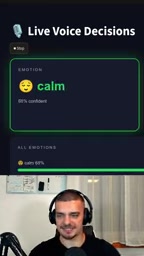
- 副语言特征:情绪和是否低语属于「怎么说的」。演示者提到,模型不仅依靠用词,也依靠语调(tonality)来判断。当他发出特定声音时,能触发对应的情绪识别:一声叹息被识别为悲伤,一声惊叹被识别为惊讶。
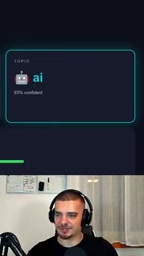
- 语义内容:话题判断属于「说了什么」。谈 AI 时模型给出相关话题,谈披萨时则识别出「食物」。演示中也出现了一次偏差——模型把话题标成了「哲学」,说明话题分类在上下文不足时会有漂移。
这种多任务并行的设计,让单次音频输入同时产出多个维度的标签,对下游应用来说信息密度更高。
副语言特征(Paralinguistic Features) 是语音中不承载字面语义、但传递说话人状态与意图的信息层,包括语调曲线、语速、音量、停顿模式、音质(如气声、颤抖)等。情绪识别和低语检测本质上都依赖这一层:同一句话用不同语调说出,可能表达截然相反的情绪。与之相对的是语义内容,即词语本身传达的意义,话题分类主要依赖这一层。原生音频模型能同时利用两个通道,但也因此面临「通道串扰」问题——当语义线索(如说出「whispering」一词)与声学特征冲突时,模型可能错误地优先采信语义。这一现象在语音情感识别研究中被称为「语义-声学不一致」,是评估音频分类模型时的重要测试维度。
边界在哪里:诚实看待 Demo 的局限
演示者自己反复强调「这不是完美的」。最典型的例子是低语检测:当他在说话中明确提到「whispering」这个词时,模型立刻判定为低语——它被语义线索带偏了。此外,在实际低语过程中,检测也会间歇性地触发和断开。
这暴露了音频分类的一个共性难题:副语言判断容易被语义内容污染。模型听到「whispering」这个词,即使声音并不轻,也可能输出肯定的判断。真正的低语检测需要模型更依赖声学特征而非文本线索。
情绪触发同样如此。演示者用声音触发悲伤和惊讶,效果直观,但这种触发建立在音色和语调的明显变化上。对于语气平淡、情绪混合的真实对话,判断的稳定性会是更大的考验。
对开发者的启示
这个 Demo 的真正价值不在于「模型能识别情绪」这种功能罗列,而在于它验证了一条工程路径:用极薄的封装层,把原生音频模型接进实时交互应用。对于想在产品里加入语音理解能力的团队,这意味着不必自建复杂的音频处理管线。
适用场景可以归为几类:需要即时反馈的交互(如情绪感知的对话助手)、需要批量粗筛的内容场景(如直播话题与情绪打标)、以及需要多维度标签的分析场景。前提是对准确率有合理预期——把它当作「初筛器」而非「裁决者」,会更贴近当前能力的实际水平。
音频作为模型的原生输入模态,正在从「能识别」走向「能实时判断」。这个 Demo 展示的是其中一小步,但方向足够清晰。
相关推荐
伊朗战争意外加速清洁能源转型?能源专家深度解析
哥伦比亚大学教授Jason Bordoff深度解析伊朗战争如何意外加速全球清洁能源转型:霍尔木兹海峡危机、柴油价格冲击、中国战略储备的角色,以及能源安全为何比气候目标更能推动绿色技术 adoption。

意识永生:科学家如何让大脑超越生命
《麻省理工科技评论》圆桌讨论聚焦“心智不朽”:科学家探索大脑保存与意识延续的技术路径,并直面身份认同与伦理困境。

黄仁勋离职风波:恐惧管理文化引质疑
英伟达黄仁勋离职引发对其“恐惧驱动”管理风格的质疑。本文梳理事件背景、管理文化争议及其对科技行业的启示,探讨高压管理在创新型企业中的可持续性问题。