Genie Ontology实战指南:如何逐层构建业务上下文提升AI问答质量

Genie Ontology开箱即用,但AI问答质量的真正决定因素是逐层构建的业务语义上下文。
本文围绕Databricks Genie Ontology的落地方法论展开,核心观点是:企业AI问答工具本身并非瓶颈,输出质量取决于底层业务上下文的完善程度。作者将构建路径拆解为六个递进环节——夯实数据基础、丰富元数据、建模关键业务语义、策划可信资产、治理访问权限、持续评估改进——并强调不应追求一次性覆盖全域,而应从单一高价值业务域切入,在积累经验后逐步扩展。文章最终指向一个更宏观的企业AI竞争判断:模型能力正在快速商品化,真正的护城河在于结构化、可信的业务语义资产建设。
Genie Ontology:开箱即用,但质量取决于业务上下文
在企业AI落地的实践中,一个反复出现的误区是:以为部署了智能问答系统就能立刻得到准确答案。Genie Ontology的设计理念给出了一个更务实的回答——它确实可以「第一天就工作」,但答案的质量,取决于其底层业务上下文(business context)的强度。
换句话说,工具本身不是瓶颈,真正决定输出质量的是你喂给它的语义基础。这一点对任何构建企业级语义层或知识图谱的团队都具有普遍意义。
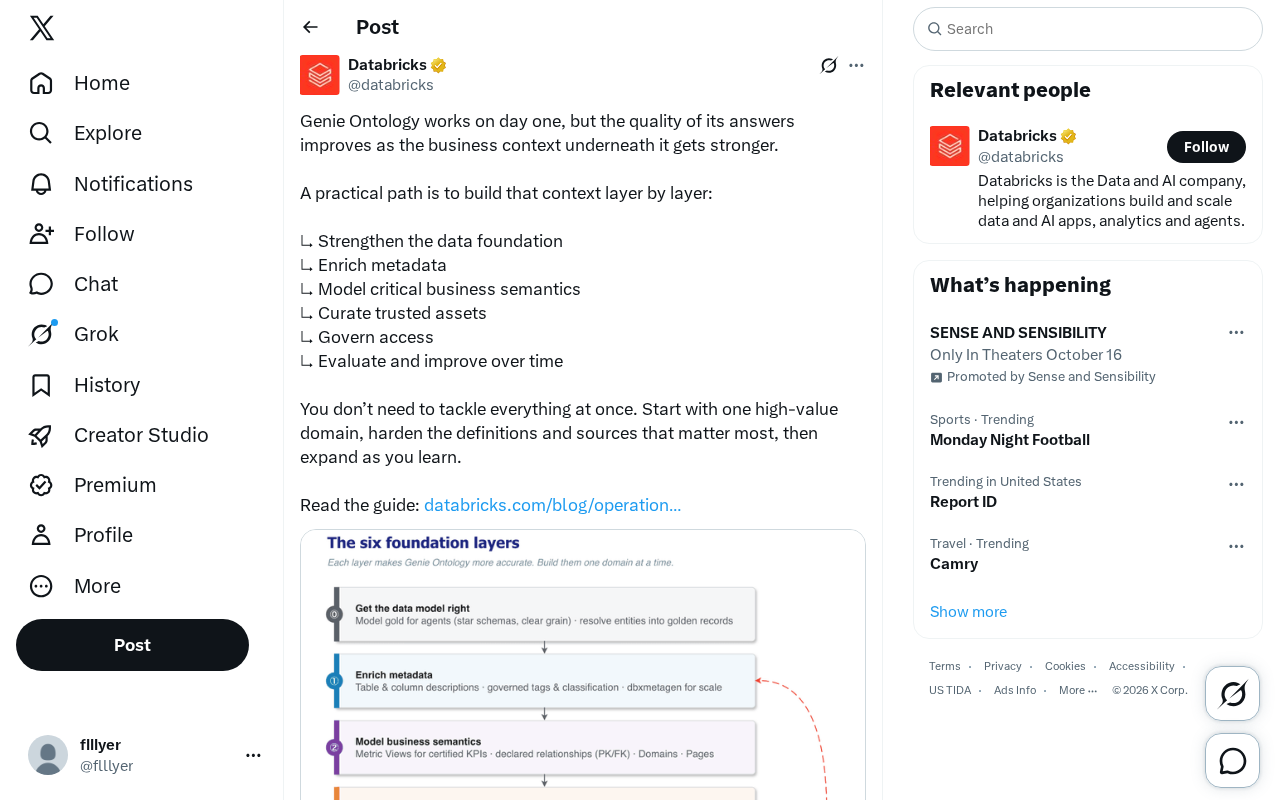
逐层构建:一条可落地的实践路径
根据原始分享,构建这一上下文层不应追求一步到位,而是应当分层推进。整个路径可以拆解为六个递进的环节:
夯实数据基础(Strengthen the data foundation)
一切语义能力都建立在可靠的数据之上。如果底层数据本身混乱、缺失或口径不一,上层再复杂的本体建模也难以产出可信答案。数据基础是整个体系的地基。
丰富元数据(Enrich metadata)
元数据是让机器「理解」数据的关键。表名、字段含义、血缘关系、更新频率等信息越完整,AI在解析用户意图时就越不容易出错。元数据的丰富程度,直接影响系统对上下文的把握。
建模关键业务语义(Model critical business semantics)
这是从「数据」到「知识」的跃迁。企业里的核心概念——比如「活跃用户」「有效订单」「净收入」——往往有着特定的业务定义。把这些语义显式建模到本体中,才能避免AI给出字面正确但业务错误的答案。
本体(Ontology)在这里特指企业知识图谱领域的语义建模工具:它用形式化的方式描述领域内的概念、概念之间的关系,以及约束规则。与普通数据字典不同,本体不仅能定义"活跃用户是过去30天内有登录行为的账户",还能捕捉概念之间的层级与推理关系——例如"付费用户是活跃用户的子集"。正因如此,将业务语义建模进本体,AI系统在回答问题时就不只是做字符串匹配,而是在一套可推理的知识结构上做语义检索,大幅降低"字面正确、业务有误"的概率。
策划可信资产(Curate trusted assets)
并非所有数据资产都同等可靠。通过人工策划,标注出经过验证、可信赖的表和指标,能让系统优先引用高质量来源,减少噪声干扰。
「可信资产」的策划本质上是在数据目录(Data Catalog)层面引入人工背书机制。常见做法包括:由数据治理委员会认证核心指标表、为字段打上"黄金记录"标签、以及维护指标的计算口径文档。当AI系统检索数据时,可优先路由到被标注为可信的资产,并在答案中透明展示数据来源与认证状态,让业务用户能够判断答案的可靠程度。这一步骤与数据网格(Data Mesh)中"数据产品"的理念高度契合——谁生产数据,谁负责保障其质量与可信度。
治理访问权限(Govern access)
在企业环境中,数据安全与合规不可回避。访问治理确保不同角色只能看到其权限范围内的数据,既保护敏感信息,也让答案在合规边界内生成。
持续评估与改进(Evaluate and improve over time)
构建不是终点。通过对答案质量的持续评估,团队可以识别薄弱环节,迭代优化定义与来源,形成正向循环。
不必贪多:从一个高价值领域切入
这套方法论最具实操价值的建议在于——不要试图一次性解决所有问题。
正确的做法是选择一个高价值业务域(high-value domain)作为起点,把其中最关键的定义和数据源打磨扎实,然后在积累经验的过程中逐步扩展到其他领域。
这种「以点带面」的策略有几个明显好处:一是降低初期投入门槛,团队可以快速看到成效;二是在小范围内验证方法论,避免大规模返工;三是让业务方在真实场景中建立信任,为后续推广铺路。
对企业AI落地的启示
Genie Ontology的这套理念,本质上反映了当前企业级AI应用的一个共识:模型和工具正在快速商品化,而真正的竞争壁垒在于结构化、可信的业务上下文。
无论使用哪家厂商的语义层产品,「数据基础—元数据—业务语义—可信资产—访问治理—持续评估」这条链路都值得作为参考框架。它提醒技术团队,与其追逐最新的模型能力,不如踏实地把底层语义资产建设好——这才是让AI问答从「能用」走向「好用」的根本路径。
对于正在评估或部署企业AI问答系统的团队而言,这份逐层构建的思路提供了一个清晰的起点。
语义层(Semantic Layer)是介于原始数据存储与终端分析/AI应用之间的抽象层,负责将物理表结构映射为业务用户可理解的概念模型。它统一了指标定义,使得不同工具查询"月活跃用户数"时得到一致的计算逻辑,而非各自写不同的SQL。Genie Ontology是Databricks在其Lakehouse架构中推出的语义层产品,允许用户用自然语言提问并返回经过语义验证的数据答案。语义层的核心价值在于:一次建模、多处复用,避免指标定义在数十个下游报表中分散漂移,这也是为何文章将其视为企业AI竞争壁垒的关键所在。
相关推荐

刚性微分方程求解器能加速神经网络训练吗?
一位 Reddit 用户追问:刚性微分方程求解器能否像 90 年代论文宣称的那样为神经网络训练带来千倍加速?本文解析梯度流、刚性问题与隐式求解器的原理,并探讨它为何未流行及其在 Neural ODE 中的现代回响。

从零件到机器人:逐步测试电机与机械系统的实战记录
一则来自Reddit的机器人DIY分享,记录了从零件到可运行机器人的构建过程,逐步测试电机、齿轮与机械系统。本文解析分步验证的工程思路及其对硬件项目开发的启示。
美国最东与最西点之谜:地理坐标与航行方向的两种答案
美国的最东点和最西点究竟在哪里?按经度算,阿拉斯加同时是最北、最西、最东;按航行方向算,答案却是关岛和圣克罗伊岛的乌德尔角。本文解析两种地理定义背后的逻辑与巧合。