GFlowNet突破模式坍缩:生成多样化专家对话合成数据

GFlowNet通过按比例多样化采样,解决LLM合成专家对话时的模式坍缩问题,在辅导与情感支持两个领域均优于基线方法。
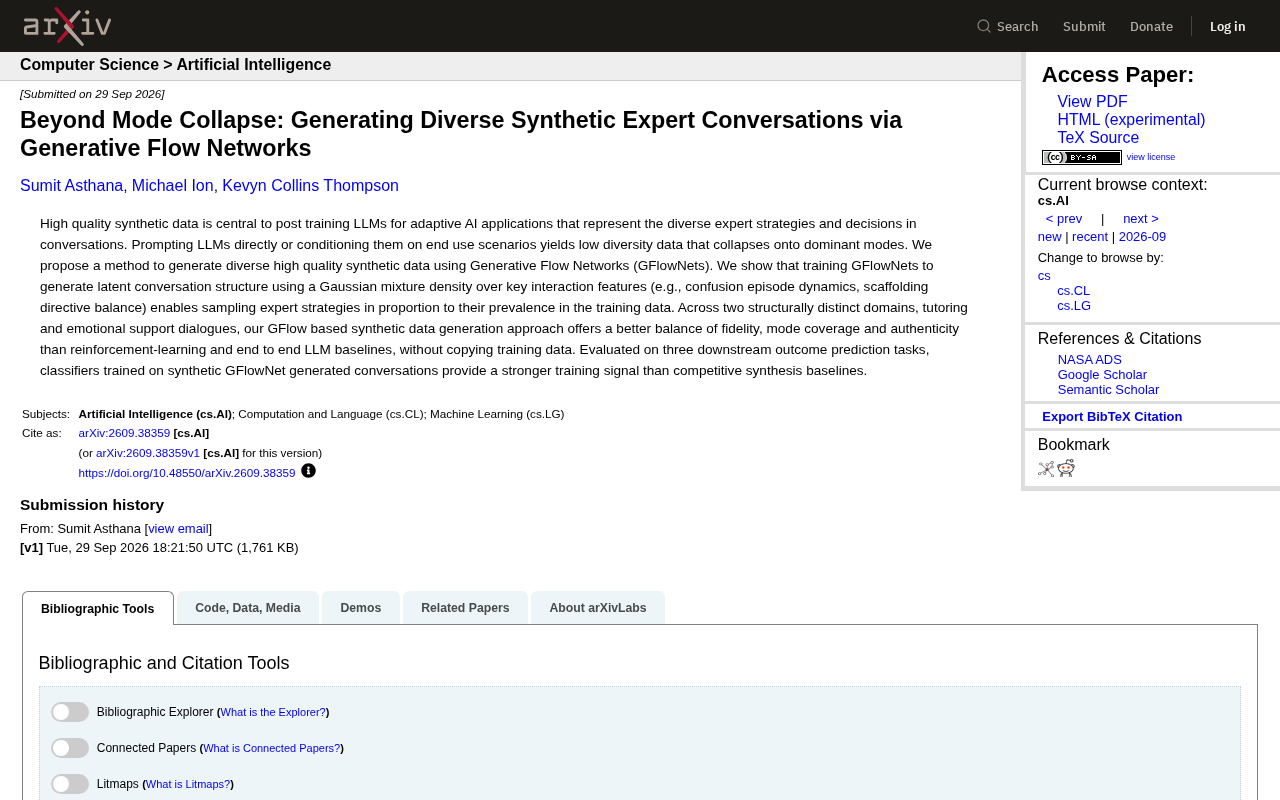
这篇arXiv论文针对LLM合成数据生成中长期存在的模式坍缩问题,提出以生成流网络(GFlowNet)替代直接提示或强化学习基线来产出多样化专家对话。GFlowNet的核心机制是按策略在真实数据中的出现比例进行采样,而非总是偏向最高概率模式。研究的具体方案是训练GFlowNet生成对话的潜在结构——通过高斯混合密度对困惑情节动态和支架式指令平衡等可解释特征建模——再由潜在结构展开完整对话文本。在辅导对话与情感支持两个差异显著的领域,GFlowNet方法在保真度、模式覆盖与真实性三个维度上均优于强化学习和端到端LLM基线,且生成内容不构成对训练数据的直接复制。下游三项结果预测任务的评估进一步证明,GFlowNet合成数据能为分类器提供更强的训练信号,为难以获取大规模真实专家对话的应用场景提供了切实可行的数据构建路径。
合成数据的多样性难题
高质量合成数据已成为大语言模型(LLM)后训练阶段的核心资源,尤其是在那些需要还原真实对话中多样化专家策略与决策的自适应AI应用中。然而,当前主流的数据生成方式存在明显短板:无论是直接提示(prompting)LLM,还是基于具体使用场景对模型进行条件约束,产出的数据往往缺乏多样性,容易坍缩到少数几个「主导模式」上。
这种**模式坍缩(Mode Collapse)**问题意味着,模型生成的对话虽然流畅,却高度同质化——它反复输出最常见的专家策略,而忽略了真实世界中那些虽不占主导但同样重要的策略变体。对于需要捕捉专家行为分布的训练任务来说,这是致命的缺陷。
这篇arXiv新论文(arXiv:2609.38359v1)提出了一种新思路:借助**生成流网络(Generative Flow Networks, GFlowNets)**来生成既多样又高质量的合成专家对话数据。
模式坍缩(Mode Collapse) 在生成模型领域是一个已被广泛观察到的现象,最初在生成对抗网络(GAN)训练中被重点讨论:判别器的梯度信号会引导生成器反复生成少数几类「安全」样本,从而忽略数据真实分布中的长尾模式。对于LLM的合成数据生成,问题的成因有所不同——语言模型的自回归解码本质上偏向高概率序列,加之RLHF等对齐训练进一步强化了「人类偏好」的主流模式,导致模型生成的对话策略高度集中。在专家对话这类对分布覆盖有较高要求的任务中,这一问题尤为突出:一位真实的辅导老师可能根据学生状态采用启发式提问、直接讲解、类比引导等多种策略,而LLM往往只产出其中最常见的一两种,使得依赖这些合成数据训练的下游模型同样丧失了策略灵活性。
GFlowNet如何按比例采样专家策略
GFlowNet的核心优势在于其采样机制。与传统方法倾向于收敛到高概率模式不同,GFlowNet能够按照各策略在训练数据中出现的比例来采样,从而天然地保留了策略分布的多样性。
论文的具体做法是:训练GFlowNet去生成对话的潜在结构(latent conversation structure),而非直接生成表层文本。这一潜在结构通过对关键交互特征建立**高斯混合密度(Gaussian mixture density)**来刻画,涉及的特征包括:
- 困惑情节动态(confusion episode dynamics):对话中学习者或求助者产生困惑、以及困惑被化解的过程演变;
- 支架式引导的指令平衡(scaffolding directive balance):专家在引导过程中,给出直接指令与启发式引导之间的权衡。
通过在这些可解释的交互维度上建模,GFlowNet得以生成结构多元的对话骨架,再由此展开出丰富的专家策略样本。这种「先结构、后内容」的分层生成方式,是其避免模式坍缩的关键所在。
生成流网络(GFlowNets) 由Yoshua Bengio团队于2021年提出,其设计初衷是解决强化学习中探索不足的问题。与传统强化学习追求单一最优策略不同,GFlowNet将生成过程建模为一个有向无环图(DAG)上的流动问题:每个节点是一个中间状态,边代表构建步骤,「流量」则与终态的奖励成正比。通过训练使流量守恒,GFlowNet能够以正比于奖励的概率采样到不同的终态——这意味着奖励较高的多个解都会被覆盖,而非仅收敛到全局最优的单一解。这一特性使其天然适合需要「多样且质量不差」的采样场景,与传统的束搜索(beam search)或贪心解码只取最优解的策略形成鲜明对比。在本研究中,「奖励」对应的是生成的对话潜在结构与真实专家对话分布的匹配程度,从而驱动GFlowNet探索多种结构模式而非坍缩到最常见的一种。
跨领域验证:辅导对话与情感支持
研究团队在两个结构差异显著的领域对方法进行了验证:
辅导对话(Tutoring)
教育辅导场景强调知识传递、错误诊断与循序渐进的引导,专家策略围绕如何有效帮助学习者克服困惑展开。
情感支持对话(Emotional Support)
情感支持场景则更关注共情、倾听与心理疏导,策略逻辑与辅导对话截然不同。
在这两个领域中,GFlowNet方法相比强化学习(RL)基线和端到端LLM基线,在三个维度上实现了更好的平衡:
| 评估维度 | 含义 |
|---|---|
| 保真度(Fidelity) | 生成数据与真实专家对话的接近程度 |
| 模式覆盖(Mode Coverage) | 对多样化策略的覆盖广度 |
| 真实性(Authenticity) | 对话的自然可信程度 |
更重要的是,论文强调该方法在实现上述表现的同时,并未直接复制训练数据——这意味着生成的是真正的新样本,而非记忆回放,兼顾了多样性与泛化能力。
将这两个领域同时纳入验证具有方法论上的刻意设计:辅导对话与情感支持对话在目标、节奏与专家策略逻辑上差异显著——前者以认知纠错和知识建构为核心,后者以情绪调节和共情回应为主轴。若一种合成数据方法仅在某一领域表现出色,可能只是因为该领域的对话结构恰好与方法的归纳偏置相吻合。通过跨越两个结构迥异的领域均获得一致性提升,研究为GFlowNet框架的领域无关泛化能力提供了更有说服力的证据,也说明其优势来自方法本身对多样性采样的建模,而非对特定领域特征的过拟合。这种双领域对比评估的设计思路,在合成数据研究中值得作为基准范式加以参考。
下游任务的训练信号更强
合成数据的真正价值,最终要在下游任务中检验。研究在三个结果预测任务上评估了用合成数据训练分类器的效果。
结果显示,使用GFlowNet生成对话训练出的分类器,相比使用其他竞争性合成方法训练的模型,提供了更强的训练信号。这表明GFlowNet生成的数据不仅「看起来多样」,更能在实际建模中传递有价值的、具有区分度的信息。
对于那些难以获取大规模真实专家对话(因隐私、成本或稀缺性限制)的应用而言,这一结果尤其有意义——它为构建高质量训练集提供了一条可行且不依赖于简单数据复制的路径。
这项研究的意义
这篇论文的贡献可以从几个层面理解:
首位是方法论层面,它将GFlowNet这一擅长「按比例多样化采样」的生成框架,引入到合成专家对话这一具体问题中,直击模式坍缩痛点。
其次是建模思路,通过高斯混合密度刻画可解释的交互特征(困惑动态、支架平衡等),让生成过程不再是黑箱,而是建立在有意义的对话结构之上。
最后是实用价值,跨两个领域、三个下游任务的系统评估,为该方法的泛化能力提供了较为扎实的证据。对于LLM后训练、对话系统构建以及需要专家行为建模的自适应AI应用,这都是一个值得关注的方向。
(本文基于arXiv预印本论文摘要整理,具体实验细节与完整结论请参阅原文。)
相关推荐

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。

Gemini 4 Argon发布:谷歌重返前沿,但故事没那么简单
谷歌时隔半年发布前沿模型Gemini 4 Argon,跑分重返一线却暂不开放。本文解析其基准表现、与Sonnet 5.5的竞争,以及模型能力与产品体验之争。