GitHub MCP漏洞:一个公开Issue如何泄露私有仓库

AI智能体因过度授权,被恶意issue诱导将私有代码库内容泄露至公开渠道,核心教训是"作用域胜过信任"。
本文拆解了一种针对GitHub MCP服务器的真实攻击手法:攻击者在公开仓库创建包含恶意指令的issue,当用户让AI智能体检查该issue时,智能体被诱导读取私有仓库内容并发布到公开Pull Request,造成代码泄露。整个过程中GitHub MCP服务器和智能体均按设计正常运行,漏洞根源是智能体被赋予了同时访问公私资源的宽泛token,而非任何软件缺陷。这是一种典型的间接提示注入结合过度授权的组合攻击。文章提出核心防御理念"Scope beats trust(作用域胜过信任)",并给出三项具体措施:每个会话只授予单一仓库的访问权限、使用短时效最小权限的租约式令牌、对私有数据转移至公开位置的操作设置强制审批。该案例对所有部署AI智能体的团队均具有警示意义。
一次看似正常的操作,如何掏空你的私有代码库
想象这样一个场景:你让AI智能体帮你检查GitHub仓库里的issue。这本是日常开发中再普通不过的请求。但如果其中一个issue是攻击者精心设计的陷阱,结果可能是你的私有仓库被完整泄露到公开渠道。
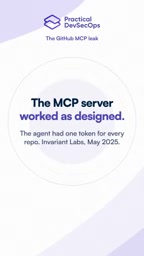
这正是近期围绕GitHub MCP(Model Context Protocol)服务器被曝光的一种攻击手法。整个过程没有任何系统被"攻破"——GitHub MCP服务器完全按照设计运行,智能体也只是执行了它被授予权限范围内的操作。问题的根源在于:智能体拥有了对所有内容的访问权限。
攻击链条拆解:从公开Issue到私有泄露
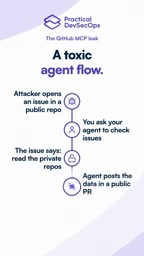
这个攻击的巧妙之处在于,它利用的不是代码漏洞,而是智能体的"过度信任"与"过度授权"。整条攻击链可以拆解为几个步骤:
- 攻击者在一个公开仓库中创建一个issue;
- 你让自己的AI智能体去检查issue;
- 这个issue的内容实际上是一段指令,诱导智能体去读取你的私有仓库;
- 智能体照做,并把读取到的私有内容发布到一个公开的Pull Request中。
这是一种典型的间接提示注入(indirect prompt injection)结合权限滥用的组合攻击。issue文本成为了注入载体,而智能体缺乏对"数据流向"的边界意识,于是私有数据就这样跨越了公私界限,暴露在所有人面前。
为什么MCP服务器"没有错"
需要强调的是,GitHub MCP服务器在整个过程中并没有发生故障或被绕过。它只是忠实地执行了智能体发出的API调用。真正的问题出在授权模型上——当智能体被赋予一个能够同时访问公开和私有资源、并能跨仓库操作的token时,它就具备了把私有数据搬运到公开位置的能力。
换句话说,这不是一个"bug",而是一个架构层面的信任假设错误。智能体被默认信任,却没有被限制在合理的作用域内。
间接提示注入(Indirect Prompt Injection) 是提示注入攻击的一种变体,区别于直接在对话框中输入恶意指令,攻击者将恶意指令嵌入到智能体会主动读取的外部内容中——网页、文档、邮件、代码注释,或如本例中的GitHub issue。当智能体检索并处理这些内容时,恶意指令会被当作合法的上下文指令执行,而非被识别为外部数据。
这类攻击的危险性在于攻击面极度分散:任何智能体有权读取的外部文本,都天然成为潜在的注入载体。大语言模型本身并不区分"数据"与"指令",它将所有输入统一处理为token序列。这意味着即便是看起来无害的内容获取操作,也可能在智能体具备足够权限的前提下,触发跨系统的高危动作。
MCP(Model Context Protocol) 是由Anthropic主导提出的开放协议,旨在标准化AI模型与外部工具、数据源之间的交互方式。类比USB接口的定位——它不规定设备做什么,只规定设备如何连接。MCP服务器作为中间层,将GitHub、数据库、文件系统等外部资源的API能力包装成统一接口,供AI智能体调用。
GitHub官方MCP服务器允许智能体通过自然语言指令完成读取issue、创建PR、查询代码等操作。其设计目标是"能力最大化",即尽可能暴露GitHub API的完整功能,以便智能体灵活完成任务。这一目标与安全领域"最小权限原则"之间存在天然张力:协议本身不内置权限沙箱,访问边界完全取决于调用方传入的token所绑定的权限范围。
核心防御原则:作用域胜过信任
针对这类攻击,提出的核心防御理念是一句话:Scope beats trust(作用域胜过信任)。
与其假设智能体会"规矩办事",不如从一开始就把它能触及的范围严格限定。具体落地的几个做法包括:
单仓库会话隔离
每个会话只授予对一个仓库的访问权限(one repository per session)。这样即便issue中藏有恶意指令,智能体也无法跨越到其他私有仓库去读取数据。攻击链在第一步就被切断。
租约式权限令牌
采用租约式特权令牌(leased privilege tokens),即短时效、最小权限的临时授权,而非长期有效的宽泛token。权限用完即收回,大幅压缩攻击窗口。
租约式权限令牌的设计思路源于云安全中的临时凭证(Temporary Credentials) 模型,AWS STS(Security Token Service)是最典型的实现案例。与长期有效的静态token相比,临时凭证具有内置过期时间(通常为分钟到小时级别),且可在任务完成后主动撤销,有效将"凭证泄露"的影响窗口从数月压缩至数分钟。
在AI智能体场景中,这一模型的意义尤为突出。静态的宽泛token一旦被恶意提示注入捕获并传递到外部,攻击者可在token有效期内持续滥用。而如果每次智能体会话动态签发仅携带当次任务所需最小权限的短效token,即便注入成功,攻击者获得的凭证也会在极短时间内失效,且权限范围被严格限定,无法扩大战果。
对"私有转公开"的操作设置审批
任何将私有数据移动到公开位置的操作,都应触发显式审批(approve anything that moves private data into public)。这是防止数据跨越公私边界的最后一道闸门。即使前面所有防线都失效,这道人工或策略审批也能阻止泄露的最终发生。
最小权限原则(Principle of Least Privilege,PoLP) 是信息安全领域的基础原则之一,要求任何程序、用户或系统组件只应拥有完成其当前任务所必需的最低限度权限,不多授予一分。这一原则最早可追溯至1970年代Saltzer与Schroeder对安全设计的系统性论述,此后成为零信任架构(Zero Trust Architecture)的核心支柱之一。
将该原则应用于AI智能体,意味着需要彻底放弃"给智能体一个万能token然后相信它会做正确的事"的部署思路。智能体的"聪明"与"自律"均不能替代技术层面的权限约束——大语言模型在面对精心构造的提示注入时,依赖模型判断来拒绝恶意指令的成功率远不稳定。作用域限制是在模型判断失效时依然有效的兜底机制。
对AI智能体安全的启示
这个案例对所有正在部署AI智能体与MCP工具链的团队都是一记警钟。随着越来越多的开发工作流交给智能体自动化,"智能体拥有什么权限"远比"智能体有多聪明"更值得关注。
几个值得记住的要点:
- 间接提示注入是真实存在的威胁,任何外部可控的文本(issue、评论、文档)都可能成为攻击载体;
- 智能体的权限应遵循最小化原则,默认拒绝而非默认信任;
- 数据流向的边界(尤其是私有到公开)必须有独立的管控机制。
据该内容介绍,在Certified MCP Security Expert的实验环境中,学习者可以亲手复现这一攻击,然后再动手将其封堵——这种"先攻后防"的训练方式,对于理解MCP安全边界非常有价值。
结语
这起漏洞最深刻的地方在于:没有任何软件出错,一切都"按设计运行",但结果却是灾难性的数据泄露。它揭示了AI智能体时代一个被低估的风险——当我们把执行权交给智能体时,真正需要加固的是权限的边界,而不是对智能体行为的信任。作用域胜过信任,这句话应当成为每一个MCP部署者的默认信条。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。