GitHub Octoverse 2026:AI代理工程驱动提交量爆发
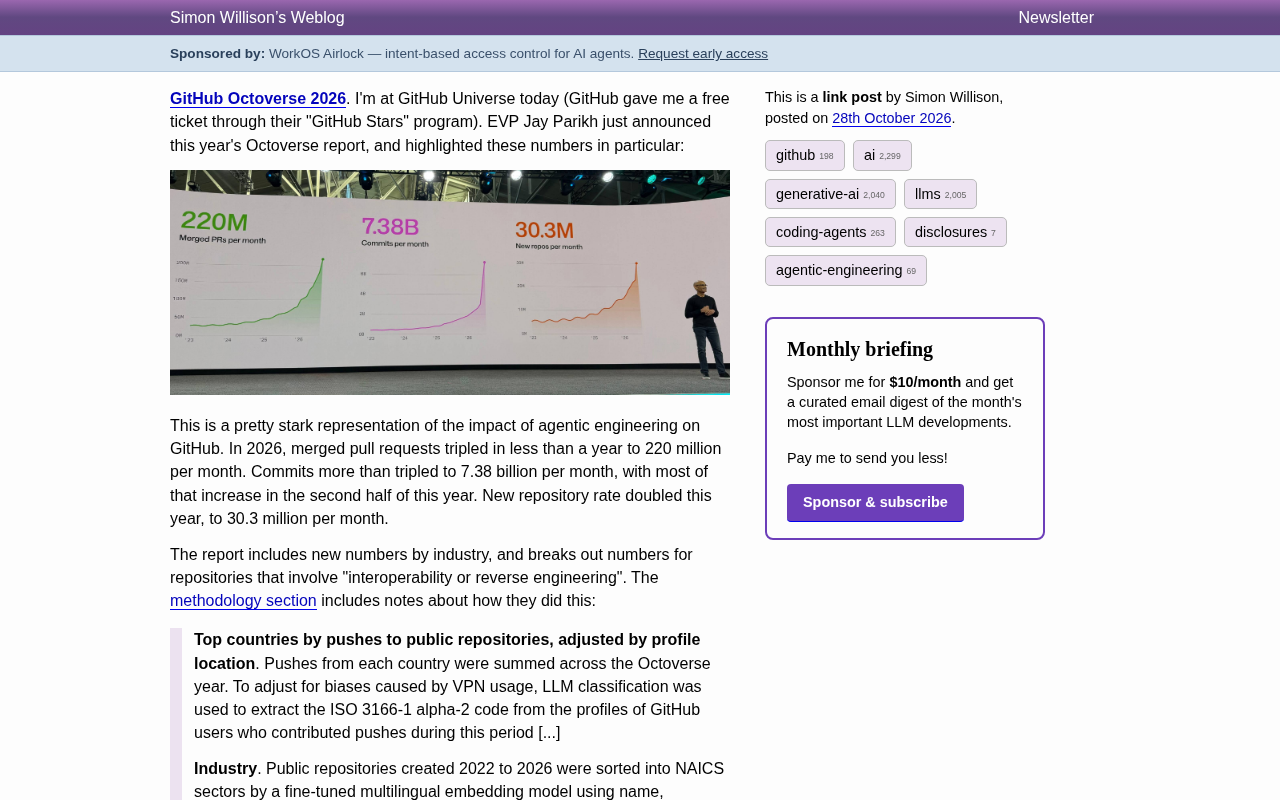
GitHub 2026 年三项核心指标齐创新高,AI 代理工程推动开发范式结构性转变。
GitHub Universe 大会公布的 2026 年 Octoverse 报告显示,平台月度合并 PR 达 2.2 亿、提交量 73.8 亿、新建仓库 3030 万,三项指标在 2026 年出现近乎垂直的飙升,合并 PR 与提交量不到一年增长至三倍。报告将此归因于 AI 编程代理大规模融入开发工作流,即「代理工程」的冲击。方法论上,GitHub 引入 LLM 分类校正国家数据偏差、以微调嵌入模型进行 NAICS 行业归类,并新增互操作性/逆向工程仓库统计。文章同时指出,提交量增长与代码质量的关联、分类模型的误判风险,以及开发者技能结构的迁移,仍是待解问题。
三大核心指标齐创新高,AI代理成关键推手
在今年的 GitHub Universe 大会上,GitHub EVP Jay Parikh 公布了 2026 年 Octoverse 报告的核心数据。三张并排的折线图直观地展示了平台活跃度的急剧攀升:月度合并 PR 达到 2.2 亿,月度提交量高达 73.8 亿,月度新建仓库数则为 3030 万。
这些数字的走势高度一致——在 2023 至 2025 年间保持相对平缓的增长,随后在 2026 年出现近乎垂直的飙升。据现场观察者、开发者社区知名人士 Simon Willison 在个人博客中的记录,这种增长态势「清晰地反映了代理工程(agentic engineering)对 GitHub 的冲击」。
具体来看,合并 PR 数量在不到一年内增长至原来的三倍,提交量的增长同样超过三倍,且大部分增量集中在下半年。新建仓库速率也在这一年翻番。这种同步爆发并非单一因素所致,而是 AI 编程代理大规模融入开发工作流的直接体现。
数据背后的方法论:LLM 辅助分类与行业拆解
Octoverse 报告今年引入了更细颗粒度的分析维度。在方法论部分,GitHub 披露了多项数据处理细节,这些调整本身也反映了平台数据规模的膨胀与复杂性提升。
在按国家统计公开仓库推送量时,团队使用了 LLM 分类模型从用户个人资料中提取 ISO 3166-1 alpha-2 国家代码,以校正 VPN 使用带来的偏差。行业维度的划分则依托一个经过微调的多语言嵌入模型,将 2022 至 2026 年创建的公开仓库按名称、描述、主题和 README 归类到 NAICS 部门,每年抽取随机样本进行分析。
另一个值得关注的维度是「互操作性或逆向工程」相关仓库的统计。GitHub 通过关键词匹配——包括 clean room implementation、drop-in replacement、协议重实现等——来识别这类项目。这一分类的出现,暗示了 AI 代理在代码生成之外,正被用于更复杂的系统级任务。
NAICS(北美行业分类系统) 是由美国、加拿大、墨西哥共同制定的标准行业分类体系,采用 2 至 6 位层级编码,从部门(如制造业、信息业)逐级细化到具体行业。GitHub 将公开仓库映射到 NAICS 部门层级,目的是在缺乏仓库级行业标签的情况下,获得可与官方经济统计对照的粗粒度行业分布。需要注意的是,这种基于仓库名称、描述、主题和 README 的文本归类本质上是一种弱监督推断,同一仓库可能横跨多个部门,且开源项目的用途与其维护者所属行业并不等同,因此该维度的结论更适合观察趋势而非精确计量。
代理工程的真实影响:从数字到开发范式的迁移
三倍级的增长曲线背后,是开发范式的结构性转变。传统上,PR 和提交量的增长与开发者人数、项目复杂度呈近似线性关系。但 2026 年的数据表明,这一相关性正在被打破。
AI 代理可以自主完成从代码生成、测试到提交 PR 的完整闭环,单个开发者的产出上限被显著抬高。提交量在下半年出现的集中爆发,与主流 AI 编程工具的能力迭代周期高度吻合。当代理能够可靠地处理多步骤任务时,开发者更倾向于将重复性、模式化的工作委托出去,从而在相同时间内产生更多可合并的变更。
新建仓库数量的翻番则指向另一个现象:试错成本大幅降低。开发者可以更轻松地启动实验性项目,因为 AI 代理能够承担初始脚手架搭建和基础代码填充的工作。这种「低摩擦启动」模式可能正在改变开源项目的生命周期——从构思到可运行原型的路径被大幅缩短。
代理工程(agentic engineering) 是相对于传统「AI 辅助编程」而言的范式升级。在辅助模式下,LLM 以代码补全、单函数生成的形式介入,人类开发者仍是任务分解与流程控制的主体;而代理工程强调由具备规划、工具调用与自我纠错能力的 AI 代理自主完成从需求理解到代码提交的多步骤闭环。其技术基础通常包括 ReAct 式推理-行动循环、函数调用或 MCP 等工具接口、沙箱化执行环境以及基于测试反馈的迭代机制。这一模式将开发者的角色从「逐行编写」推向「任务定义与结果验收」,也是理解 2026 年 GitHub 提交量与 PR 量非线性增长的关键背景。
数据解读的边界与待解问题
尽管增长数据令人瞩目,但几个关键问题仍有待回答。首先,代理生成的大量提交是否带来了同等比例的实质价值?合并 PR 的数量增长并不直接等同于代码质量的提升,评审负担可能也随之加重。
其次,行业分类和互操作性仓库的统计方法本身依赖 AI 模型,存在误分类风险。GitHub 在方法论中坦诚了局限性,但未提供误差范围的量化估计。对于希望基于 Octoverse 数据做决策的团队而言,理解这些统计口径的边界至关重要。
最后,代理工程对开发者技能结构的影响尚未在报告中体现。当编码的机械性成分被代理吸收后,人类开发者的核心价值将更多转向系统设计、需求拆解和结果验证——这一转变的速度和深度,可能比提交量的数字更能定义 next 阶段的开发生态。
ISO 3166-1 alpha-2 是国际标准化组织定义的两位字母国家/地区代码(如 US、CN、DE),被广泛用于地理标识。GitHub 此前按用户自填的所在地统计推送量,但 VPN 与代理工具会使大量流量呈现为来自少数网络出口国家,造成地理分布失真。改用 LLM 从个人资料文本中推断国家代码,相当于用语义线索替代单一字段,能部分缓解这一问题;但其准确性依赖资料完整度与模型判断,对资料缺失或刻意模糊的用户仍存在系统偏差,这也是报告未量化误差的原因之一。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
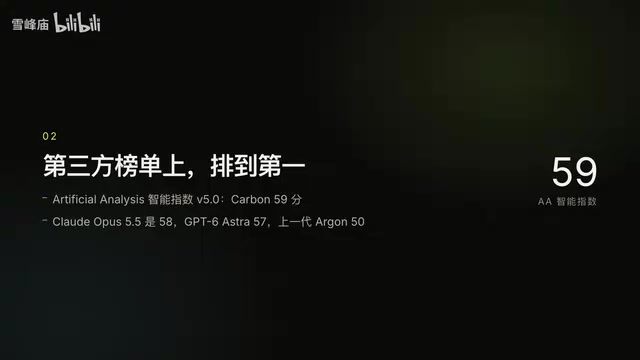
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。