GitHub单月74亿次提交:4M CPU核心与160PB存储扩容背后
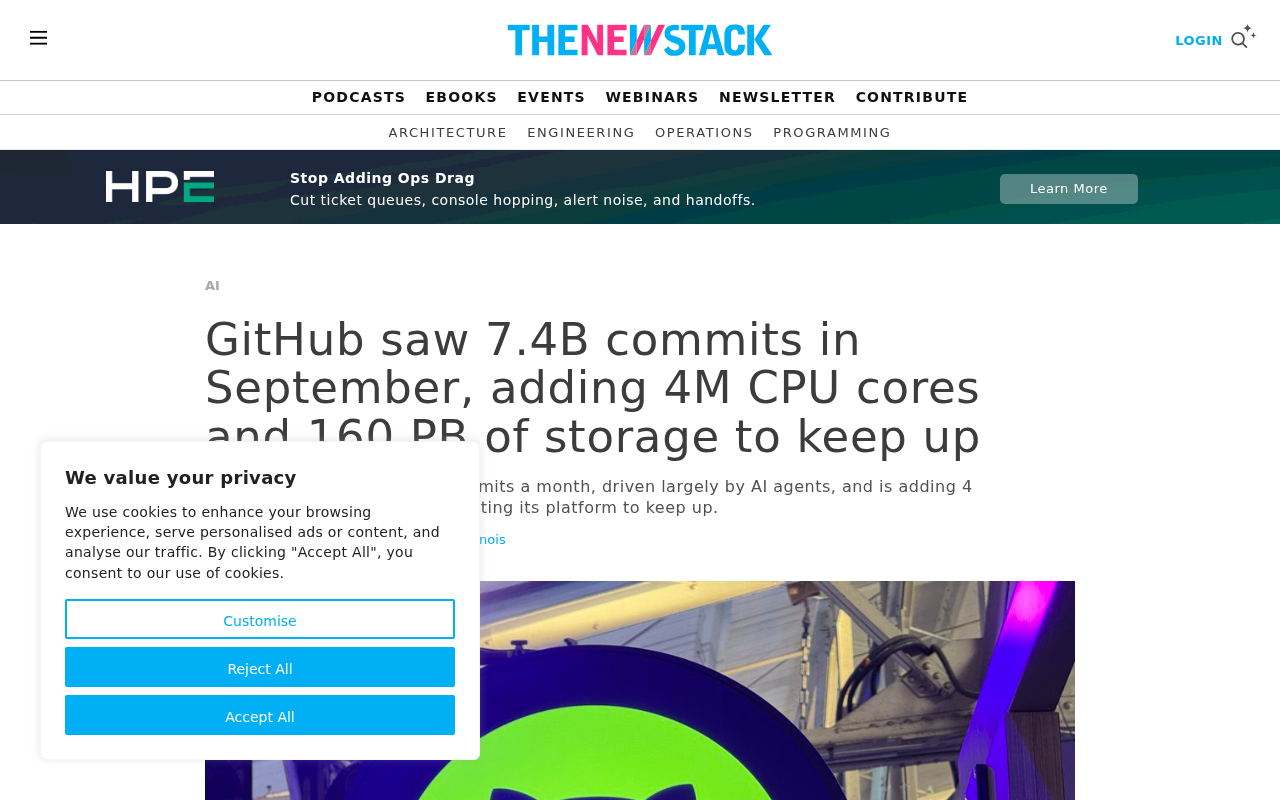
GitHub 单月 74 亿次提交,促使平台新增 400 万 CPU 核心与 160 PB 存储。
文章以 GitHub 9 月 7.4B(74 亿)次提交、新增 4M CPU 核心和 160 PB 存储这组数据为骨架,分析代码托管平台进入基础设施级扩容阶段的信号。作者指出,提交在平台层面不是轻量操作,而是持续高频的写入流,需要记录、索引、关联作者与分支,并支撑 diff、搜索与 CI 触发。CPU 与存储同时扩容,说明瓶颈同时出现在任务调度与数据承载两侧;代码托管数据几乎只增不减,提交历史构成长期存储成本。由于素材仅有标题级信息,缺少增速、周期与成本细节,文章强调结论应保持方向性,不宜推导精确的投入产出比。
一次提交量引发的平台扩容
GitHub 在 9 月记录了 7.4B(74 亿)次提交,并为此新增了 4M(400 万)个 CPU 核心和 160 PB 存储来跟上负载。据 Hacker News 上的讨论帖,这条消息的核心信息很直接:代码托管平台的规模已经进入一个需要“基础设施级别扩容”才能消化的阶段。
这个数字之所以值得关注,不是因为 GitHub 又破了一个纪录,而是它把“开发者行为”与“平台工程能力”绑在了一起。当单月提交量达到数十亿量级,提交本身就不再是简单的版本记录动作,而是一次对存储、计算调度和查询系统的持续压力测试。本次讨论帖本身只有 12 个 points、0 条评论,属于信息密度不高但信号明确的素材,因此下文以原文给出的三项数据为骨架展开分析。
74 亿次提交意味着什么
提交不再是“轻量操作”
在个人仓库里,一次 commit 几乎无感。但在平台层面,每一次提交都要被记录、索引、关联到作者与分支,并支持后续的 diff、搜索、审查和 CI 触发。74 亿次提交/月的量级,意味着后台需要处理的是一个持续高频的写入流,任何环节的延迟都会在开发者侧被放大。原文给出的 4M CPU 核心和 160 PB 存储,本质上就是为这条写入流准备的算力与空间。
从系统角度看,一次 git push 并不只是写入几个文件。服务端需要完成对象接收与校验、引用(ref)更新、hook 触发、索引与搜索数据同步,还可能触发 CI 流水线;涉及分支保护、代码扫描时还要额外读取历史数据做比对。这些步骤共同构成一条写入后处理链路,单次成本不高,但乘以每月数十亿次就会形成持续的吞吐压力。峰值时段的突发写入尤其考验队列与限流设计,这也是平台扩容必须同时覆盖计算与存储两侧的原因。
扩容不是线性加法
说个细节,提交量增长带来的不只是存储占用,还有元数据、索引和查询压力。GitHub 同时增加 CPU 核心与存储,说明瓶颈同时出现在计算侧和存储侧:计算侧负责处理提交相关的任务调度,存储侧负责承载仓库数据与历史。原文没有给出具体的分项用途,但两项资源同时扩容,本身就说明这不是单一维度的扩容。
4M CPU 核心与 160 PB 存储的技术含义
CPU 核心:为高频任务调度买单
400 万 CPU 核心是一个平台级数字,它对应的不是某一种具体服务,而是整体任务处理能力。对于代码托管平台来说,提交、合并、代码扫描、CI 触发等动作都依赖计算资源。原文只给出了总量,没有拆分用途,因此更稳妥的解读是:这是为维持平台在提交高峰下正常运转而追加的整体算力储备。
要理解 400 万 CPU 核心的量级,可以借用云计算中 vCPU(虚拟 CPU)的概念:一个物理核心通常可通过超线程或虚拟化切分为多个 vCPU,云厂商按 vCPU 计费。400 万 vCPU 大致相当于数万台高密度服务器的算力总和,是大型云区域级别的资源池规模。对平台而言,这类资源通常以容器编排(如 Kubernetes)的方式池化管理,按任务队列动态分配,而非为每个服务固定绑定核心。这也解释了原文为何只给总量而不拆分用途——在弹性调度架构下,核心数是共享池的容量上限,具体归属随负载变化。
存储:历史数据是长期成本
160 PB 的存储增量,对应的是仓库数据与提交历史的持续累积。代码托管的一个特点是数据几乎只增不减,历史提交、分支和对象都需要保留。原文没有说明这 160 PB 是新增容量还是扩容后的总量,从表述看更接近新增容量。对平台而言,存储扩容不只是买硬盘,还涉及数据分布、复制和读写路径的调整。
Git 的存储模型有助于理解 160 PB 的含义。Git 把每次提交保存为不可变对象(commit、tree、blob),以内容哈希寻址,相同内容只存一份;打包(packfile)与增量压缩能显著降低冗余,但历史对象本身无法删除,否则会破坏仓库完整性。因此仓库越大、提交越频繁,对象库就越接近只增不减。160 PB 若按新增容量理解,相当于数十万块大容量硬盘的裸容量,实际还需考虑多副本或纠删码带来的冗余放大,以及冷热分层、跨区域复制等运维开销。
对开发者与平台的启示
平台工程能力成为隐形门槛
这条消息的价值在于它揭示了一个常被忽略的事实:代码托管平台的竞争力不仅在功能,还在能否消化规模。单月 74 亿次提交、4M CPU 核心、160 PB 存储,这三个数字放在一起,勾勒出的是一套需要持续投入的基础设施。对开发者来说,这些数字不直接改变日常操作,但决定了平台在高负载下是否稳定。
规模数据仍是单点信息
需要说明的是,本次素材只有标题和极简的讨论帖信息,原文没有提供同比增速、扩容周期或成本数据。因此对“7.4B 提交”与“4M CPU 核心、160 PB 存储”之间的关系,只能做方向性判断,不能推导出精确的投入产出比。后续若有更详细的官方说明,才适合进一步评估扩容效率。
常见问题
GitHub 9 月的提交量是多少? 原文给出的数字是 7.4B(74 亿)次提交。
GitHub 为此增加了多少资源? 原文提到新增 4M CPU 核心和 160 PB 存储。
这些数字说明什么? 说明平台需要同时扩充计算与存储能力来承接提交量,但原文未给出分项用途和成本细节。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
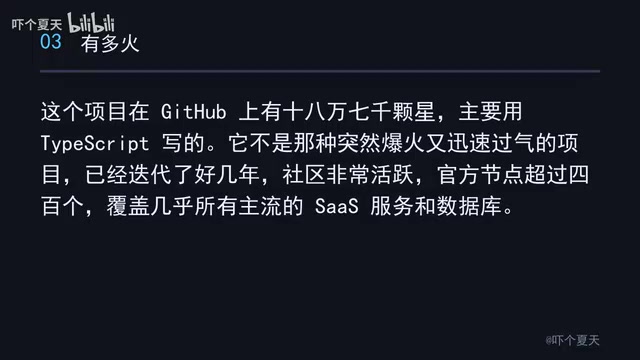
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
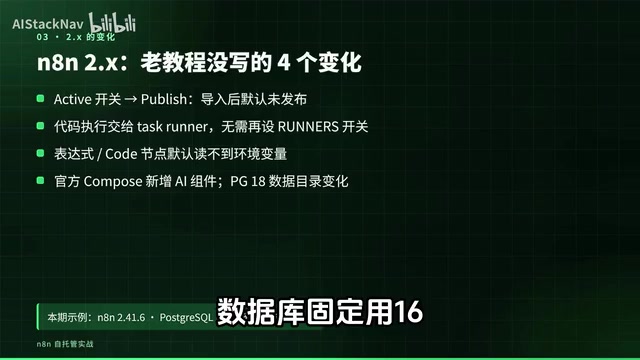
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。