GLM 5.2深度解析:开源编码模型跻身全球前三

智谱AI第五代模型:一次教科书级的开源发布
6月13日,智谱AI正式发布第五代大模型GLM 5.2,并采用MIT协议完全开源。发布当天,公司股价应声上涨约三成——这样的市场反应,本身就说明了这款模型分量不轻。
智谱AI成立于2019年,脱胎于清华大学知识工程实验室,是国内最早系统性研究大语言模型的机构之一。GLM(General Language Model)系列是其核心产品线,与GPT系列的单向自回归不同,GLM最初采用自回归填空的预训练框架,兼顾理解与生成能力。从GLM-130B到ChatGLM系列再到如今的GLM 5.2,智谱AI始终坚持开源路线,积累了大量开发者生态。第五代模型的发布,标志着其技术路线从"追赶"转向"局部超越"的关键节点。
与许多只在纸面上炫技的发布不同,GLM 5.2的核心卖点相当务实:顶级的编码能力、真正可用的百万Token超长上下文,以及开源免费可商用的授权模式。三点叠加,让它成为国产大模型中第一个在编码赛道上拉开代差的选手。
本文将从编码能力、上下文可靠性、技术架构和现实短板四个维度,拆解GLM 5.2到底强在哪里,又该如何理性看待它的局限。
编码能力:开源模型里的天花板
GLM 5.2最锋利的标签,是它的编码能力。在权威的Code V3评测中,它拿下96分、全球第三、S级评级。排在它前面的,只有GPT系列和Claude Opus两款——而这两款都是需要付费的闭源模型。
Code V3是目前业界公认的高难度代码能力基准之一,覆盖算法设计、Bug定位、代码补全、多语言适配等多个维度,题目持续更新以防止模型"刷题"。与早期的HumanEval、MBPP等基准相比,Code V3对模型的工程推理能力要求更高,刷榜难度更大。96分S级意味着模型不仅能解决标准算法题,还能处理贴近真实工程场景的复杂代码任务,这也是为何该成绩被视为代差级突破的核心依据。
换句话说,在所有开源模型里,GLM 5.2排名第一,也是国产模型中第一个能与国际顶级付费模型正面掰手腕的产品。
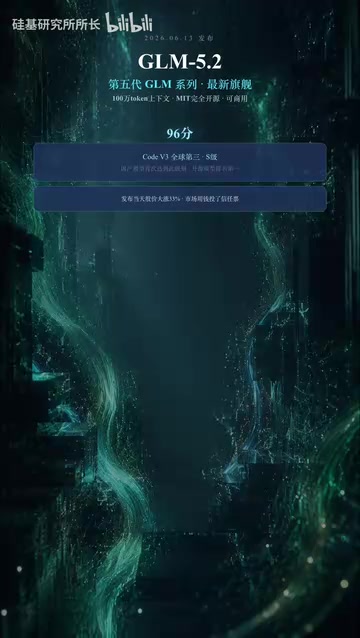
深层Bug实战:只差4分满分
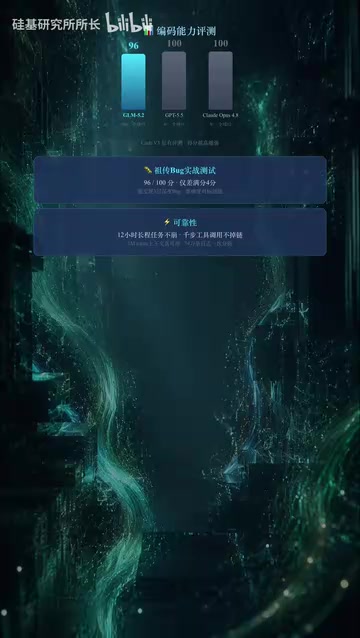
在专门挑战深层代码问题的Bug实战测试中,GLM 5.2同样拿到96分,距离满分仅差4分。这项测试的难点在于,它要求模型能够识别嵌套三层以上的深层Bug——这是很多模型容易"看不穿"的地方。
更直观的例子是复杂图形生成。面对一段900多行的纯前端代码,GLM 5.2一次性生成了包含5个同心圆和7颗齿轮的复杂图形,且不依赖任何外部库。这类任务对代码结构的严谨性和数学逻辑的准确性要求极高,一次成型意味着模型对整体架构有真正的掌控力。

长程任务不掉链子
最能体现工程实力的,是一个耗时约4小时、总量达17万Token的音乐项目。GLM 5.2从头写到尾全程未崩溃,期间调度29个智能体协同工作,千余次工具调用也没有断链。
"长程任务稳定性"恰恰是过去开源模型最容易翻车的环节。能扛住数小时的连续复杂任务,说明GLM 5.2已经具备了投入真实生产环境的可靠度。
百万Token上下文:真能用,不是虚标
很多模型标榜超长上下文,实际使用中却往往"读到后面忘了前面"。GLM 5.2的100万Token上下文,经实测是真实可用的。
百万Token上下文(约75万至100万个英文单词,或约150万汉字)的实现并非简单扩大窗口,背后涉及多项关键技术攻关。传统Transformer的注意力机制复杂度为O(n²),上下文翻倍会导致显存和计算量指数级上升。业界通常采用RoPE位置编码外推、YaRN/LongRoPE等位置插值技术、稀疏注意力(如FlashAttention)以及专项的长文本微调数据来解决这一问题。更难的是"Lost in the Middle"现象——模型倾向于记住开头和结尾而遗忘中间内容,GLM 5.2在多项超长文本测试中的表现,说明其针对中段信息遗忘问题做了专项优化。
具体表现包括:
- 整仓代码一次读懂:能一口气读完整个代码仓库,不会出现前后遗忘、跨章节信息割裂的问题。
- 超长对话不丢上下文:90多轮对话下来,前面的信息依然能被准确调用。
- 海量日志检索:面对74万条日志,能翻找出一个月前埋下的隐患。
- 合同交叉审阅:4份合同一并输入,条款间的真空地带一眼看出。
这些场景的共同点,是需要模型在超长文本中保持注意力与记忆连贯性。GLM 5.2在这方面的表现,让百万Token从营销数字变成了真正可依赖的能力。
技术架构:MoE设计与灵活的算力分配
从底层看,GLM 5.2采用了混合专家(MoE)架构。混合专家(Mixture of Experts,MoE)是近两年大模型扩展的主流架构之一,核心思想是将模型参数划分为多个"专家"子网络,每次推理时由门控机制(Gating Network)动态选择少量专家参与计算,而非激活全部参数。这一设计最早可追溯至1991年Jacobs等人的论文,被Mistral的Mixtral、Google的Gemini等顶级模型广泛采用。
GLM 5.2拥有744亿参数的总规模,但每次推理只激活其中约41亿参数——推理成本接近一个40亿量级的稠密模型,却保留了超大模型的知识容量与泛化能力,实现了"大脑大、激活小"的高效推理,在保证能力的同时有效控制了运行成本。
它还提供两档思考模式:
- Max档:面对复杂任务时开启,投入更多算力进行深度推理;
- Hi档:处理常规任务时使用,响应快速高效。
两档之间可以连贯切换,避免在简单任务上浪费资源。这种分级思考的设计,在成本与性能之间取得了不错的平衡。
定价方面,Pro套餐每月100元出头,比国外同类产品便宜数倍,属于典型的"甜点级"定价——性价比高到难以拒绝。
现实短板:速度慢、指令细节、无多模态
当然,GLM 5.2并非完美,短板同样清晰。
速度是最大软肋
完成同一任务时,GLM 5.2的速度比GPT系列慢好几倍。对于追求实时响应的场景,这个差距不容忽视。它用准确度换取了一部分速度,走的是"慢工出细活"的路线。
多步指令偶尔漏细节
处理多步骤复杂指令时,GLM 5.2偶尔会遗漏一些细节。这意味着在关键任务上,仍需要人工进行二次校验。
暂无多模态能力
目前GLM 5.2只处理文本和代码,尚不具备图像、音频等多模态理解能力。在多模态成为行业趋势的当下,这是一个明显的功能缺口。
结语:务实且靠谱的一次追赶
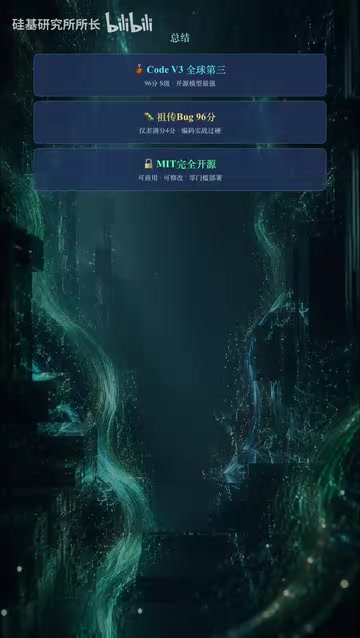
综合来看,GLM 5.2的成绩单相当扎实:
- Code V3全球第三,96分S级评级;
- 100万Token上下文真实可用;
- 长达数小时的长程任务稳定不掉链;
- MIT协议开源,可随意商用。
MIT协议是软件世界最宽松的开源许可证之一,允许任何人免费使用、复制、修改、合并、发布、分发、再授权,甚至用于商业产品,唯一要求是保留版权声明。相比之下,部分主流模型有商业用户限制或要求衍生品同样开源。GLM 5.2选择MIT协议,意味着企业可以直接将其集成进商业产品、私有化部署,无需向智谱AI支付授权费用,也不存在"用着用着被断供"的合规风险。这对于追求数据主权和供应链安全的国内企业尤其重要。
对开发者而言,GLM 5.2最大的意义在于"安全感"——免费、开源、可商用,不用担心哪天被禁或断供。这种确定性,往往比单纯的性能领先更能打动生产环境中的团队。
速度慢、无多模态确实是短板,但考虑到开源免费的定位,整体性价比依然极具竞争力。国产大模型这一波追赶,既有能力也有诚意,走得相当扎实。唯一的"甜蜜烦恼",大概就是发布之后算力和额度供不应求——好东西,人人都想抢。
核心要点
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。