GLM-5.3 在 8×MI355X 实现 469 tok/s:vLLM 与 TileRT 分离式推理解析

GLM-5.3在8块AMD MI355X上以分离式架构实现469 tok/s单用户解码,展示prefill/decode解耦的工程价值。
TileRT与AMD团队在8块MI355X加速卡上,借助vLLM推理框架和分离式部署架构,让GLM-5.3达到469 tok/s的单用户解码速度。技术核心在于将prefill与decode两个阶段解耦:vLLM负责计算密集的prefill,TileRT专门优化延迟敏感的decode,两者通过vLLM V1的connector接口衔接。单用户解码速度直接影响对话、Agent推理等交互场景的体验,优化难度远高于批量吞吐,这一成果也折射出大模型推理正朝着更精细分工、更开放生态演进的趋势。需要注意的是,数据来自单一来源,尚缺乏独立复现与完整测试细节,实际落地仍需结合具体场景评估。
一次刷新单用户解码速度的工程实践
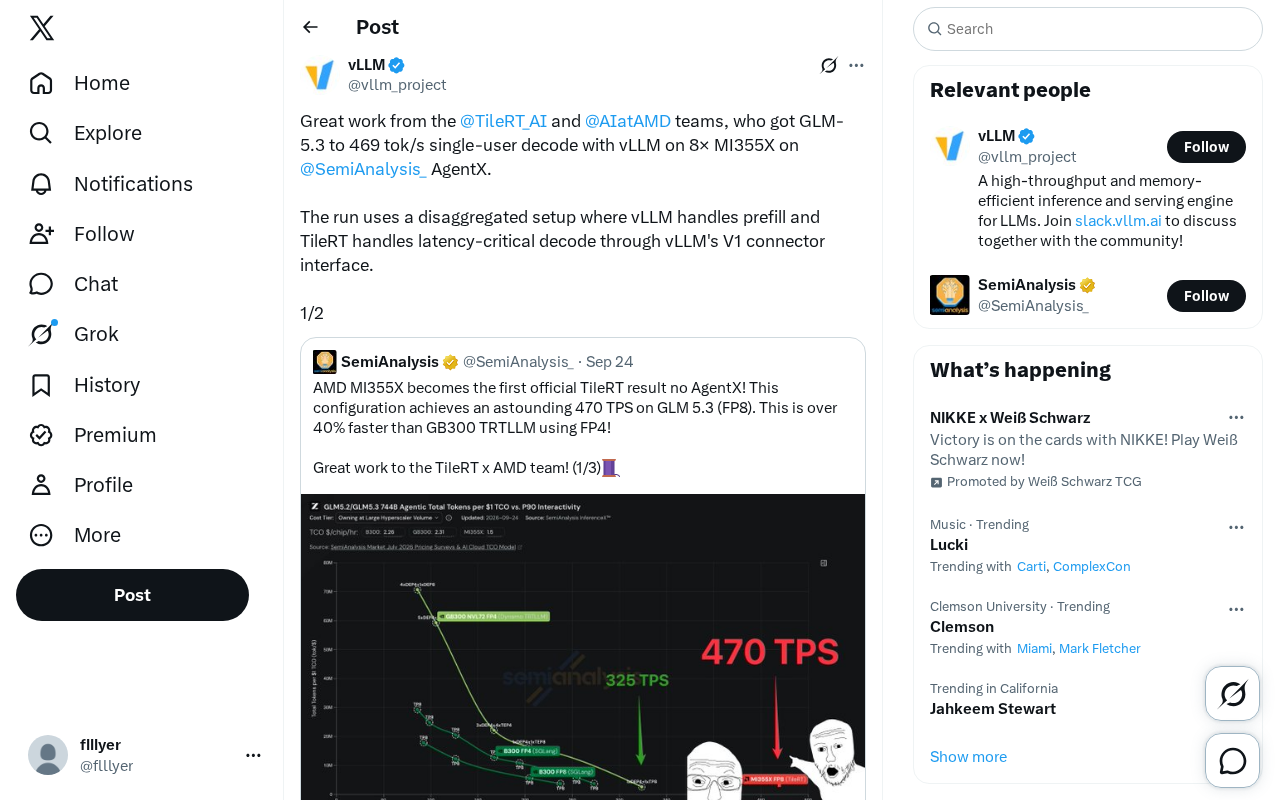
近日,TileRT(@TileRT_AI)与 AMD AI 团队(@AIatAMD)展示了一项值得关注的推理性能成果:在 8 块 AMD Instinct MI355X 加速卡上,借助 vLLM 推理框架,GLM-5.3 模型实现了 469 tok/s 的单用户解码速度(single-user decode)。该测试运行在 SemiAnalysis 的 AgentX 基准环境中。
这个数字之所以引人注意,关键在于它衡量的是「单用户解码」场景——即单个请求下每秒生成的 token 数量,而非通过大批量并发堆出来的吞吐总量。单用户延迟是衡量交互式应用(如对话、Agent 推理)实际体验的核心指标,优化难度也远高于批量吞吐。
分离式架构:prefill 与 decode 各司其职
这次成果的技术核心在于一套分离式(disaggregated)推理部署。根据官方说明,整个流程被拆分为两个阶段,分别由不同的组件处理:
- Prefill 阶段由 vLLM 负责。prefill 指模型对输入 prompt 的并行处理,属于计算密集型任务,vLLM 成熟的调度与批处理能力在这里能充分发挥。
- Decode 阶段由 TileRT 接管。decode 是逐 token 自回归生成的过程,对延迟高度敏感,TileRT 专门针对这一「延迟关键路径」做了优化。
两者之间通过 vLLM V1 的 connector 接口打通,让 TileRT 能够无缝衔接进 vLLM 的工作流。这种「让专业组件做专业事」的拆分思路,正是当前大模型推理优化的重要方向。
为什么要把 prefill 和 decode 分开
prefill 和 decode 在计算特征上存在本质差异。prefill 可以把整个输入序列一次性并行处理,GPU 算力利用率高;而 decode 每一步只生成一个 token,受限于显存带宽和内核启动开销,往往难以喂饱算力。将两者混在同一套调度里,容易相互拖累。
分离式部署让每个阶段都能在最适合的组件和配置下运行——prefill 追求计算吞吐,decode 追求低延迟,从而在整体上获得更优的端到端表现。这也是 469 tok/s 这一单用户解码数字能够达成的工程前提。
从系统层面理解这套架构,prefill 阶段本质上是一次大型矩阵乘法(输入长度越长,并行度越高),GPU 的计算单元(CUDA Core / Shader)可以被充分占满,属于 compute-bound 问题。而 decode 阶段每步只读取一次完整的 KV Cache 并写回极少量数据,瓶颈在于显存带宽而非算力,属于 memory-bound 问题。两种截然不同的瓶颈决定了最优的内核实现、调度粒度乃至硬件配置都不相同。传统单体推理服务为了兼容两种模式,往往不得不在两者之间做出妥协。分离式部署(Disaggregated Serving)将这两个阶段物理上拆开,分别交给为其量身定制的运行时处理,相当于在同一硬件集群内部实现了「流水线专业化」,从而让每个阶段都能跑在各自的最优点上。
硬件视角:MI355X 与开放推理生态
这次测试跑在 8 块 AMD MI355X 上,是 AMD 在高端 AI 加速硬件上持续发力的一个信号。长期以来,大模型推理的性能叙事多由单一厂商主导,而 AMD 联合 vLLM、TileRT 等开源与第三方工具链展示具有竞争力的推理数字,意味着推理部署的硬件选择正在变得更加多元。
vLLM 作为当下最主流的开源推理框架之一,其 V1 架构提供的 connector 接口为第三方优化方案(如 TileRT)留出了接入空间。这种开放的插件式设计,让生态中的不同团队可以在统一框架下叠加各自的优化,而不必各自重造轮子。
AMD Instinct MI355X 是 AMD 基于 CDNA 4 架构推出的数据中心 AI 加速卡,相较于前代 MI300X 在显存容量与显存带宽上均有提升,单卡配备 HBM3E 显存,整卡带宽突破 6 TB/s。对于 decode 阶段这类 memory-bound 工作负载,更高的带宽直接转化为更高的 token 生成速率。此外,MI355X 支持 FP8 精度推理,可在保持模型精度的同时进一步降低显存占用和带宽压力。AMD 的软件生态方面,ROCm 平台已具备与 CUDA 较为对齐的编程接口,vLLM 等主流框架对 ROCm 后端的支持也在持续完善,使得第三方优化组件(如 TileRT)能够在不大幅修改上层代码的前提下接入 AMD 硬件栈。
这组数字意味着什么
对关注大模型落地的开发者和工程团队而言,这则消息传递了几层信息:
- 单用户解码速度正成为推理优化的重要战场,直接关系到 Agent、实时对话等交互场景的可用性;
- 分离式推理架构(prefill/decode 解耦)在实践中展现出明确价值,值得在生产部署中评估;
- AMD 硬件 + 开源框架 + 专业优化组件的组合,为推理方案提供了更多可选路径。
需要说明的是,上述数据来自单一来源的公开展示,目前尚缺乏独立复现与完整的测试细节(如具体 batch 配置、量化方案、序列长度等)。读者在参考时应结合自身场景审慎评估,等待更多技术披露。
SemiAnalysis 的 AgentX 基准是一套专门面向 AI Agent 场景设计的推理评测体系,其核心关注点正是单用户(single-user)条件下的解码延迟,而非传统以最大吞吐量(throughput)为导向的批量测试。这一视角的转变反映了业界对推理评测标准的重新审视:在实际 Agent 工作流中,一条推理链往往需要模型在数百毫秒内完成一轮响应,低延迟比高吞吐更直接决定任务完成质量。469 tok/s 意味着生成 500 个 token 约耗时 1 秒出头,对于需要快速迭代思考步骤的 Agentic 任务而言,这一速度已具备较强的实用意义。
小结
GLM-5.3 在 8×MI355X 上跑出 469 tok/s 单用户解码,背后是 prefill 与 decode 分离、vLLM 与 TileRT 分工协作的工程设计。它既是一次具体的性能展示,也折射出大模型推理正朝着更精细的分工、更开放的生态演进。对于正在为高并发或低延迟推理头疼的团队,这套分离式思路或许是一个值得研究的参考样本。
相关推荐

问责机制也能充满乐趣:重塑自律与团队协作的新思路
问责机制常被视为压力与惩罚的代名词,但它其实可以充满乐趣。本文探讨如何通过同伴支持、进展可见化和庆祝小胜利,将问责重构为推动个人成长与团队协作的愉悦力量。

Claude Code 入门:读懂它是什么与多端用法
Anthropic 团队成员 Lydia 主讲的 Claude Code 入门分享:它不只是 CLI,而是可在终端、IDE、浏览器和桌面端运行的 AI Agent。本文梳理其本质定位、多端用法与学习路径。

OpenWiki 该不该收录 PRD 等叙事文档?取舍分析
在为项目构建 OpenWiki 时,是否该收录 PRD、设计、愿景等叙事文档?本文分析代码与叙事文档的本质差异、收录的收益与风险,并给出按成熟度筛选、标注时效、以代码为事实源等实用决策建议。