OpenWiki 该不该收录 PRD 等叙事文档?取舍分析

自动化代码知识库是否纳入PRD等叙事文档,关键在于筛选、标注与冲突处理,而非简单全收或全拒。
本文围绕一个实际工程决策展开:在构建自动化代码知识库(OpenWiki)时,是否应将PRD、设计文档等叙事型文档纳入索引。文章指出,代码提供精确的实现事实,叙事文档则补充设计意图与"为什么"的维度,二者天然互补。但叙事文档容易过时,与代码实现产生语义漂移,在RAG检索系统中会被LLM当作等权重事实处理,进而放大为具体的错误回答。文章建议采用分层策略:按成熟度筛选文档,标注来源与时效,以代码为事实基准,并通过纯代码版与含文档版的对照测试来验证实际效果,而非在理论层面争论。
问题背景
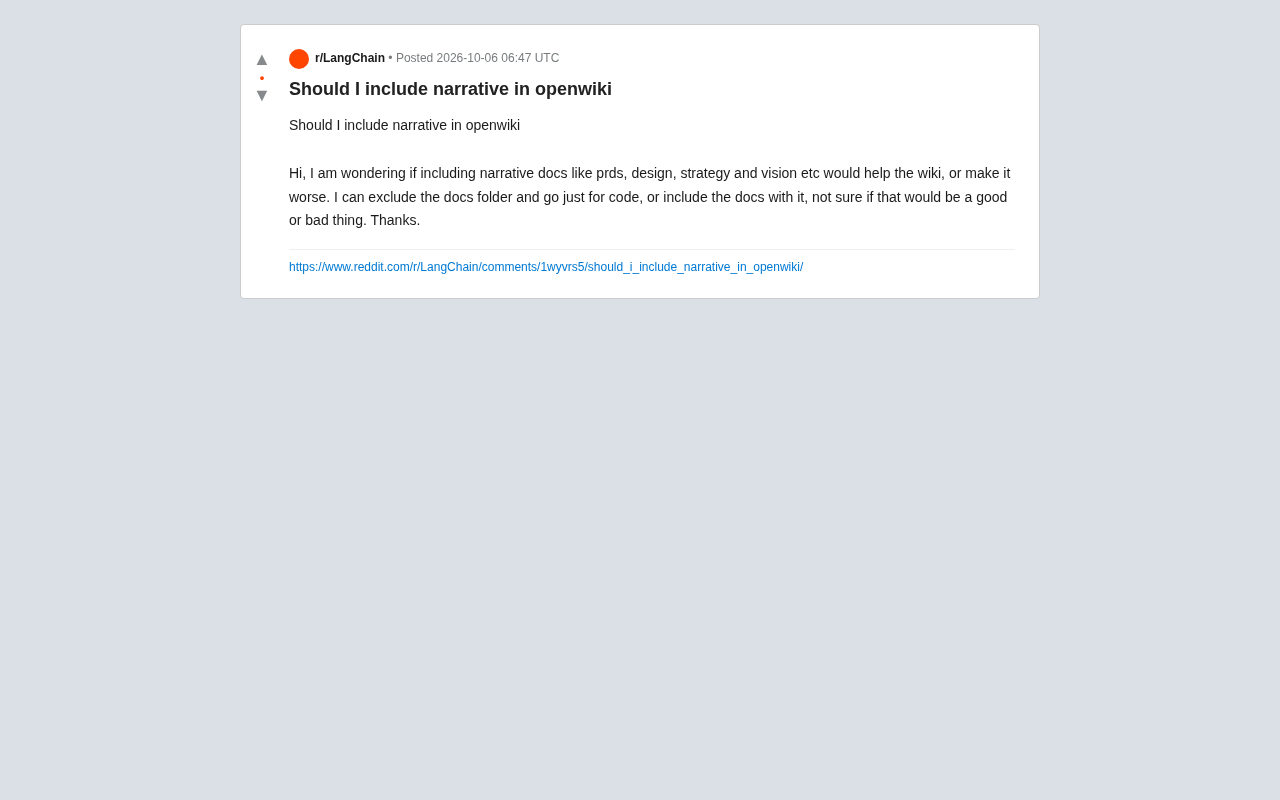
一位开发者在 Reddit 上提出了一个看似简单却颇具代表性的问题:在为项目构建 OpenWiki(自动化代码知识库/文档系统)时,是否应该把 PRD(产品需求文档)、设计文档、策略和愿景等“叙事型文档”一并纳入索引,还是只针对代码本身生成 wiki?
原帖的核心纠结在于:把 docs 文件夹排除掉、只喂代码,还是连同文档一起喂进去——这两种做法分别会让 wiki 变好还是变差?这其实触及了自动化文档工具的一个关键设计权衡:上下文的广度与噪声的平衡。
OpenWiki 类工具的核心机制通常是:通过静态分析或 LLM 对代码库进行扫描,自动提取函数签名、模块关系、注释等结构化信息,生成可检索的知识库。用户可以用自然语言向其提问,工具则通过向量检索(Embedding + 语义相似度)找到相关片段并生成回答。这种架构的检索质量高度依赖索引内容的一致性与准确性——如果索引中存在相互矛盾的信息,向量检索无法自动判断哪段内容更可信,最终会将两者都纳入生成上下文,导致回答混乱。这正是"把什么内容纳入索引"这一问题在 RAG(检索增强生成)场景下尤为关键的技术原因。
两类文档的本质差异
要回答这个问题,先要理解代码和叙事文档各自的性质。
代码:精确但缺乏意图
代码是对“系统如何工作”的精确描述。基于代码生成的 wiki 能够准确反映函数调用、模块依赖、数据结构等事实层面的信息。但代码本身往往无法回答“为什么这样设计”——意图、取舍和历史决策通常隐藏在代码之外。
叙事文档:富含意图但容易过时
PRD、设计文档、愿景这类叙事材料承载的正是代码缺失的那部分:产品目标、设计动机、战略方向。它们能让 wiki 的读者理解“为什么”,这对新成员上手或跨团队协作尤其有价值。
但叙事文档有一个天然短板——它们容易与实际代码脱节。一份半年前写的 PRD 可能描述了后来被砍掉的功能,一份设计文档可能记录的是已经被重构掉的架构。如果 wiki 把这些内容当作事实来呈现,就可能产生误导。
这种代码与文档之间的"语义漂移"(Semantic Drift)在软件工程中极为普遍。研究表明,文档的维护频率通常远低于代码变更频率,尤其是在迭代节奏较快的团队中。PRD 往往在功能立项时写就,之后随着开发中的方案调整,文档并不总能同步更新。在自动化 wiki 工具出现之前,这种漂移的影响相对有限——工程师会凭经验判断一份文档的时效性。但当文档被 LLM 当作等权重的"事实来源"处理时,其陈旧程度就会被放大成具体的错误回答,危害更为直接。
收录叙事文档的收益与风险
综合这个问题的本质,可以把取舍整理成清晰的两面。
潜在收益
- 补全“为什么”的维度:代码告诉你 how,叙事文档告诉你 why,二者结合能让知识库更完整。
- 提升检索召回:当用户用自然语言提问(如“我们为什么选择这个方案”),叙事文档往往是唯一能命中的内容源。
- 辅助新人理解全局:愿景和策略文档能帮助理解项目的整体方向,而不仅仅是局部实现。
潜在风险
- 信息陈旧带来误导:过时的 PRD 或设计稿可能让 wiki 给出与现状不符的答案。
- 引入噪声:草稿、头脑风暴、被否决的方案如果混入索引,会稀释高质量内容。
- 事实冲突:当文档描述与代码实现矛盾时,自动生成的 wiki 可能无法判断哪个才是真相。
实用的决策建议
与其在“全收”和“全不收”之间二选一,更稳妥的做法是分层处理。
按文档成熟度筛选
不要把整个 docs 文件夹一股脑纳入。优先收录那些相对稳定、已定稿的文档(如正式的架构设计、已发布功能的 PRD),排除明显的草稿、临时笔记和被废弃的方案。
标注来源与时效
如果 wiki 工具支持元数据,给叙事文档打上“文档类型”“最后更新时间”等标签。这样即便内容进入索引,读者也能自行判断其可信度,减少被过时信息误导的概率。
保持代码为“事实源”
在信息冲突时,应确立一个原则:代码是事实的最终来源,叙事文档是意图的补充。有些 wiki 工具允许为不同内容源设置权重,可以让代码类内容在检索中占据更高优先级。
小步验证
最低成本的做法是先生成两个版本——纯代码版和包含文档版,用几个典型问题分别测试检索质量,再根据实际效果决定是否保留文档。这比理论上的争论更有说服力。
结论
对于 OpenWiki 是否收录叙事文档,答案并非绝对的“是”或“否”。叙事文档能显著增强知识库对“为什么”的回答能力,但前提是做好筛选、标注和冲突处理。
建议的落地路径是:收录成熟定稿的叙事文档,排除草稿和废弃方案,以代码作为事实基准,并通过小规模对照测试来验证实际效果。这样既能享受叙事文档带来的上下文增益,又能把陈旧信息的风险控制在可接受的范围内。
背景补充
在 RAG 系统中,为不同来源的文档设置差异化权重,通常通过两种方式实现:一是在检索阶段调整各来源文档的分数权重(Reranking),让代码片段在候选列表中排名更靠前;二是在生成阶段通过 System Prompt 明确告知模型"若代码与文档描述冲突,以代码为准"。两种方式可以叠加使用。部分工具(如 Cursor、Mintlify 等)已开始支持按文件类型或目录配置索引优先级,对于尚不支持此功能的工具,可以在文档预处理阶段手动为叙事文档添加免责声明式的前缀标注,间接影响模型的信任倾向。
相关推荐

AI Agent上线一周被回滚:链式衰退如何毁掉自动化
一位开发者分享AI Agent上线一周即回滚的真实复盘:业务成功率链式衰退导致端到端成功率不足60%。本文剖析根因,并给出精简步骤、确定性收敛进代码、增加人工卡点三大优化方案。

AI数字员工系统拆解:Agent工作流真能平替基础岗位吗?
一篇关于AI数字员工系统与Agent自动工作流的深度拆解,分析智能体、数字人、短视频矩阵、智能获客与AI员工等功能的真实能力与风险,帮你理性看待"一键平替岗位"的营销话术。

钉钉官方开源CLI:用一个dws把企业协作变成AI可编程工作台
钉钉官方开源命令行工具 dws,用一个统一入口串起企业协作能力,并针对 AI Agent 做了结构化 JSON、字段投影、OAuth 安全等深度适配,让智能体直接操作真实业务,形成从读取到执行的完整闭环。