GLM-5.3模型跨请求KV缓存泄露引热议
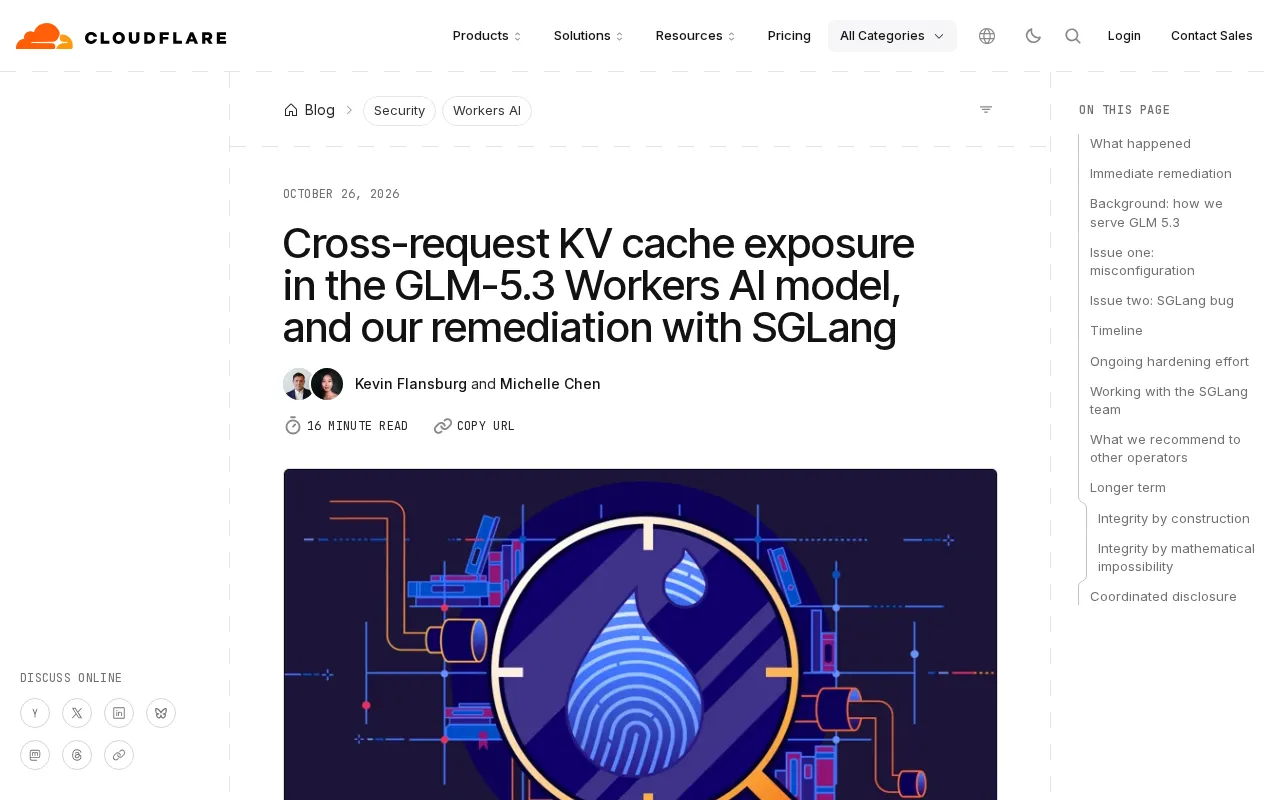
GLM-5.3被指存在跨请求KV缓存暴露,引发多租户推理服务隔离讨论。
文章围绕Hacker News上一则关于GLM-5.3 Workers AI模型“跨请求KV缓存暴露”的讨论展开。KV缓存是Transformer推理加速的关键机制,但在多租户、高并发的推理服务中,缓存复用和前缀共享等优化若缺乏严格隔离,可能导致用户上下文信息泄露。社区讨论焦点并未停留在漏洞利用,而是转向如何检测缓存混用、边缘推理平台缓存生命周期难以集中管控等工程实践问题。文章据此提出三条启示:缓存键应包含请求级唯一标识、多租户服务应默认开启缓存隔离审计、边缘场景需额外缓存治理策略,并强调该问题本质上是推理服务的工程实现缺陷而非模型本身的安全问题。
事件概述:GLM-5.3的KV缓存暴露问题浮出水面
近日,Hacker News上出现了一则关于GLM-5.3 Workers AI模型的讨论帖,标题直指“Cross-request KV cache exposure”(跨请求KV缓存暴露)。该帖获得了155条回复,但仅获得15个积分和5条评论,热度不算高,却触及了大模型推理服务中一个敏感的安全与隐私议题。
所谓KV缓存(Key-Value Cache),是Transformer架构模型在推理时用于加速生成的关键机制:通过缓存历史token的Key和Value张量,避免重复计算,显著降低延迟。然而,如果缓存未能在请求之间正确隔离,一个用户的上下文信息就可能泄露给另一个用户,形成跨请求的数据暴露。
这一帖子之所以值得关注,是因为它指向了AI基础设施层的一个共性风险——当模型被部署为多租户服务时,缓存的生命周期管理直接关系到用户数据安全。
技术背景:KV缓存为何成为风险点
在标准的大模型推理流程中,每个请求都会维护自己的KV缓存。理想情况下,请求结束后缓存应被释放或重置。但在高并发、低延迟的生产环境中,为了提升吞吐量,推理引擎常常采用缓存复用、前缀共享等优化策略。
据Hacker News上参与讨论的开发者分析,GLM-5.3在Workers AI模型服务中可能出现了缓存键(cache key)设计或请求隔离上的疏漏,导致不同请求之间共享了不应共享的缓存内容。虽然帖子本身没有披露具体的复现步骤或影响范围,但这一现象足以引发对推理服务安全边界的讨论。
有评论者指出,类似问题并非GLM-5.3独有,任何采用共享缓存池的推理框架都存在理论上的越界可能,关键在于实现层面是否做了严格的隔离校验。
前缀共享(Prefix Sharing)与缓存池是理解这一风险的关键机制。在推理服务中,多个请求若拥有相同的前缀(如相同的系统提示词),引擎可以让它们共享同一段KV缓存,从而避免重复计算这部分内容,显著提升GPU利用率。实现上通常依赖一个全局缓存池,以内容哈希或前缀指纹作为索引。风险在于:如果索引键的粒度过粗,或者缓存块在请求结束后未及时失效并被错误地分配给无关请求,那么后一个请求在解码时就可能读到前一个请求残留的Key/Value张量,导致上下文串味甚至信息泄露。这也是为什么业界强调缓存键必须绑定租户或请求身份,而不能仅凭内容相似性进行复用。
多租户(Multi-tenancy) 指同一套模型服务实例同时为多个互不信任的用户或组织提供推理能力。在这种模式下,隔离边界不仅包括网络和存储,还延伸到GPU显存中的中间状态,KV缓存正是其中最易被忽视的一环。传统安全模型往往假设显存内容会随进程结束而清空,但在共享缓存池的优化架构下,这一假设不再成立。
社区反应:关注点从漏洞转向工程实践
尽管帖子热度有限,但5条评论中透露出的关注点颇具代表性。部分讨论者更关心的是“如何检测”而非“如何利用”——即在实际部署中,如何通过日志、缓存指纹或请求追踪来发现跨请求的数据混用。
另一部分声音则指向了Workers AI这类边缘推理平台的特殊性。与传统数据中心不同,边缘环境下的请求调度更加动态,缓存的生命周期更难精确控制,这给隔离机制带来了额外挑战。据帖子中的分析,GLM-5.3作为较新的模型版本,其服务栈可能尚未针对这类边缘场景做充分打磨。
说个细节,讨论中并未出现对模型权重或训练数据层面的质疑,焦点始终停留在推理服务的缓存管理上,这也说明该问题更偏向工程实现而非模型本身的安全缺陷。
Workers AI 是 Cloudflare 推出的边缘推理平台,允许开发者在靠近用户的边缘节点上运行模型。其架构特点是请求调度高度分布式、实例生命周期短且动态伸缩,这使得缓存状态难以像集中式数据中心那样统一审计和强制清理。边缘节点上可能同时承载来自不同租户的请求,缓存复用的收益更大,但隔离校验的实现复杂度也更高,这正是讨论中反复提到的“边缘场景特殊性”所在。
对开发者的启示:缓存隔离应成为默认设计
从这一事件中,开发者可以提取出几条可操作的启示。
第一,缓存键的设计必须包含足够的请求身份信息。仅以提示词内容或会话ID作为键,在并发场景下容易发生碰撞,应引入请求级唯一标识并配合严格的失效策略。
第二,多租户推理服务应默认开启缓存隔离审计。无论是自建推理集群还是使用托管服务,都应在测试阶段模拟并发请求,验证不同请求之间的缓存不可见性。
第三,边缘推理场景需要额外的缓存治理策略。Workers AI这类平台的优势在于低延迟,但代价是缓存状态更难集中管理,开发者应关注平台方是否提供了缓存隔离的文档说明与配置选项。
小结
GLM-5.3的跨请求KV缓存暴露讨论虽然规模不大,却精准命中了AI推理服务中一个容易被忽视的角落。随着大模型越来越多地以API和边缘服务的形式交付,缓存隔离将不再只是性能优化问题,而是安全与合规的基础要求。对于使用Workers AI或类似平台的团队来说,主动核查缓存边界,比等待问题暴露更为明智。
相关推荐
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。