Google EmbeddingGemma 2:首个原生多模态端侧嵌入模型解析

谷歌发布740M参数的EmbeddingGemma 2,首个原生多模态端侧开源嵌入模型,支持五种模态共向量空间。
谷歌发布 EmbeddingGemma 2,这是一个740M参数的多模态嵌入模型,也是谷歌首个将文字、代码、图片、音频、视频统一映射到同一向量空间的端侧开源嵌入模型,采用 Apache 2.0 协议可直接商用。模型采用模块化设计,三类编码器可按需加载,纯文本仅需270M,全模态740M,在 Pixel 11 Pro 上量化后最低仅占约191MB内存,对端侧部署极为友好。性能上代码检索提升最明显,在1B以下多模态嵌入模型中综合表现最强。支持交错输入和 Matryoshka 维度缩减,但有两个需警惕的"静默失败"陷阱:截断后必须重做L2归一化,推理须使用BF16或FP32而非FP16。与 Gemma 3 共享流水线可实现离线本地 RAG,数据全程不出设备。
一个向量空间装下五种模态
谷歌发布了 EmbeddingGemma 2,这是一个总参数 740M 的嵌入模型,也是谷歌第一个原生多模态的端侧开源嵌入模型。它把文字、代码、图片、音频、视频统统映射进同一个向量空间,采用 Apache 2.0 协议,权重已经放到 Hugging Face 和 Kaggle 上,商用可以直接用。
前一代 EmbeddingGemma 的下载量超过 2000 万次,这次的升级把能力从纯文本扩展到了多模态,直接瞄准端侧场景——数据不出设备、全程离线运行的本地检索任务。
模块化设计:按需加载省内存
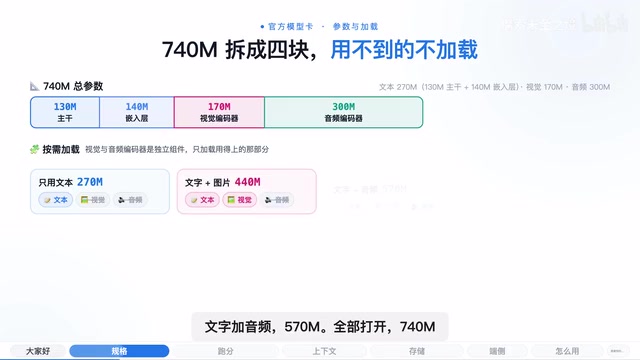
740M 的总参数并不是一块铁板,而是分成四部分:文本部分 270M(其中主干网络 130M、嵌入层 140M)、视觉编码器 170M、音频编码器 300M。关键在于这三类编码器可以按需加载。
只用文本就加载 270M,文字加图片 440M,文字加音频 570M,全部打开才是 740M。用不到的编码器不加载,内存就省下来了。这种模块化思路对端侧部署极为友好——绝大多数应用场景并不需要同时调用全部五种模态。
架构上它基于 Gemma 3(解码器架构),和 Gemma 3 共用文本分词器与音频编码器。上下文窗口达到 8K token,是上一代的 4 倍,输出向量维度为 768。
跑分表现:代码检索提升最明显
从各项基准来看,EmbeddingGemma 2 的进步并不均衡:
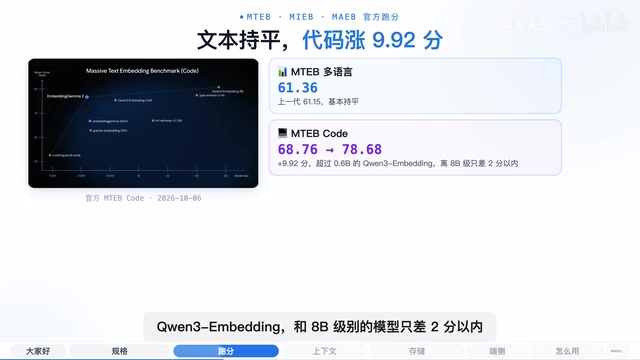
- 文本多语言 MTEB:61.36,上一代 61.15,基本持平;
- 代码检索 MTEB Code:从 68.68 涨到 70%,提升约 1.9 分,是进步最明显的一项。官方图表里这个分数超过了 0.6B 的 Qwen3 Embedding,与 8B 级别模型差距在 2 分以内;
- 图片 MIEB:64.64,比 Jina 的小模型高 4 分以上;
- 音频 MAEB:49.39,相对较弱,比 3B 到 7B 的专用模型低 4 到 6 分,但在 1B 以下属于最高一档。
官方的定位很清晰:在 1B 以下的多模态嵌入模型里它最强,也能超过一些参数量是它两倍以上的专用模型。
8K 窗口能装多少内容
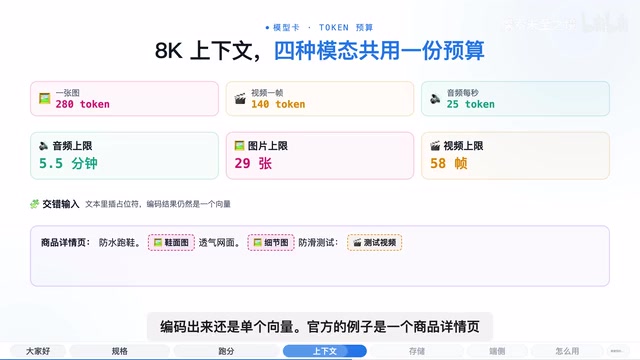
模型卡给出了固定的 token 消耗标准:一张图片 280 个 token,视频一帧 140 个,音频每秒 25 个。换算下来,单独使用时一个窗口最多能放 5.5 分钟音频、29 张图片或 58 帧视频。
要注意的是,所有模态共用同一个窗口,混着用就会互相挤占空间。
一个有意思的设计是交错输入:可以在文本里插入占位符来标记图片、视频、音频的位置,编码出来仍然是单个向量。官方举的例子是一个商品详情页,图片和视频插在文字中间,整个页面最后用一个向量表示,这样就能拿一句文字直接去搜索整个页面。
存储优化与两个必须注意的坑
存储方面用到了 Matryoshka(套娃)表示学习:768 维的输出可以砍到 512、256 或 128 维,向量库占用最多能降到六分之一。质量上,降到 256 维基本不损失;128 维损失较多,官方建议只用在纯文本场景。
模型卡专门写了两个容易踩的坑:
第一,截断之后必须重新做 L2 归一化。 直接截一段出来,向量长度就不再是 1,相似度排序会悄悄出错,而且不会报错。
第二,推理只能用 BF16 或 FP32,不要用 FP16。 模型激活值的范围超过了 FP16 的动态范围,结果要么是 NaN,要么质量明显下降,同样不报错。
这两个坑的共同点是「静默失败」——不报错但结果错,实际开发中尤其需要警惕。
Matryoshka 表示学习(Matryoshka Representation Learning,MRL)的名字来自俄罗斯套娃,核心思想是在训练时同时优化向量的多个前缀子集,使得向量的前 k 维本身就构成一个质量较高的低维嵌入。这与事后 PCA 降维不同——PCA 需要额外的主成分分析步骤,而 MRL 输出的向量天然支持截断。实际使用时,根据存储和检索延迟的约束选择合适的维度:768 维精度最高,256 维在大多数场景下与 768 维差距可忽略不计,128 维则因信息损失较大,官方建议仅用于文本场景。向量库的存储占用与维度成正比,从 768 降到 128 理论上可缩减 6 倍,对边缘设备的 Flash 存储和内存都有明显帮助。
端侧部署:和 Gemma 3 共享流水线
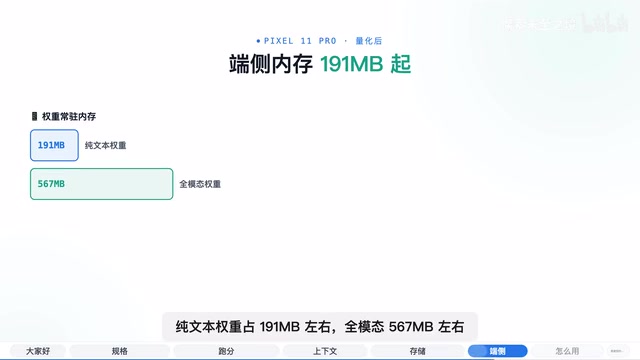
在 Pixel 11 Pro 上量化之后,纯文本全重占用约 191MB,全模态约 567MB。由于和 Gemma 3 共用分词器和音频编码器,两个模型可以放进同一条流水线,总内存比分开部署更低。
典型用法是本地 RAG:EmbeddingGemma 2 负责检索,Gemma 3 负责生成,整个过程离线,数据不出设备。谷歌在 AI Edge Gallery 里放了两个演示——一个用一句话或一张图在自己的媒体库里找语义最接近的内容,另一个用文字或一段录音定位视频里的具体片段。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将向量检索与语言模型生成结合的推理范式:先用嵌入模型把文档库离线编码成向量索引,查询时将问题同样编码成向量并做近似最近邻搜索,把检索到的相关段落拼入上下文,再交给生成模型回答。这种架构的好处是生成模型无需重新训练即可访问私有知识库,且检索结果可溯源。在端侧离线场景下,EmbeddingGemma 2 承担索引与检索,Gemma 3 承担生成,两者共享分词器和音频编码器意味着相关权重只需加载一份,合并部署比分别独立加载更节省内存,这对 RAM 通常只有 8-12GB 的移动设备尤为重要。
开发者生态
工具链已经比较完整:MediaPipe 有现成的嵌入和检索任务;浏览器里可以用 Transformers.js 加 WebGPU;本地部署支持 Ollama、llama.cpp、MLX 和 LM Studio;微调可以参考 Unsloth 的教程。
权重放在 Hugging Face 和 Kaggle,Apache 2.0 协议,商用无门槛。对于想在设备端做隐私优先的多模态检索的开发者来说,这是一个值得尝试的新选项。
相关推荐
用n8n搭建WhatsApp智能线索自动化:AI分级让商机不再流失
拆解一个基于n8n的WhatsApp线索自动化工作流:用AI把客户消息分为hot/warm/cold四级,自动应答并评分,仅在高价值线索出现时通知老板,帮助中小企业高效管理商机、节省人力。

Arabagent.ai:面向中东市场的托管式N8N自动化方案
Arabagent.ai 面向中东市场提供托管式 N8N 自动化服务,含私有工作空间、无限工作流执行、AI 自愈架构及阿拉伯语双语支持,兼顾开源可控性与 SaaS 便捷。

用 n8n 打造 Gmail→Google Sheets 自动化 CRM 实战教程
手把手教你用 n8n 搭建 Gmail 到 Google Sheets 的 AI 自动化 CRM:收到邮件自动触发,由 OpenAI 读取理解内容并提炼任务信息写入待办表格,含触发器、AI 智能体、提示词与 Sheets 工具的完整配置步骤。